

R&D LAB Methode Im Einsatz Für den eigenen Vertrieb gebaut
Event Scout
Agentische Pipeline für Präsenzveranstaltungen in der Region
Ein Sprachmodell liest die Veranstaltungsseiten, alles andere ist festes Programm. Übrig bleibt eine kurze Liste, wo sich ein Tag vor Ort lohnt.
- 5gewichtete Größen im Prioritätswert
- 3Entfernungsstufen um den Firmensitz
- 3Abfragebänder, gesteuert vom Ertrag je Quelle
- 0Datenbankserver: der Bestand ist eine JSON-Datei
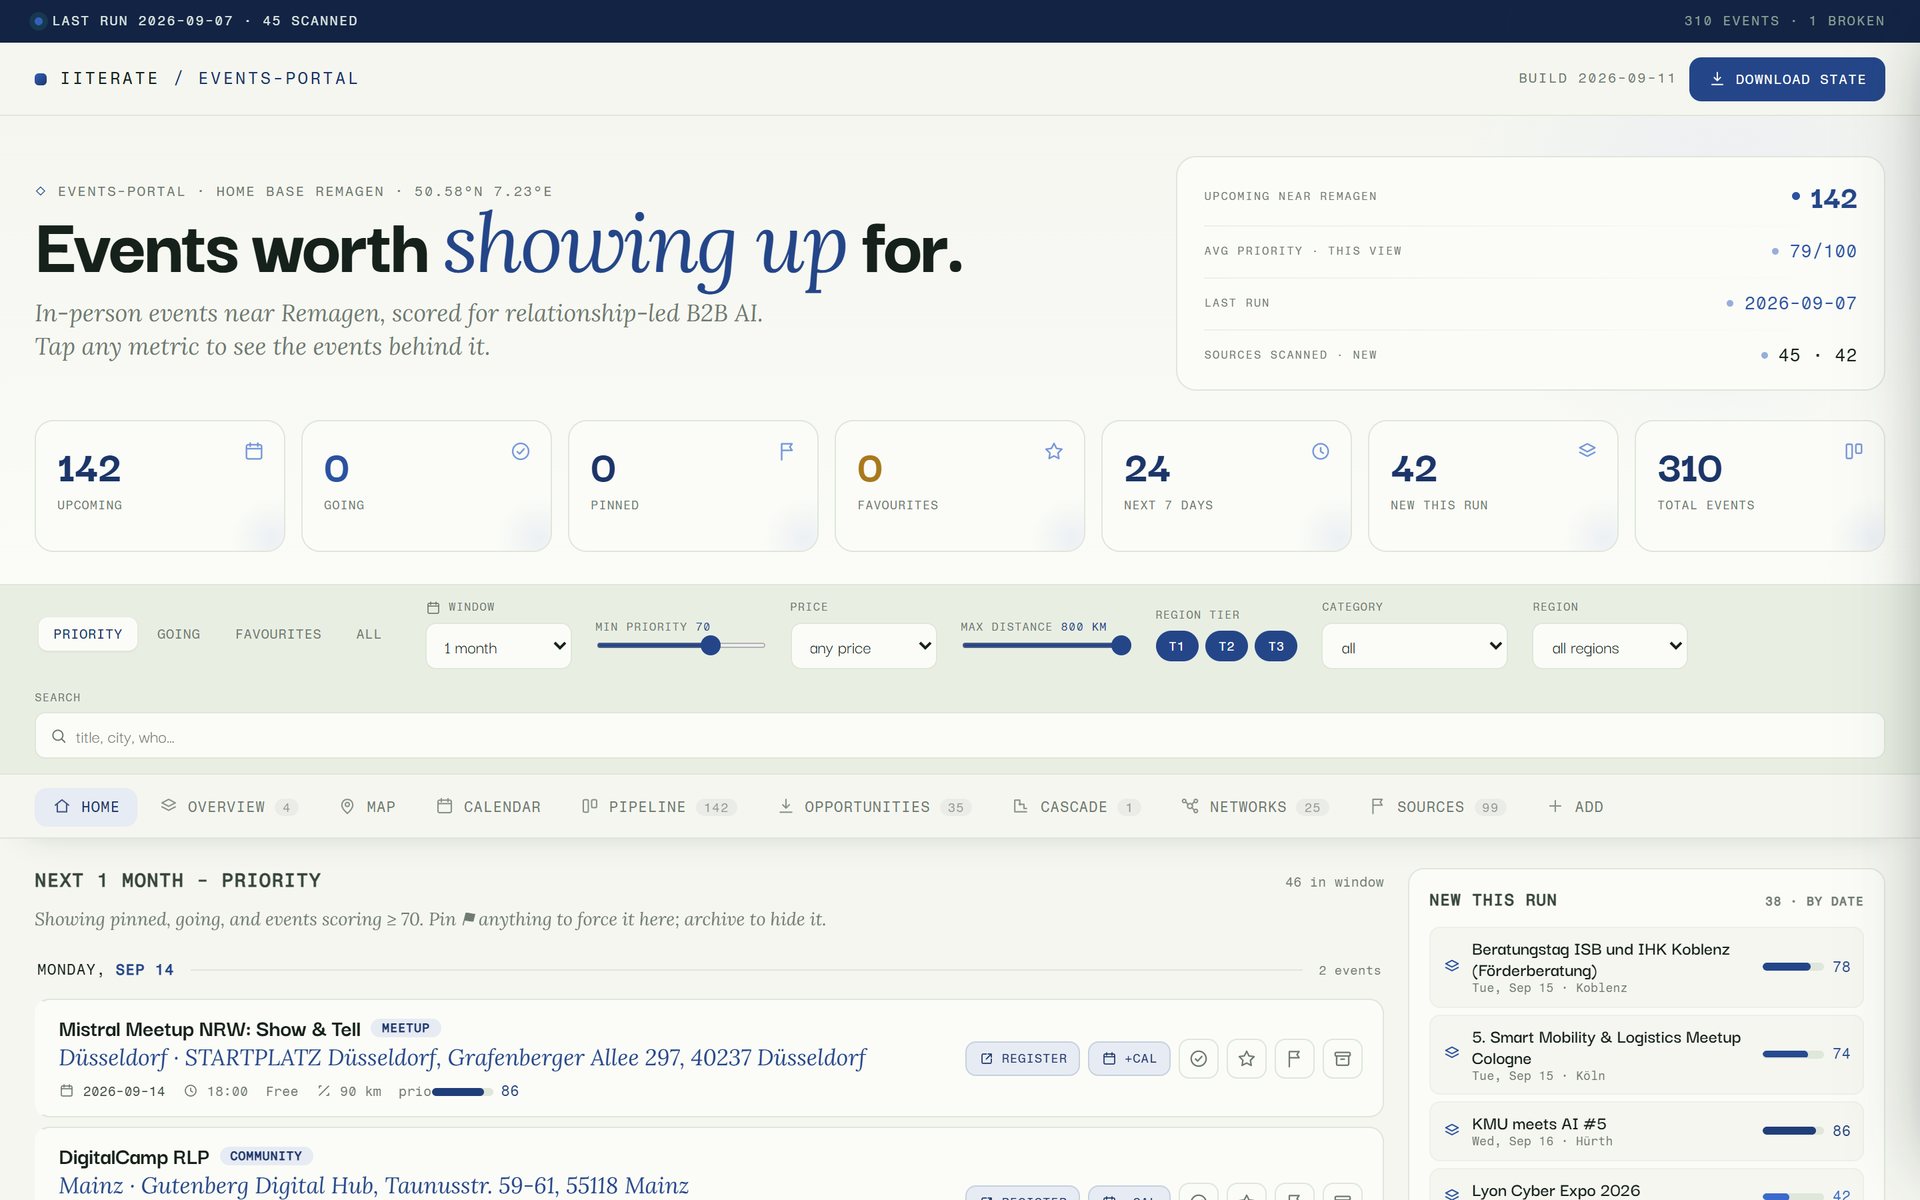
Startseite aus einer bereinigten Kopie des Bestands. Teilnahme und Favoriten stehen auf null, weil diese Vermerke vor der Aufnahme entfernt wurden.
Publikationsgrund
Wir verkaufen KI und Software. Event Scout ist der Beleg für die Frage, die bei jedem agentischen Vorhaben zuerst kommt: wie man ein Sprachmodell in einen Ablauf setzt, auf den man sich jede Woche verlassen kann. Die Antwort hier ist eine Aufteilung. Abrufen, Zeitplan, Entdoppeln, Aufräumen und Bewertungsformel sind festes Programm, das Modell übernimmt den einen Schritt, der Lesen verlangt, und eine Datei mit festem Schema ist der Vertrag zwischen beiden. Wer eine wiederkehrende Sichtung im eigenen Haus automatisieren will, sieht hier, wo wir diese Grenze ziehen.
Veranstaltungen, auf denen man Kunden tatsächlich trifft, stehen nicht an einem Ort. Sie verteilen sich auf Kalender von Kammern und Netzwerken, auf Newsletter, Meetup-Gruppen und Seiten von Hochschulen, jede mit eigenem Format, viele erst lesbar, nachdem ein Skript die Liste nachgeladen hat. Das jede Woche von Hand durchzusehen, ist genau die Art Aufgabe, die liegen bleibt. Event Scout ist die Pipeline, die sie für uns übernimmt: Sie führt eine kuratierte Datenbank solcher Quellen, ruft die fälligen in einem Stapellauf ab, lässt ein Sprachmodell daraus nur künftige Präsenzveranstaltungen in Reichweite des Firmensitzes herauslesen, bewertet sie für beziehungsgeführten B2B-Vertrieb, führt sie in einen einzigen Bestand zusammen und baut daraus ein eigenständiges Dashboard neu auf.
Die Entscheidung
Das Modell liest, das Programm führt den Bestand
Eine Veranstaltungsseite ist ein schlechtes Datenformat. Dieselbe Angabe steht einmal als Tabelle, einmal im Fließtext eines Newsletters, einmal in einem Kalender, der erst nach dem Scrollen nachlädt. Ein regulärer Ausdruck scheitert daran, ein Sprachmodell nicht. Genau dort, und nur dort, sitzt deshalb das Modell: Es liest die abgerufenen Seiten, entscheidet, was eine künftige Präsenzveranstaltung in Reichweite ist, und füllt für jede die Felder eines festen Schemas.
Alles davor und danach ist gewöhnliches Programm. Welche Quellen heute fällig sind, wie sie abgerufen werden, wann zwei Einträge dieselbe Veranstaltung sind, was nach einem Jahr aus dem Bestand fällt und wie das Dashboard aussieht, steht im Code und nicht in einer Anweisung an das Modell. Das Modell schreibt auch nicht selbst in den Bestand. Es liefert eine Datei, und ein Skript arbeitet sie nach festen Regeln in die Datei events.json ein.
Diese Datei ist der Vertrag. Sie hat ein festgelegtes Schema, sie ist die einzige Quelle der Wahrheit, und jede Ansicht wird aus ihr erzeugt. Eine Datenbank, einen Server oder ein Abonnement gibt es nicht. Daraus folgt der wichtigste praktische Vorteil: Wenn etwas falsch aussieht, lässt sich die Datei öffnen und nachsehen, ob der Fehler beim Lesen oder bei den Regeln liegt.
Dass die Regeln Code sind, heißt nicht, dass sie richtig sind. Die erste Fassung der Entdopplung hielt zwei Einträge schon dann für dieselbe Veranstaltung, wenn sie denselben Link trugen. Viele Veranstalter führen aber alle Termine einer Reihe unter einer einzigen Übersichtsseite, und so verschwanden in einem einzigen Lauf 23 neue Termine in ihren älteren Vorgängern. Aufgefallen ist es, weil der Fehler eine prüfbare Spur hinterließ: vergangene Veranstaltungen, die als heute wiedergefunden markiert waren. Seitdem zählt ein gleicher Link nur dann als Treffer, wenn die Startdaten höchstens drei Tage auseinanderliegen.
Ein Sprachmodell ist gut darin, eine unordentliche Seite zu lesen. Einen Bestand zu führen, ist keine solche Aufgabe.
Ein Lauf
Von der Quellenliste zum Dashboard
- 01 Planen Ein Skript liest die Quellendatenbank und entscheidet anhand der bisherigen Erträge, welche Quellen in diesem Lauf fällig sind. Der Plan lässt sich vorab ausgeben, samt Grund für jede übersprungene Quelle.
- 02 Abrufen Jede fällige Quelle wird in einem Browser ohne Oberfläche gerendert und bis zum Ende gescrollt, damit nachgeladene Listen vollständig sind. Gespeichert werden der lesbare Text und, wo die Seite sie anbietet, strukturierte schema.org-Event-Daten, dazu ein Protokoll je Quelle.
- 03 Lesen Das Sprachmodell liest die gespeicherten Seiten, strukturierte Daten zuerst. Es behält nur künftige Präsenzveranstaltungen in Reichweite, reine Online-Termine nur, wenn Thema und Publikum ausdrücklich passen. Für jede füllt es Datum, Ort, Preis, Links, eine kurze Zusammenfassung und den Grund, warum sie relevant ist.
- 04 Bewerten Jede Veranstaltung erhält einen Prioritätswert von 0 bis 100 aus fünf gewichteten Größen. Die Gewichte sind fest; welche Stufe ein Publikum oder ein Format erreicht, schätzt das Modell beim Lesen ein.
- 05 Zusammenführen Ein Skript arbeitet die neuen Einträge ein. Gleicher Link bei höchstens drei Tagen Abstand oder gleicher normalisierter Titel mit gleichem Startdatum gilt als Dublette: Der gespeicherte Eintrag bleibt, leere Felder werden ergänzt. Ein neuer Termin einer Reihe ist ein neuer Eintrag.
- 06 Aufräumen und bauen Was länger als ein Jahr vorbei und nicht als Favorit markiert ist, wandert in ein Protokoll. Die Zahl der behaltenen Veranstaltungen je Quelle geht an den Zeitplan zurück, dann entstehen das Dashboard und eine lesbare Textfassung des Bestands neu.
Wer was entscheidet
Festes Programm
- Welche Quellen in einem Lauf fällig sind und in welcher Reihenfolge.
- Abruf, Scrollen und das Ablegen von Text und strukturierten Daten.
- Die Gewichte der Bewertungsformel und die Obergrenze für teure Formate ohne Hebel.
- Entfernungen zu bekannten Städten aus einer mitgelieferten Tabelle.
- Entdopplung, Aufräumen nach einem Jahr und das Einarbeiten menschlicher Entscheidungen.
- Der Aufbau des Dashboards aus der Bestandsdatei.
Sprachmodell
- Ob ein Eintrag überhaupt eine Veranstaltung ist, und ob sie künftig und vor Ort stattfindet.
- Datum, Ort, Preis und Links aus uneinheitlichem Text.
- Die Stufe für Publikum, Beziehungspotenzial und Zugangshebel, die in die Formel eingeht.
- Eine Zusammenfassung und der Satz, warum die Veranstaltung relevant ist.
- Eine geschätzte Entfernung, wenn eine Stadt noch nicht in der Tabelle steht. Sie wird dort anschließend ergänzt.
Woraus der Prioritätswert besteht
Die Priorität steht an jeder Veranstaltung
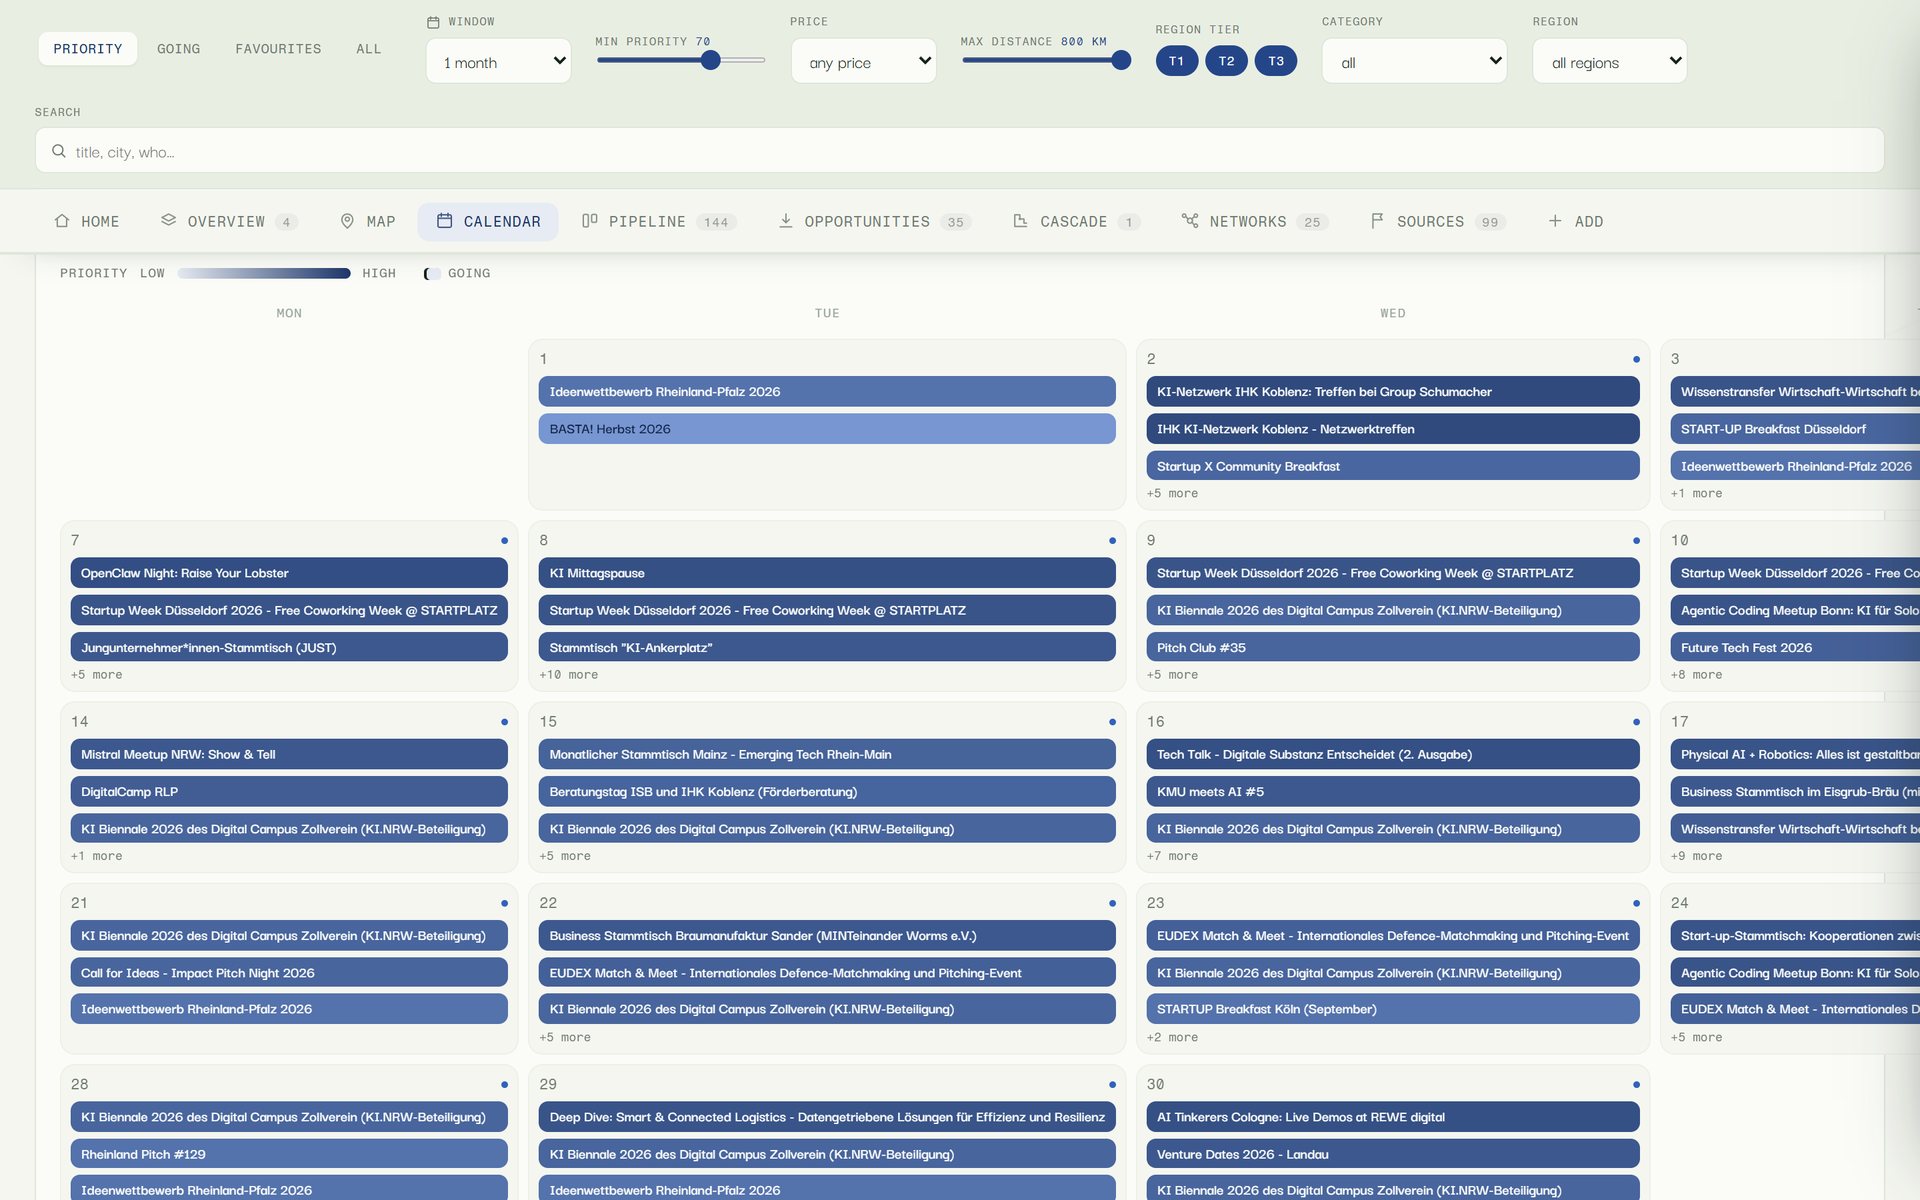
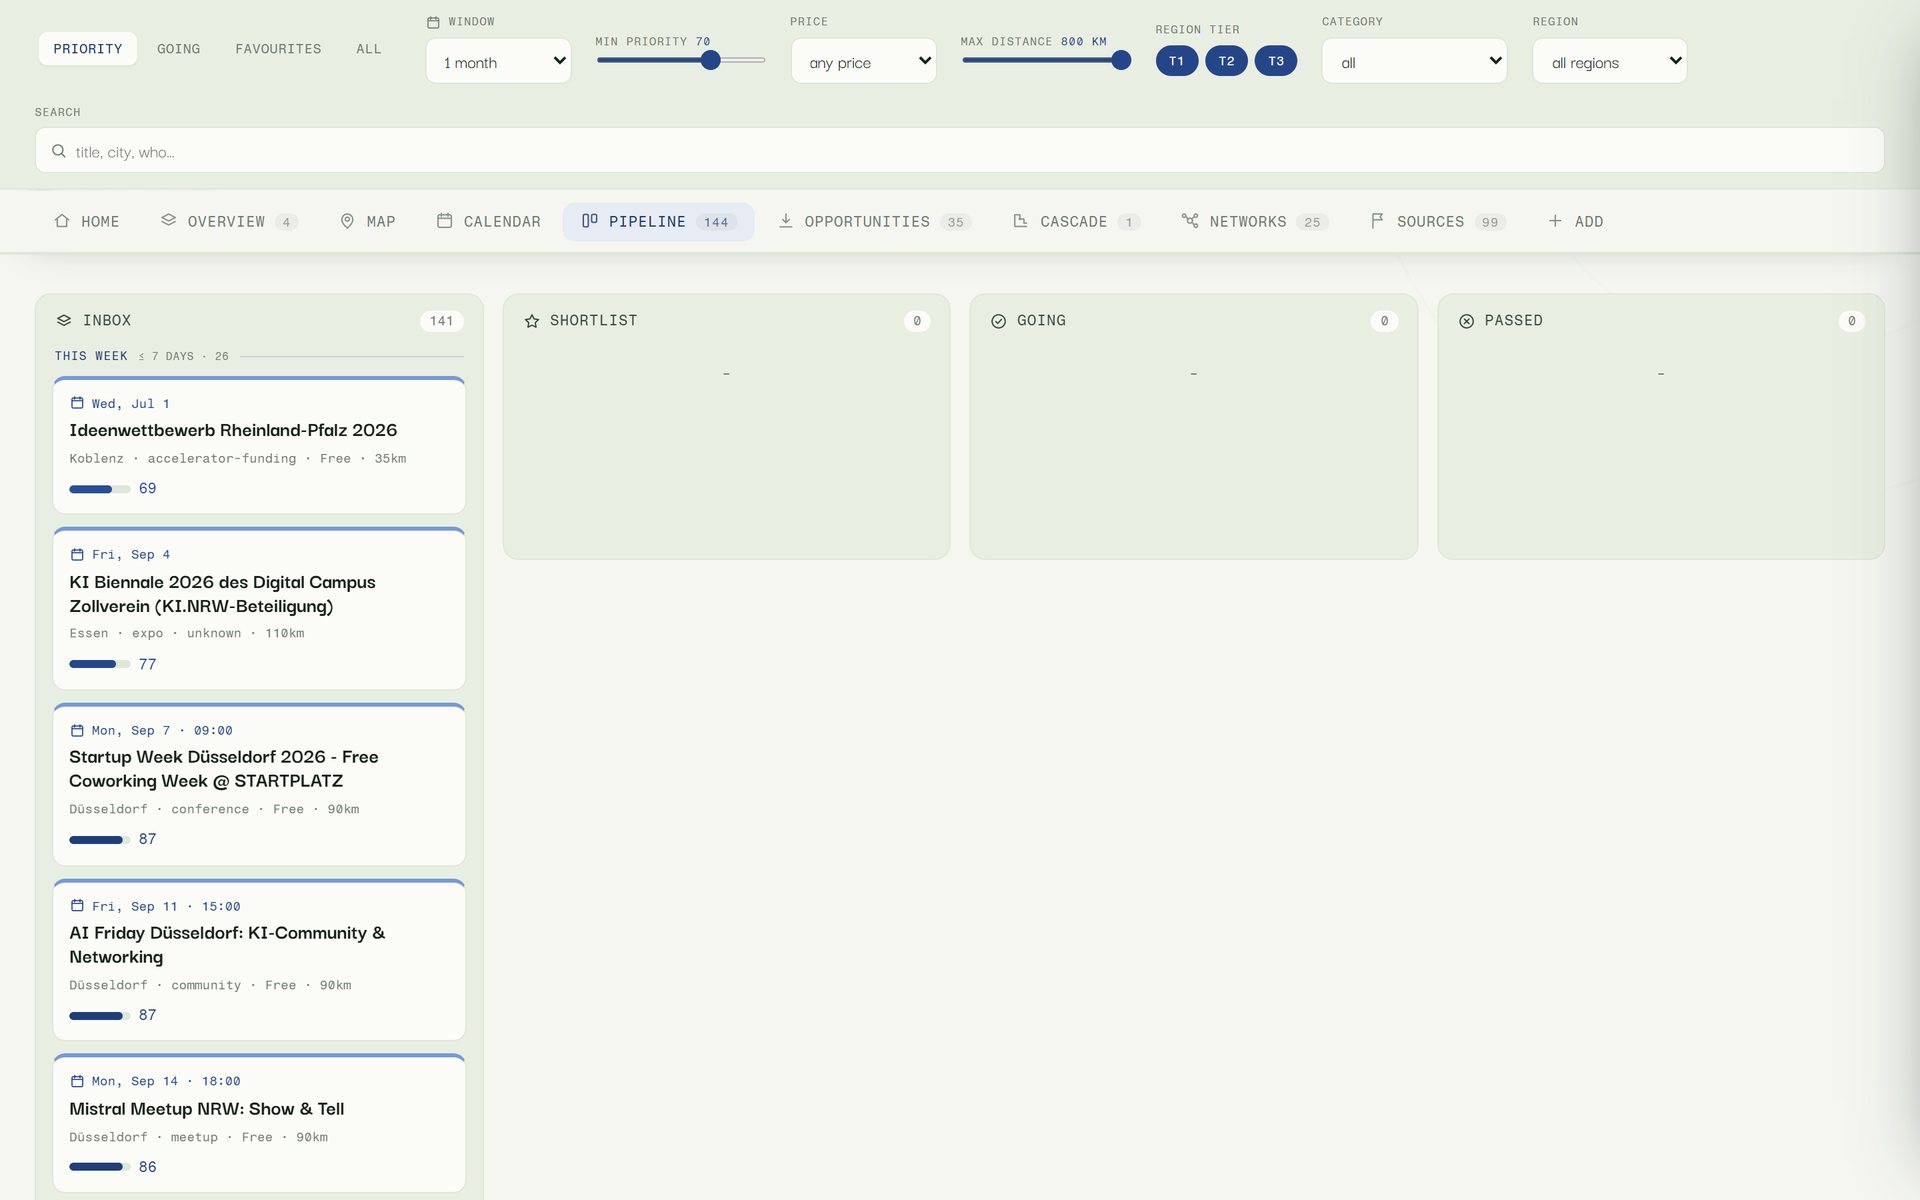
Der Wert bleibt keine Zahl in einer Datei. Auf der Startseite und in der Pipeline steht er als Balken neben jeder Veranstaltung, dessen Länge und Farbtiefe mit dem Wert wachsen. Im Kalender sind die Einträge eines Tages nach Priorität eingefärbt, und die Filter über den Reitern, darunter ein Regler für die Mindestpriorität, gelten für alle Ansichten zugleich.
Wer wissen will, warum eine Veranstaltung oben steht, öffnet ihre Detailansicht. Dort ist der Wert aufgeschlüsselt: Lage und Zeitnähe exakt, weil sie direkt aus der Formel folgen, der Rest als gemeinsamer Anteil für Publikum, Beziehung und Hebel. Dazu kommen ein Verweis auf die Quelle, über die sie gefunden wurde, und ein vorausgefüllter Kalendereintrag.
Entfernung als Stufe
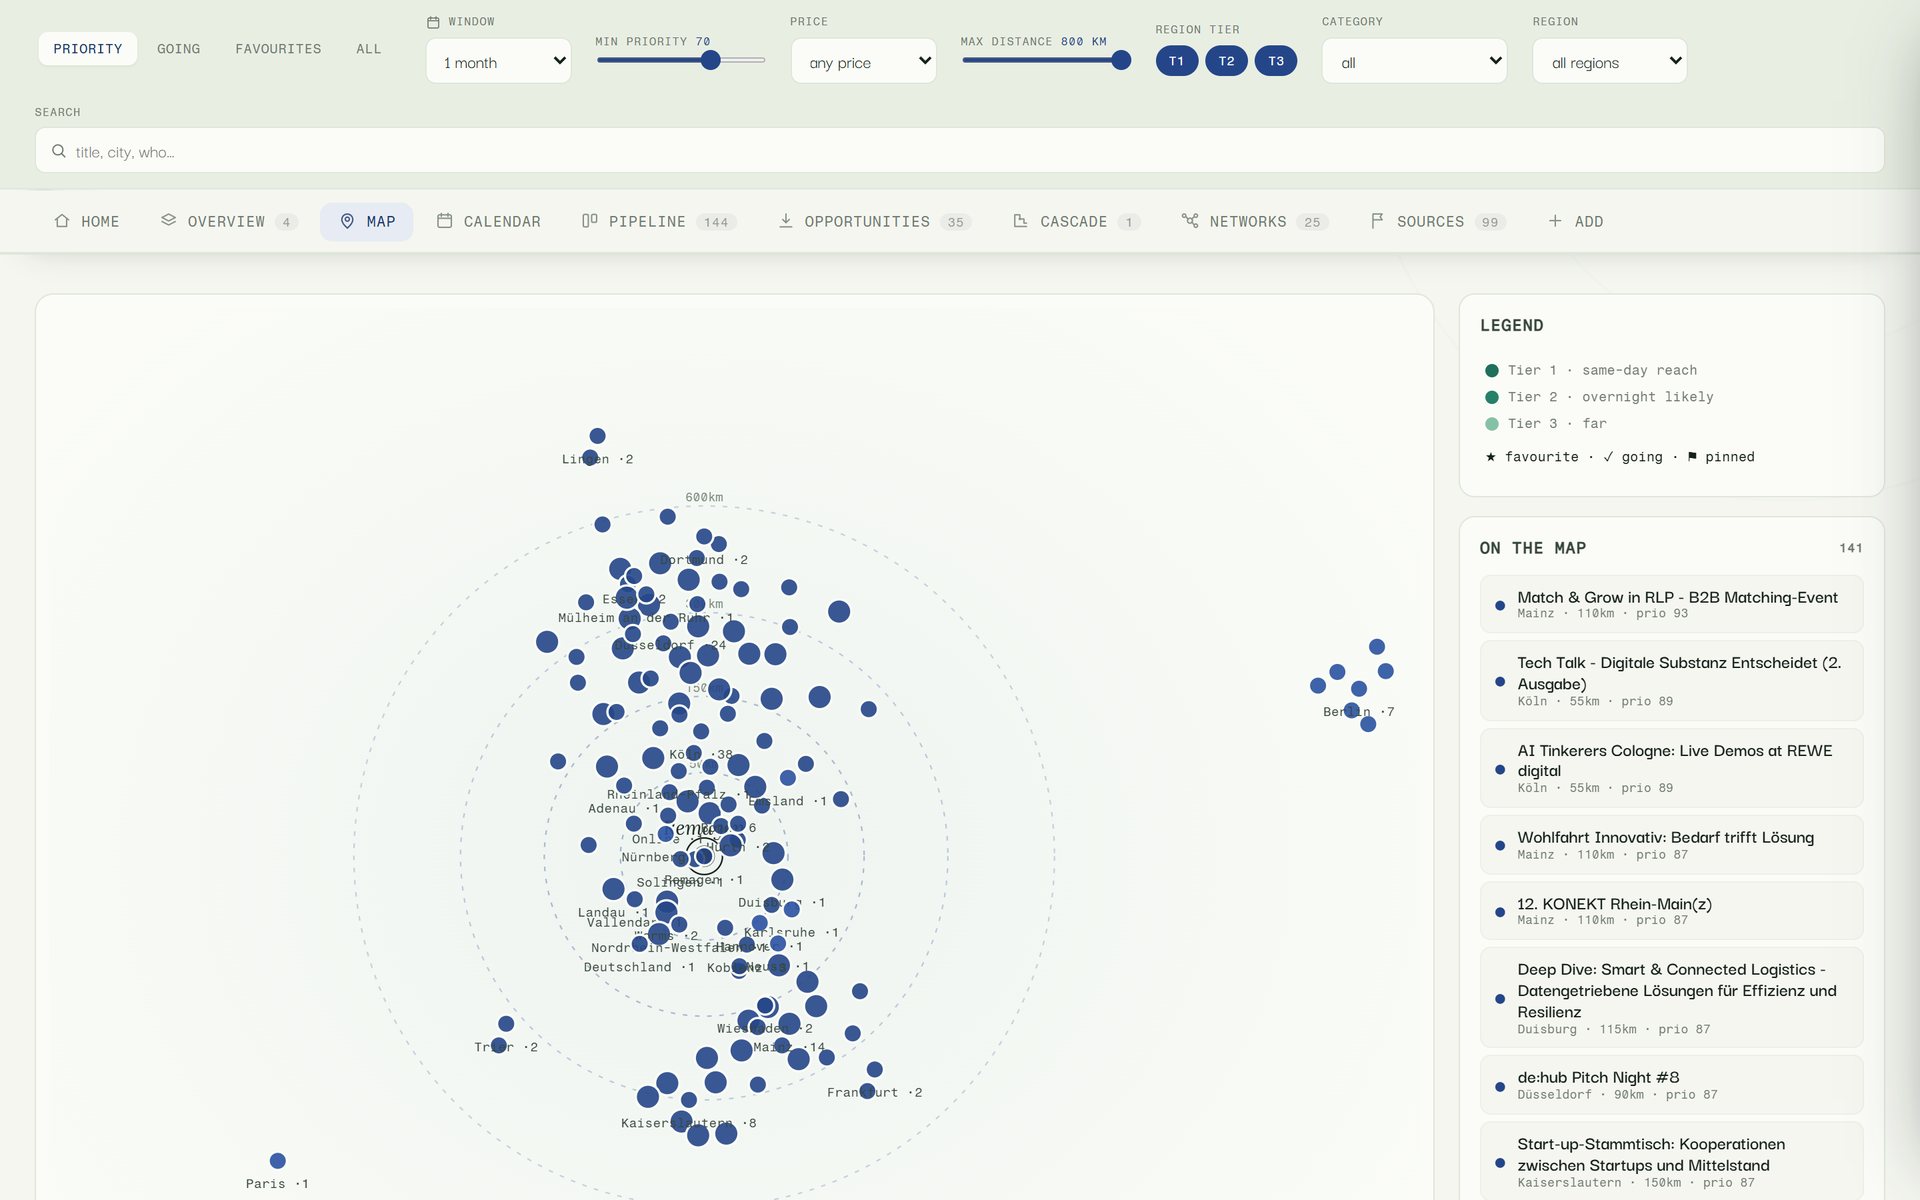
Die Ringe markieren 50, 150, 300 und 600 Kilometer, gezeichnet in festen Abständen und nicht maßstäblich. Jede bekannte Stadt hat eine feste Position, die Punkte einer Stadt fächern sich um sie auf, und Veranstaltungen mit hohem Wert erhalten einen größeren Punkt. Die Liste rechts ordnet dieselbe Auswahl nach Priorität.
Für die Bewertung zählt nicht die Kilometerzahl, sondern die Stufe. Stufe 1 umfasst Rheinland-Pfalz, Nordrhein-Westfalen und Hessen mit Umgebung, also Ziele, die an einem Tag hin und zurück erreichbar sind. Stufe 2 reicht über das übrige Deutschland nach Luxemburg, in die Schweiz und nach Frankreich, Stufe 3 ist das übrige Europa und nur bei besonderen Anlässen dabei. Die Fahrzeiten stammen aus einer mitgelieferten Städtetabelle.
Zeitplan
Quellen verdienen sich, wie oft sie gefragt werden
Eine Quelle, die jede Woche gleich gründlich abgefragt wird, kostet Zeit, auch wenn sie seit Monaten nichts Brauchbares liefert. Deshalb führt jede Quelle eine kurze Ertragsgeschichte: wie viele Veranstaltungen das Modell in den letzten fünf Läufen aus ihr behalten hat. Aus dem Mittelwert ergibt sich eines von drei Bändern. Die Einschätzung des Modells steuert den Zeitplan also nur über eine gezählte Zahl.
Band A wird bei jedem Lauf abgefragt. Dazu gehören Quellen mit einem Mittel von mindestens drei behaltenen Veranstaltungen und solche, die als besonders wichtig eingestuft sind, auch nach einem leeren Lauf. Band B enthält Quellen mit etwas Ertrag oder noch ohne Geschichte; sie sind nach sieben Tagen wieder fällig, höchstens acht je Lauf, die ältesten zuerst. Band C sammelt Quellen, die wiederholt nichts liefern. Sie pausieren sieben, dann vierzehn, dann achtundzwanzig, höchstens dreißig Tage und werden danach erneut versucht, höchstens drei je Lauf.
Eine Seite, die sich laden lässt, aber keine Veranstaltungen zeigt, rückt nur nach hinten. Als defekt gilt eine Quelle erst, wenn sie dreimal hintereinander nicht abgerufen werden konnte. Neue Quellen kommen unter anderem aus einem Register öffentlicher Netzwerke, Acceleratoren, Forschungsinstitute und Cluster in der Region: Hat eine Organisation dort eine Veranstaltungsseite, die noch nicht in der Quellendatenbank steht, kann sie aufgenommen werden. Das Register selbst wird nie als Veranstaltungsquelle gelesen, damit nichts doppelt zählt.
Menschliche Entscheidungen fließen in denselben Bestand zurück
Was jemand mit einer Veranstaltung vorhat, entscheidet kein Modell. In der Pipeline-Ansicht wandert eine Karte per Ziehen aus dem Eingang in die Auswahl, auf Teilnahme oder auf Verworfen; in den Listen lassen sich Veranstaltungen außerdem als Favorit markieren, anheften oder archivieren.
Das Dashboard ist eine einzelne HTML-Datei ohne Server, deshalb liegen diese Entscheidungen zunächst im Browser. Ein Knopf exportiert sie als Zustandsdatei, und der nächste Lauf arbeitet sie in events.json ein, bevor irgendetwas abgerufen wird: Teilnahme, Favorit, Archiv, Anheften, von Hand ergänzte Veranstaltungen und vorgeschlagene neue Quellen.
Favoriten sind vom Aufräumen ausgenommen und bleiben auch nach Jahren im Bestand. Ein angehefteter Termin erscheint auf der Startseite unabhängig von seinem Wert, und keine dieser Markierungen verändert den Prioritätswert selbst.
Ein Datenstand, drei Lesarten
Dieselben Termine als Liste, Karte und Kalender
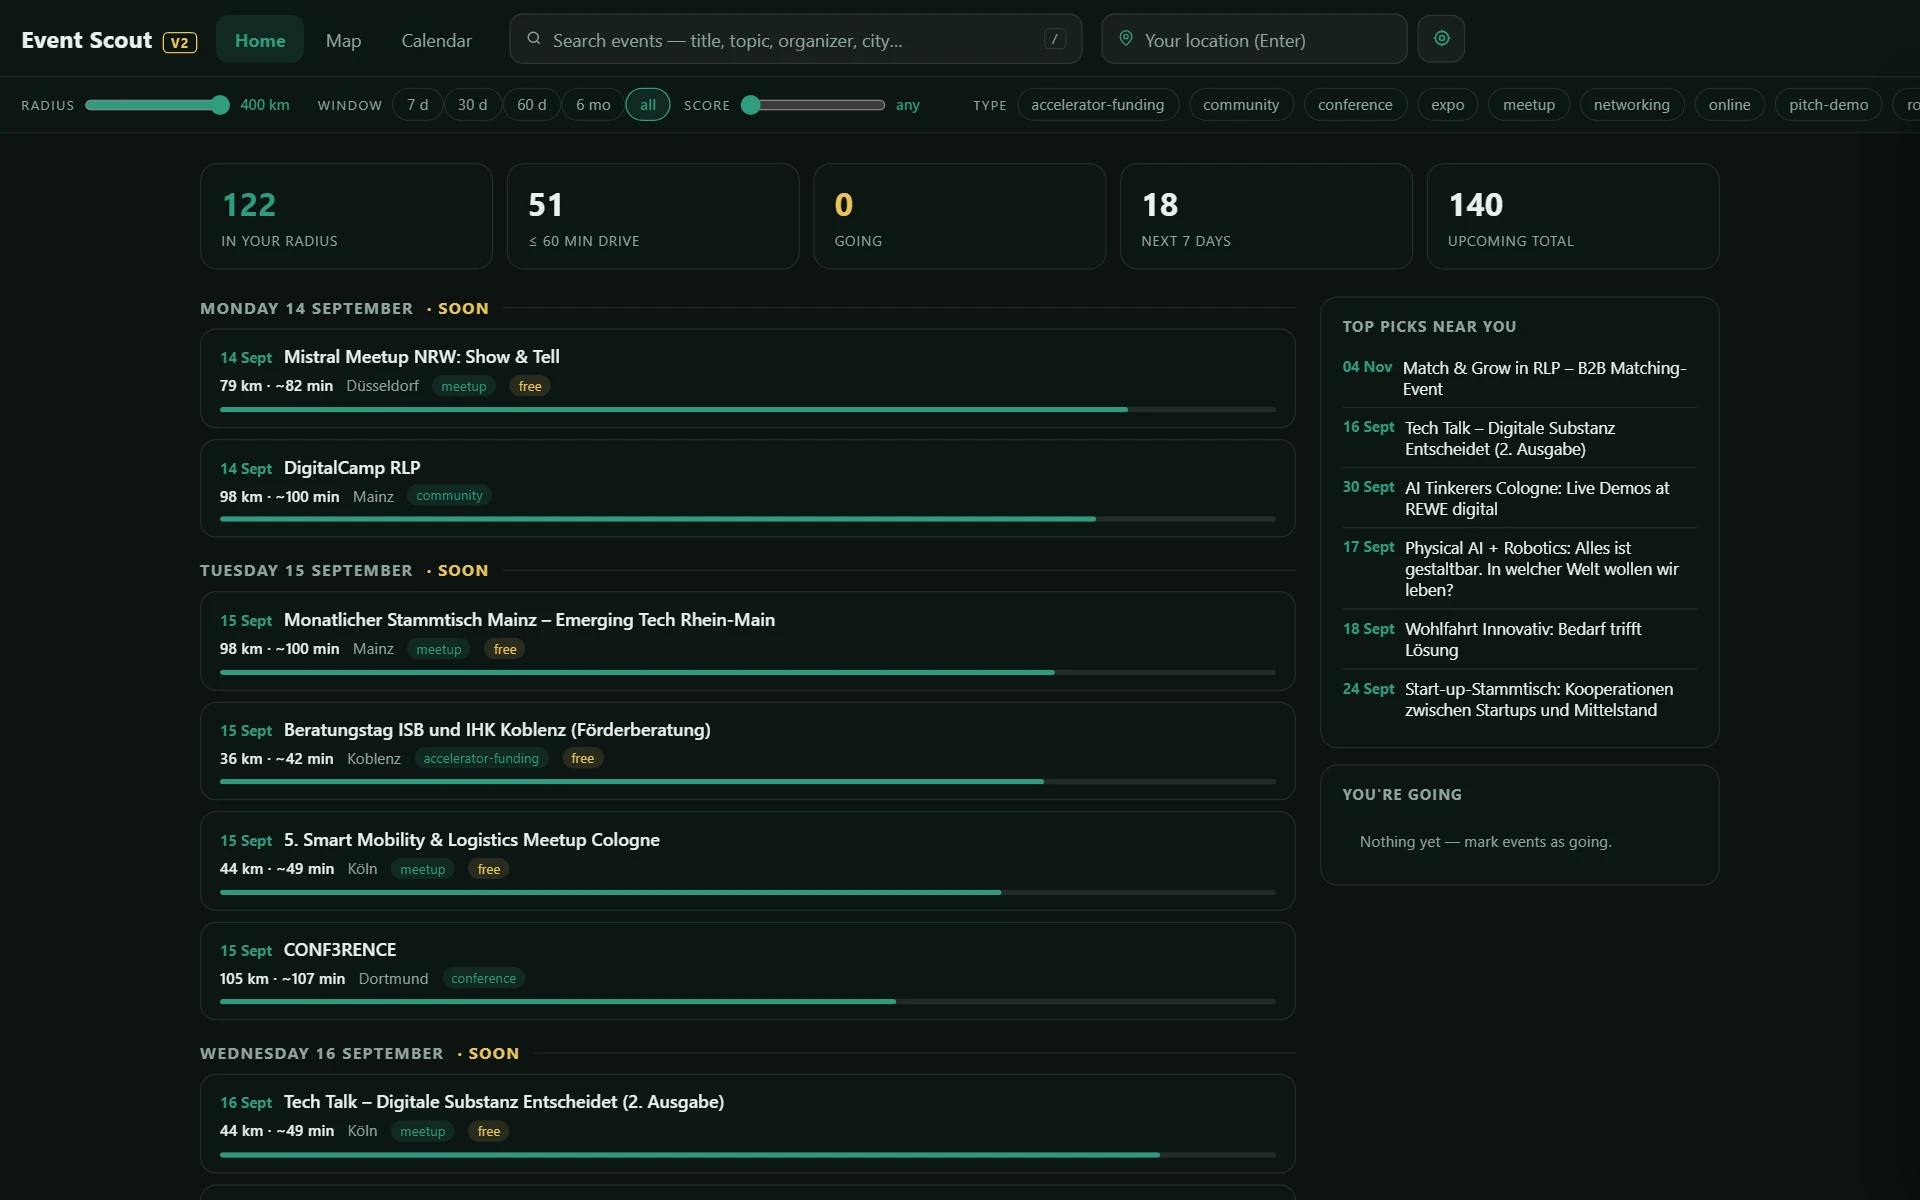
ListeAlle drei Ansichten zeigen denselben gefilterten Datenstand. Radius, Zeitfenster und Mindestrelevanz oben gelten für Liste, Karte und Kalender gleichermaßen.
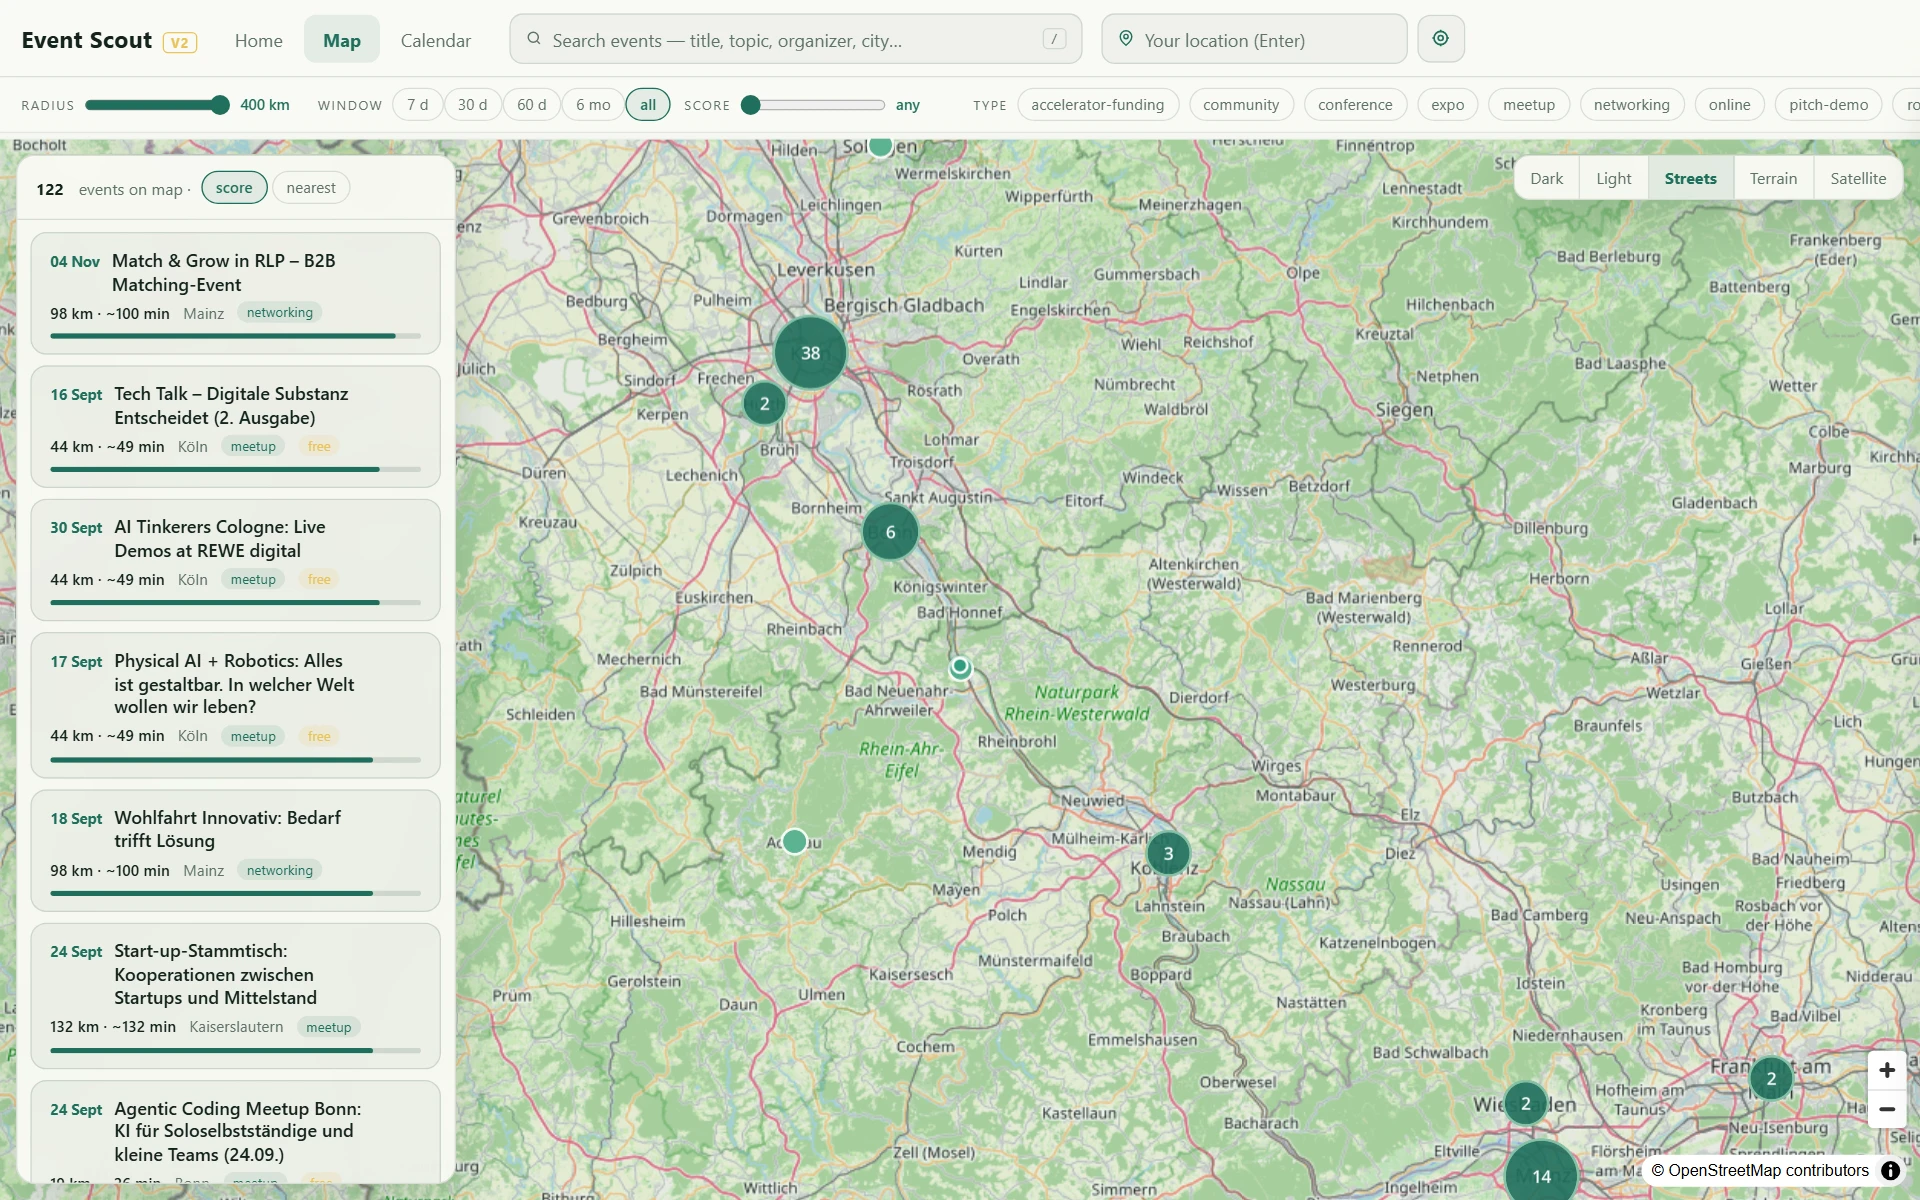
KarteDie Bündel zeigen auf einen Blick, wo sich Termine ballen: Köln und Bonn tragen die größten Zahlen, das Ahrtal und Koblenz die kleineren.
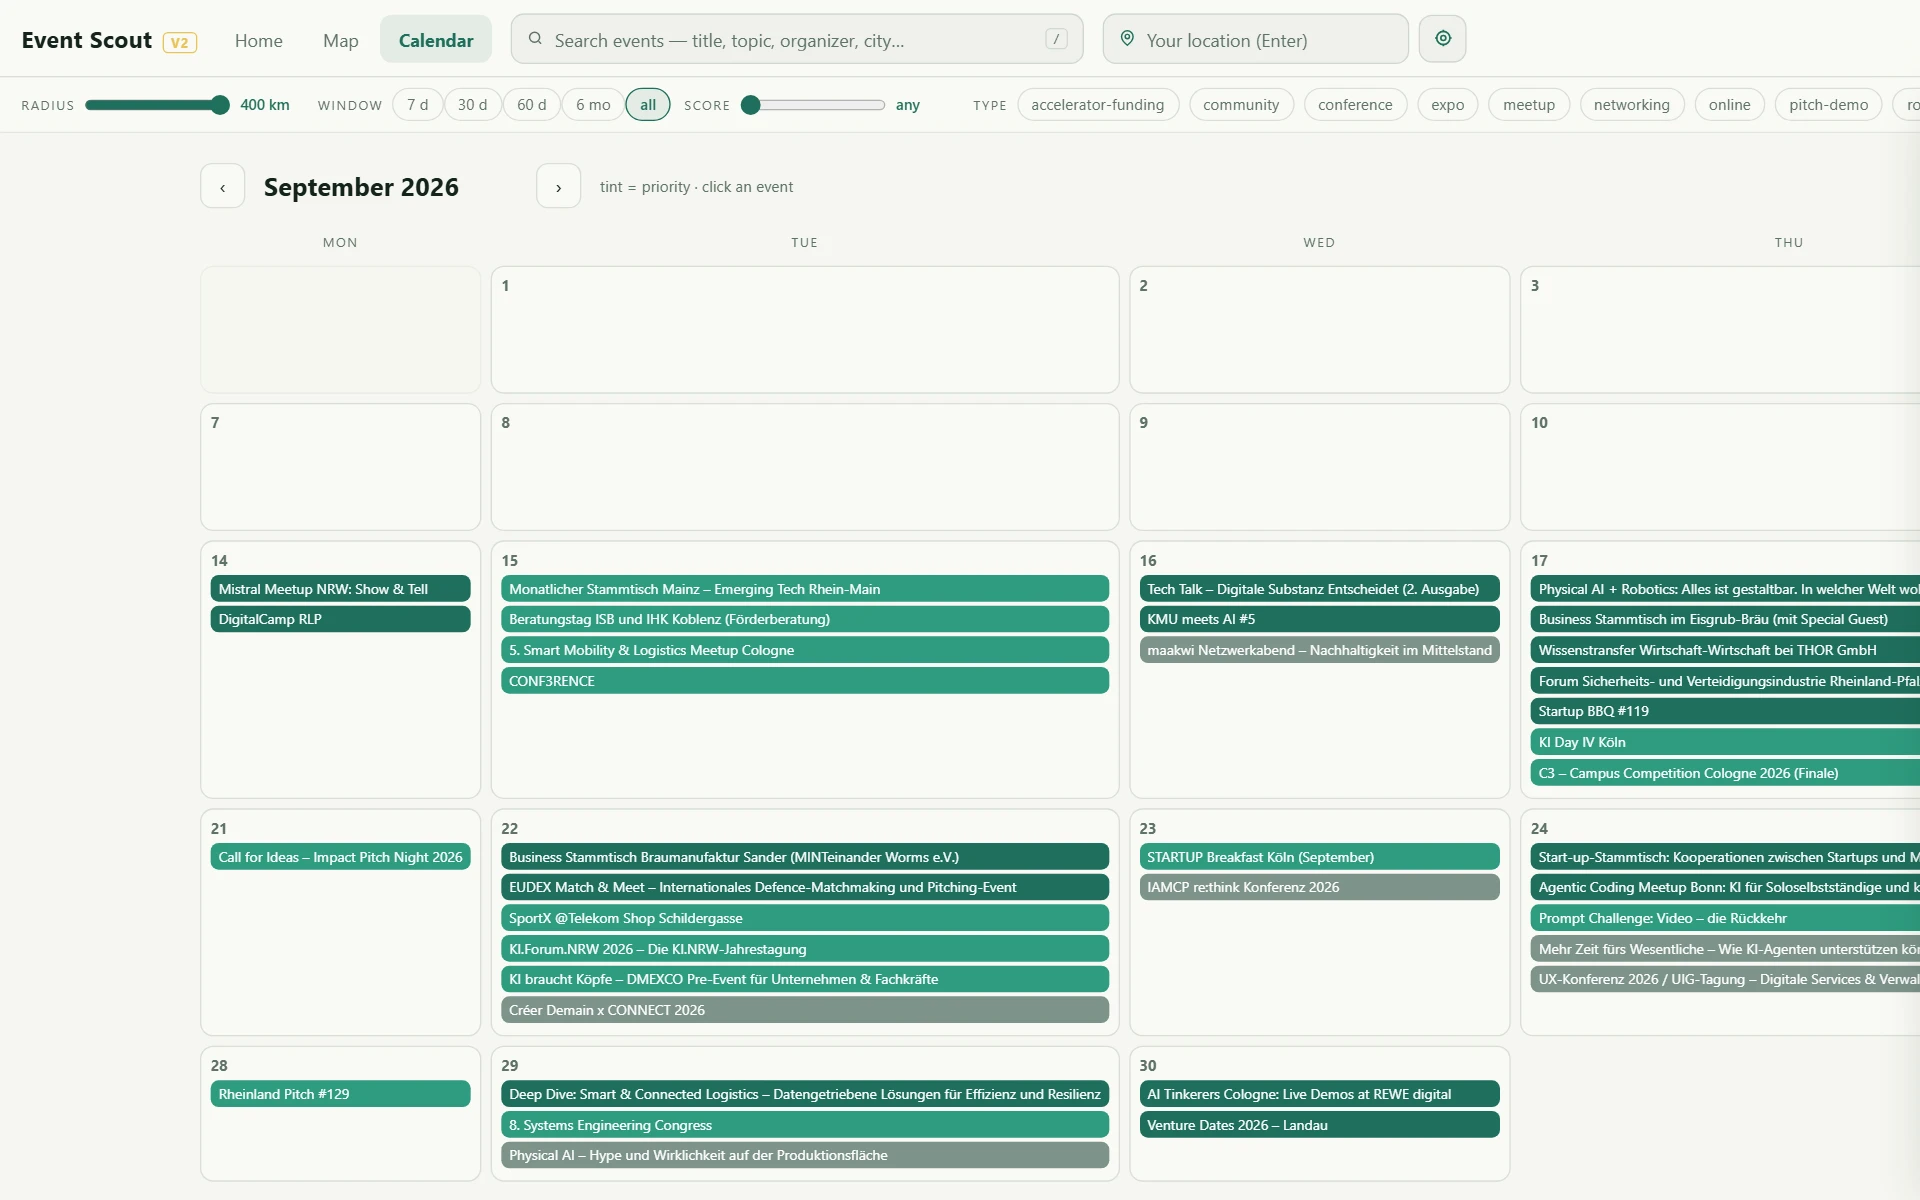
KalenderDer Kalender ist hell gesetzt, Liste und Karte dunkel: dieselbe Oberfläche, an die jeweilige Aufgabe angepasst, ohne dass die Daten sich ändern.
Wo dieselbe Bauweise passt
- Öffentliche Ausschreibungen aus mehreren Vergabeportalen sichten und nach eigenen Kriterien reihen.
- Änderungen an Normen, Richtlinien oder Herstellerdokumentation über viele Herausgeberseiten verfolgen.
- Markt- und Wettbewerbsbeobachtung aus Pressemitteilungen, Produktseiten und Fachkalendern.
- Aussteller- und Anbieterlisten verschiedener Messen in einen gemeinsamen, entdoppelten Bestand überführen.
- Jede wiederkehrende Sichtung, bei der heute jemand jede Woche dieselben Seiten von Hand öffnet.
Bildnachweis: Alle Aufnahmen sind Screenshots unserer eigenen Anwendung, erstellt aus einer bereinigten Kopie des Bestands. Die sichtbaren Veranstaltungen sind öffentlich angekündigte Termine ihrer jeweiligen Veranstalter.
Publikationsgrund
Was das für Ihr Projekt heißt
Weiteres aus dem Lab
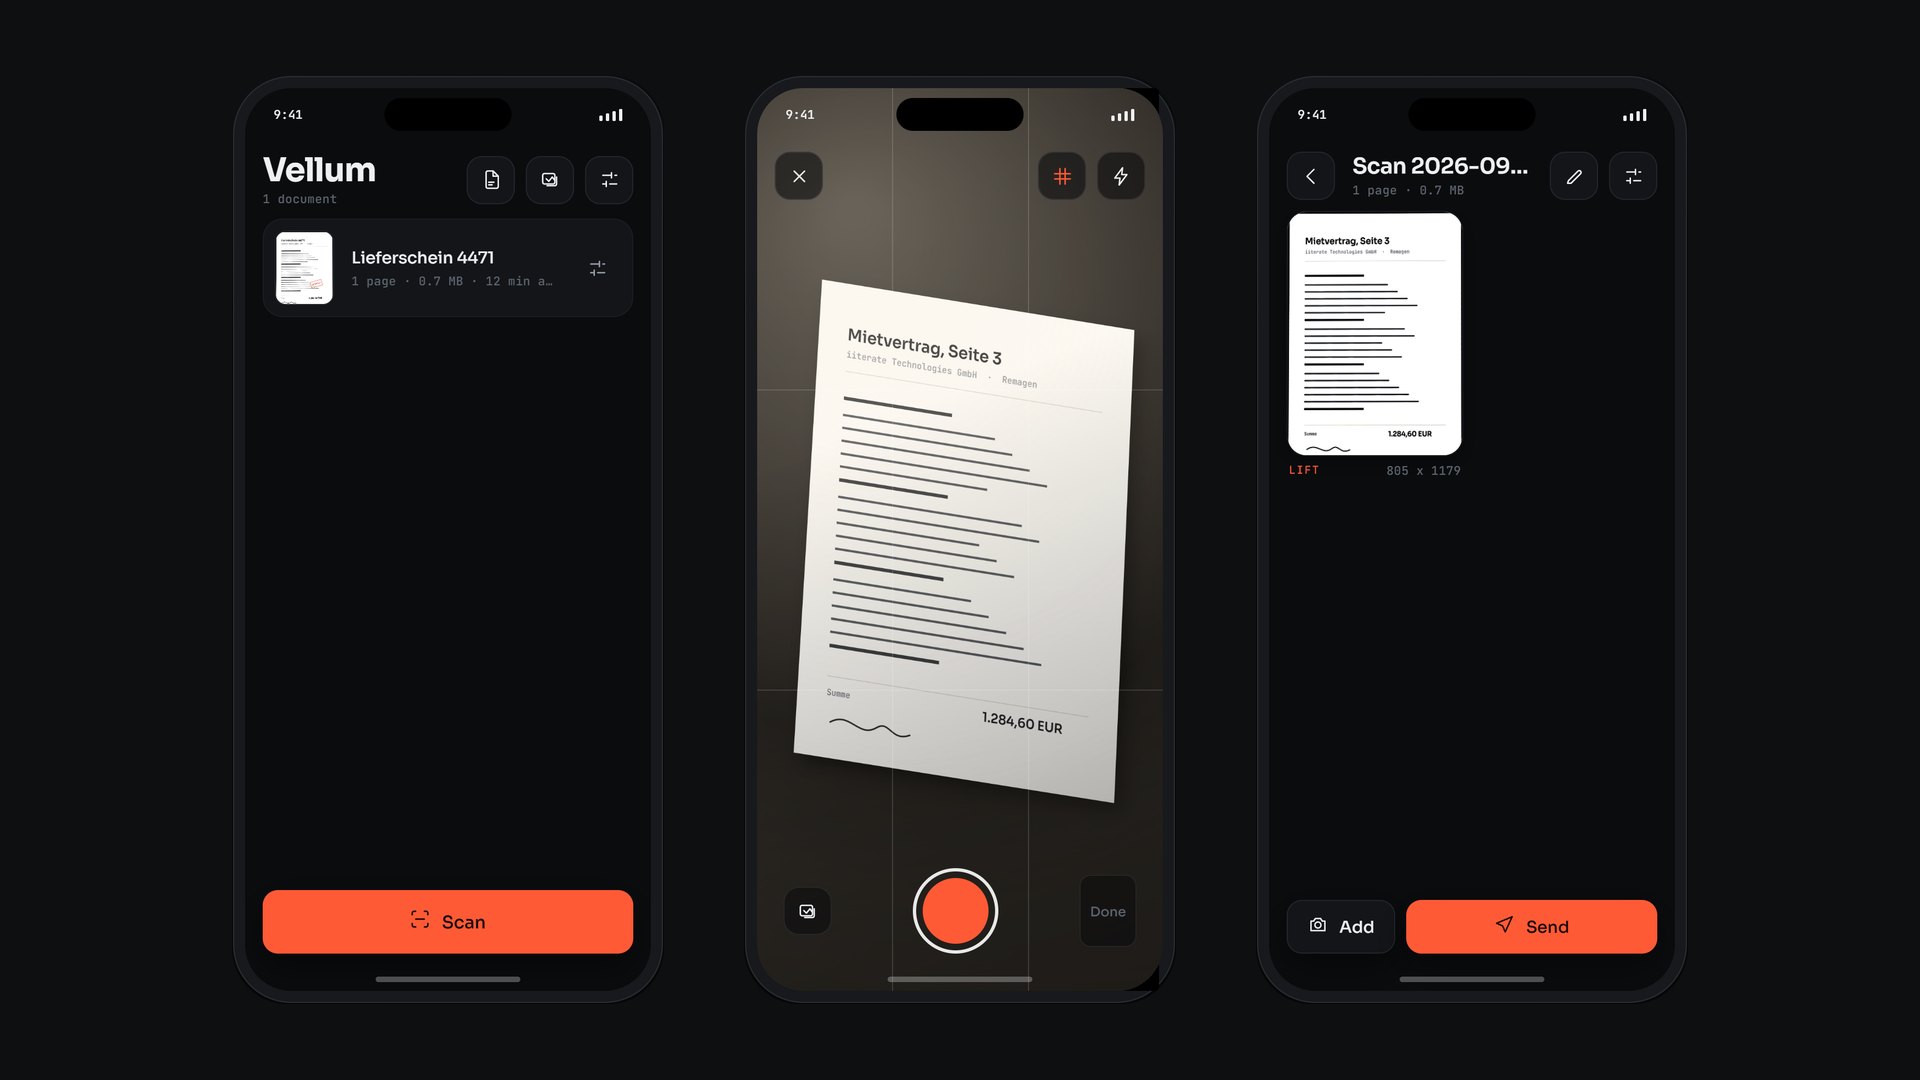 Angewandte Forschung Vellum Kanten, Perspektive, Licht und Text werden auf dem Telefon berechnet. Ein Dokument verlässt das Gerät erst, wenn jemand es sendet.
 Computational Design Atlas EV1 Zwölf Kapitel nehmen ein Elektroauto auseinander, bis zur einzelnen Zelle. Keine Modelldateien, keine Texturen: 327 Teile aus einer Maßtabelle.
 Methode Contradiction Sagen Sie, was besser werden muss und was dabei schlechter wird. Sie bekommen die Prinzipien, die genau dieses Paar gelöst haben, und die Erfindungen, die es getan haben.
Öffnet bei Ihnen jemand jede Woche dieselben Seiten, um eine Liste aktuell zu halten? Genau dafür gibt es einen Piloten.
Kontakt aufnehmen