

R&D LAB Méthode En service Conçu pour notre propre développement commercial
Event Scout
Un pipeline agentique pour les événements en présentiel de la région
Un modèle de langage lit les pages d'événements, tout le reste est du code fixe. Il reste une courte liste des journées qui valent le déplacement.
- 5composantes pondérées dans la note de priorité
- 3niveaux de distance autour du siège
- 3bandes de consultation, pilotées par le rendement de chaque source
- 0serveur de base de données : le registre est un fichier JSON
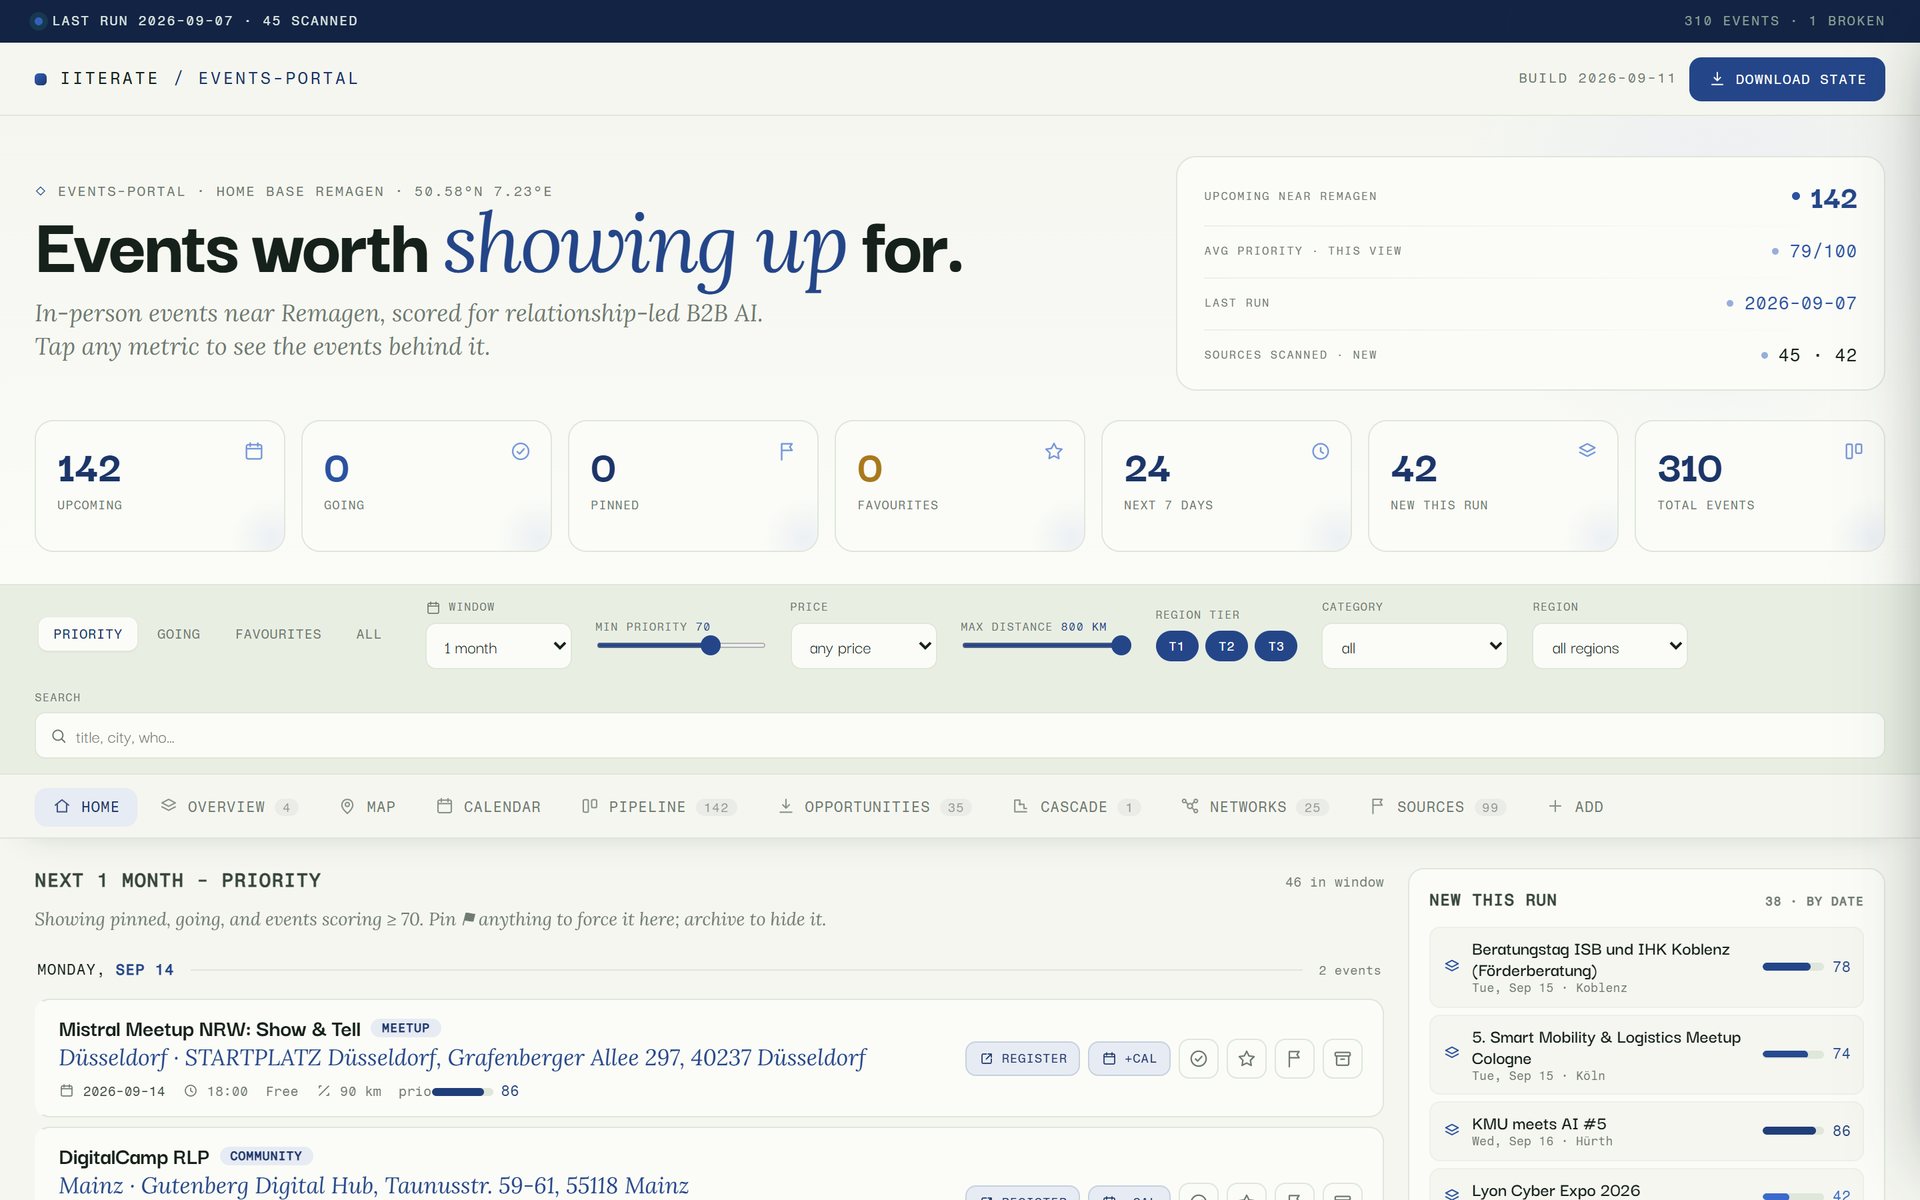
Page d'accueil issue d'une copie nettoyée du registre. Participation et favoris affichent zéro, car ces marques ont été retirées avant la capture.
Pourquoi c'est publié
Nous vendons de l'IA et du logiciel. Event Scout est la preuve sur la question qui vient en premier dans tout projet agentique : comment placer un modèle de langage dans un processus sur lequel on peut compter chaque semaine. La réponse est ici un partage des rôles. Récupération, planification, dédoublonnage, nettoyage et formule de notation sont du code fixe, le modèle prend en charge la seule étape qui exige de lire, et un fichier au schéma fixe constitue le contrat entre les deux. Si vous voulez automatiser une veille récurrente dans votre propre organisation, vous voyez ici où nous traçons cette limite.
Les événements où l'on rencontre réellement des clients ne sont pas réunis en un seul endroit. Ils se répartissent entre les agendas des chambres et des réseaux, des newsletters, des groupes de meetup et des pages d'universités, chacun avec son format, beaucoup lisibles seulement après qu'un script a chargé la liste. Parcourir tout cela à la main chaque semaine est précisément le genre de tâche qu'on finit par abandonner. Event Scout est le pipeline qui s'en charge pour nous : il tient une base de sources sélectionnées, récupère celles qui sont dues en un traitement par lots, fait extraire par un modèle de langage uniquement les événements futurs en présentiel à portée du siège, les évalue pour une vente B2B fondée sur la relation, les fusionne dans un registre unique et reconstruit à partir de lui un tableau de bord autonome.
La décision
Le modèle lit, le code tient le registre
Une page d'événement est un mauvais format de données. La même information figure une fois sous forme de tableau, une fois dans le texte d'une newsletter, une fois dans un agenda qui ne se charge qu'en faisant défiler. Une expression régulière y échoue, un modèle de langage non. C'est donc précisément là, et seulement là, que se place le modèle : il lit les pages récupérées, décide de ce qui constitue un événement futur en présentiel à portée, et remplit pour chacun les champs d'un schéma fixe.
Tout ce qui précède et suit est du code ordinaire. Quelles sources sont dues aujourd'hui, comment elles sont récupérées, quand deux entrées désignent le même événement, ce qui sort du registre au bout d'un an et l'apparence du tableau de bord sont écrits dans le code, et non dans une consigne au modèle. Le modèle n'écrit pas non plus lui-même dans le registre. Il livre un fichier, et un script l'intègre dans events.json selon des règles fixes.
Ce fichier est le contrat. Il a un schéma défini, il est l'unique source de vérité, et chaque vue en est générée. Il n'y a ni base de données, ni serveur, ni abonnement. Il en découle l'avantage pratique le plus important : quand quelque chose semble faux, on peut ouvrir le fichier et voir si l'erreur vient de la lecture ou des règles.
Que les règles soient du code ne les rend pas justes. La première version du dédoublonnage considérait deux entrées comme le même événement dès qu'elles portaient le même lien. Or beaucoup d'organisateurs publient toutes les dates d'une série sous une seule page de synthèse, et c'est ainsi qu'en une seule exécution 23 nouvelles dates ont disparu dans leurs prédécesseurs plus anciens. On l'a remarqué parce que l'erreur laissait une trace vérifiable : des événements passés marqués comme retrouvés le jour même. Depuis, un lien identique ne compte comme correspondance que si les dates de début sont espacées de trois jours au plus.
Un modèle de langage sait bien lire une page désordonnée. Tenir un registre n'est pas une tâche de ce genre.
Une exécution
De la liste des sources au tableau de bord
- 01 Planifier Un script lit la base de sources et décide, d'après les rendements passés, quelles sources sont dues lors de cette exécution. Le plan peut être affiché à l'avance, avec la raison de chaque source écartée.
- 02 Récupérer Chaque source due est rendue dans un navigateur sans interface et défilée jusqu'en bas, afin que les listes chargées à la demande soient complètes. Sont enregistrés le texte lisible et, lorsque la page les propose, les données structurées schema.org Event, ainsi qu'une entrée de journal par source.
- 03 Lire Le modèle de langage lit les pages enregistrées, données structurées en premier. Il ne garde que les événements futurs en présentiel à portée, et les rendez-vous uniquement en ligne seulement si le thème et le public correspondent nettement. Pour chacun, il renseigne date, lieu, prix, liens, un court résumé et la raison de sa pertinence.
- 04 Noter Chaque événement reçoit une note de priorité de 0 à 100 composée de cinq éléments pondérés. Les poids sont fixes ; le niveau atteint par un public ou un format est estimé par le modèle à la lecture.
- 05 Fusionner Un script intègre les nouvelles entrées. Un même lien avec des dates de début espacées de trois jours au plus, ou un même titre normalisé avec la même date de début, vaut doublon : l'entrée enregistrée reste et les champs vides sont complétés. Une nouvelle date d'une série est une nouvelle entrée.
- 06 Nettoyer et construire Ce qui date de plus d'un an et n'est pas marqué comme favori passe dans un journal. Le nombre d'événements retenus par source est renvoyé au planificateur, puis le tableau de bord et une version texte lisible du registre sont régénérés.
Qui décide de quoi
Code fixe
- Quelles sources sont dues lors d'une exécution, et dans quel ordre.
- La récupération, le défilement et l'enregistrement du texte et des données structurées.
- Les poids de la formule de notation et le plafond pour les formats coûteux sans levier.
- Les distances vers les villes connues, tirées d'une table fournie.
- Le dédoublonnage, le nettoyage au bout d'un an et l'intégration des décisions humaines.
- La construction du tableau de bord à partir du fichier de registre.
Modèle de langage
- Si une entrée est bien un événement, et s'il est futur et en présentiel.
- Date, lieu, prix et liens à partir d'un texte hétérogène.
- Le niveau de public, de potentiel relationnel et de levier d'accès qui entre dans la formule.
- Un résumé et la phrase expliquant pourquoi l'événement est pertinent.
- Une distance estimée lorsqu'une ville ne figure pas encore dans la table. Elle y est ajoutée ensuite.
De quoi se compose la note de priorité
La priorité figure sur chaque événement
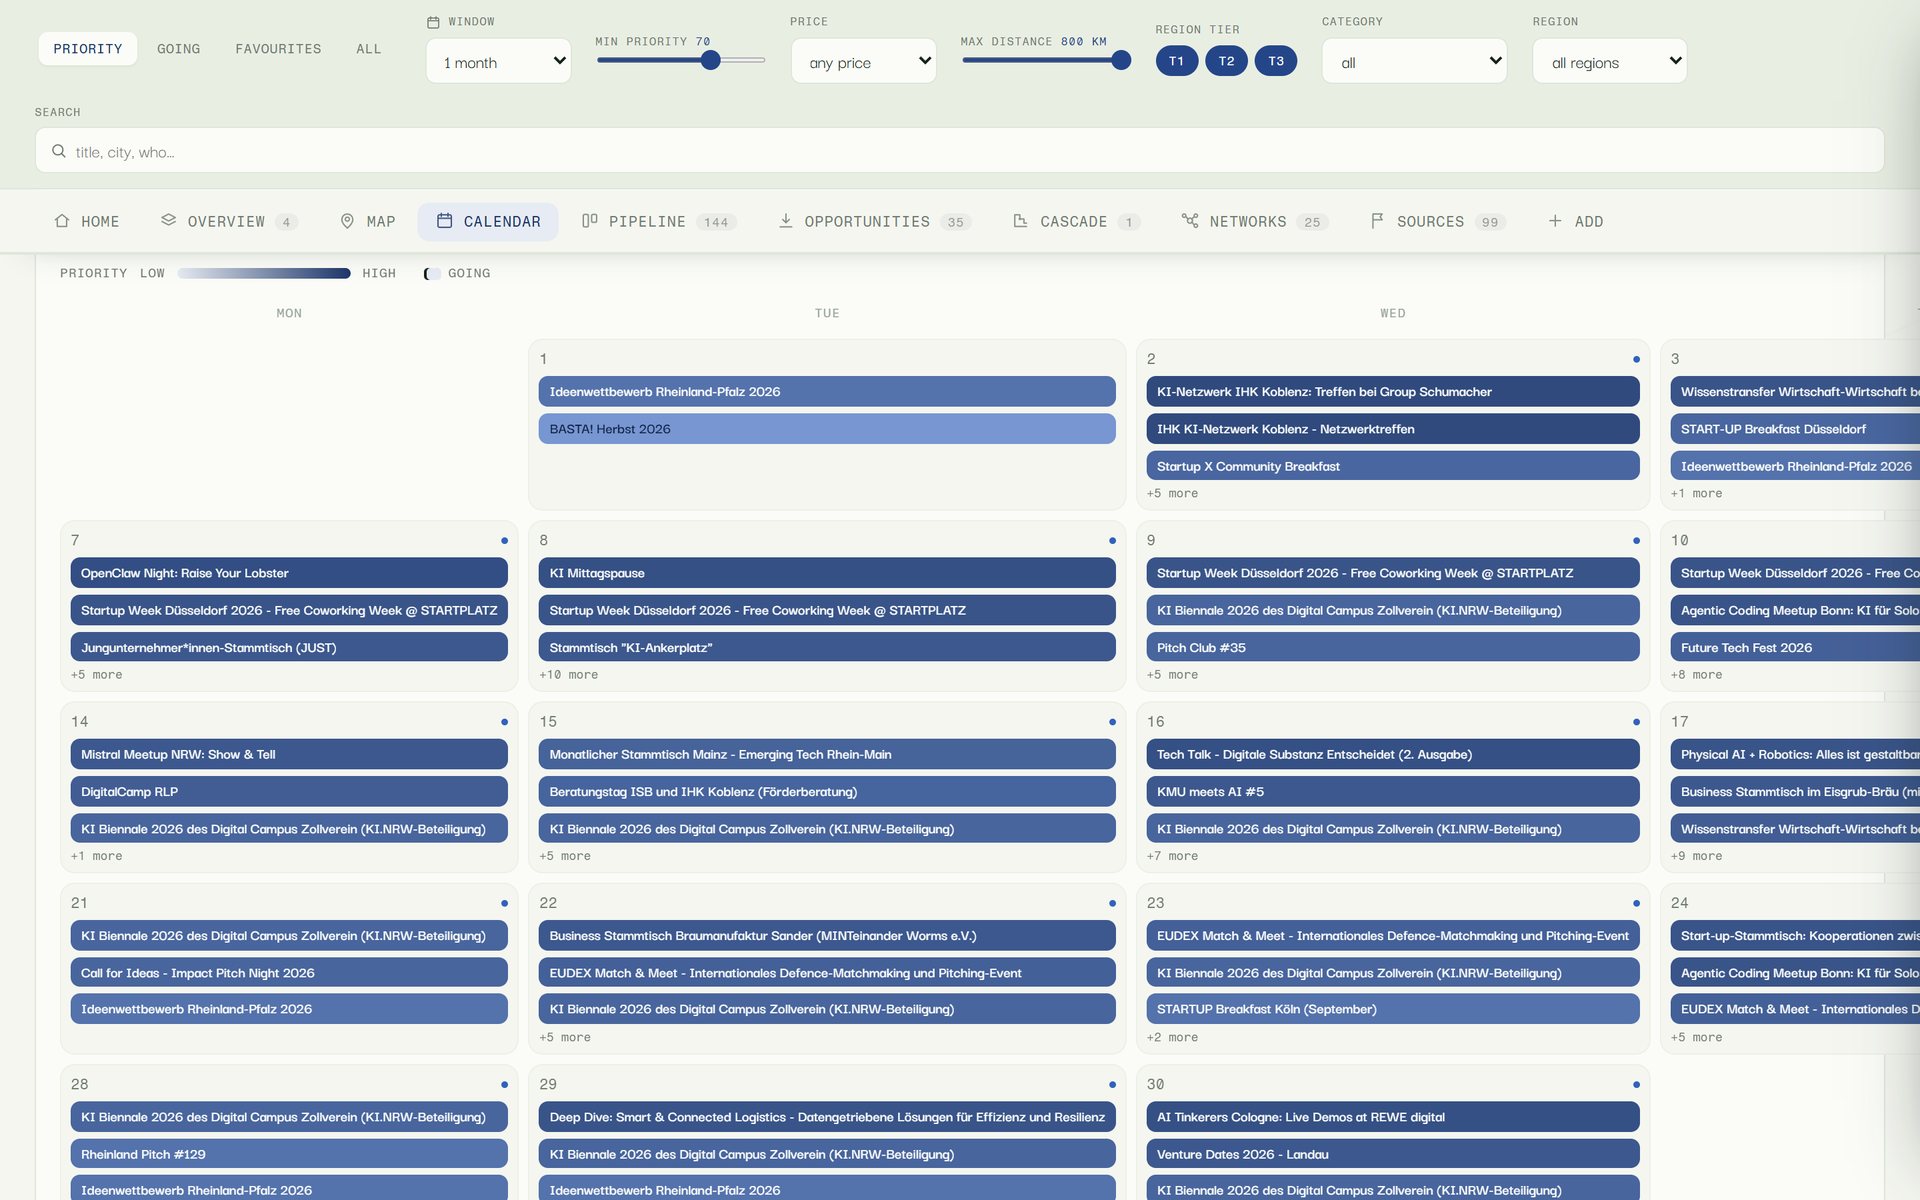
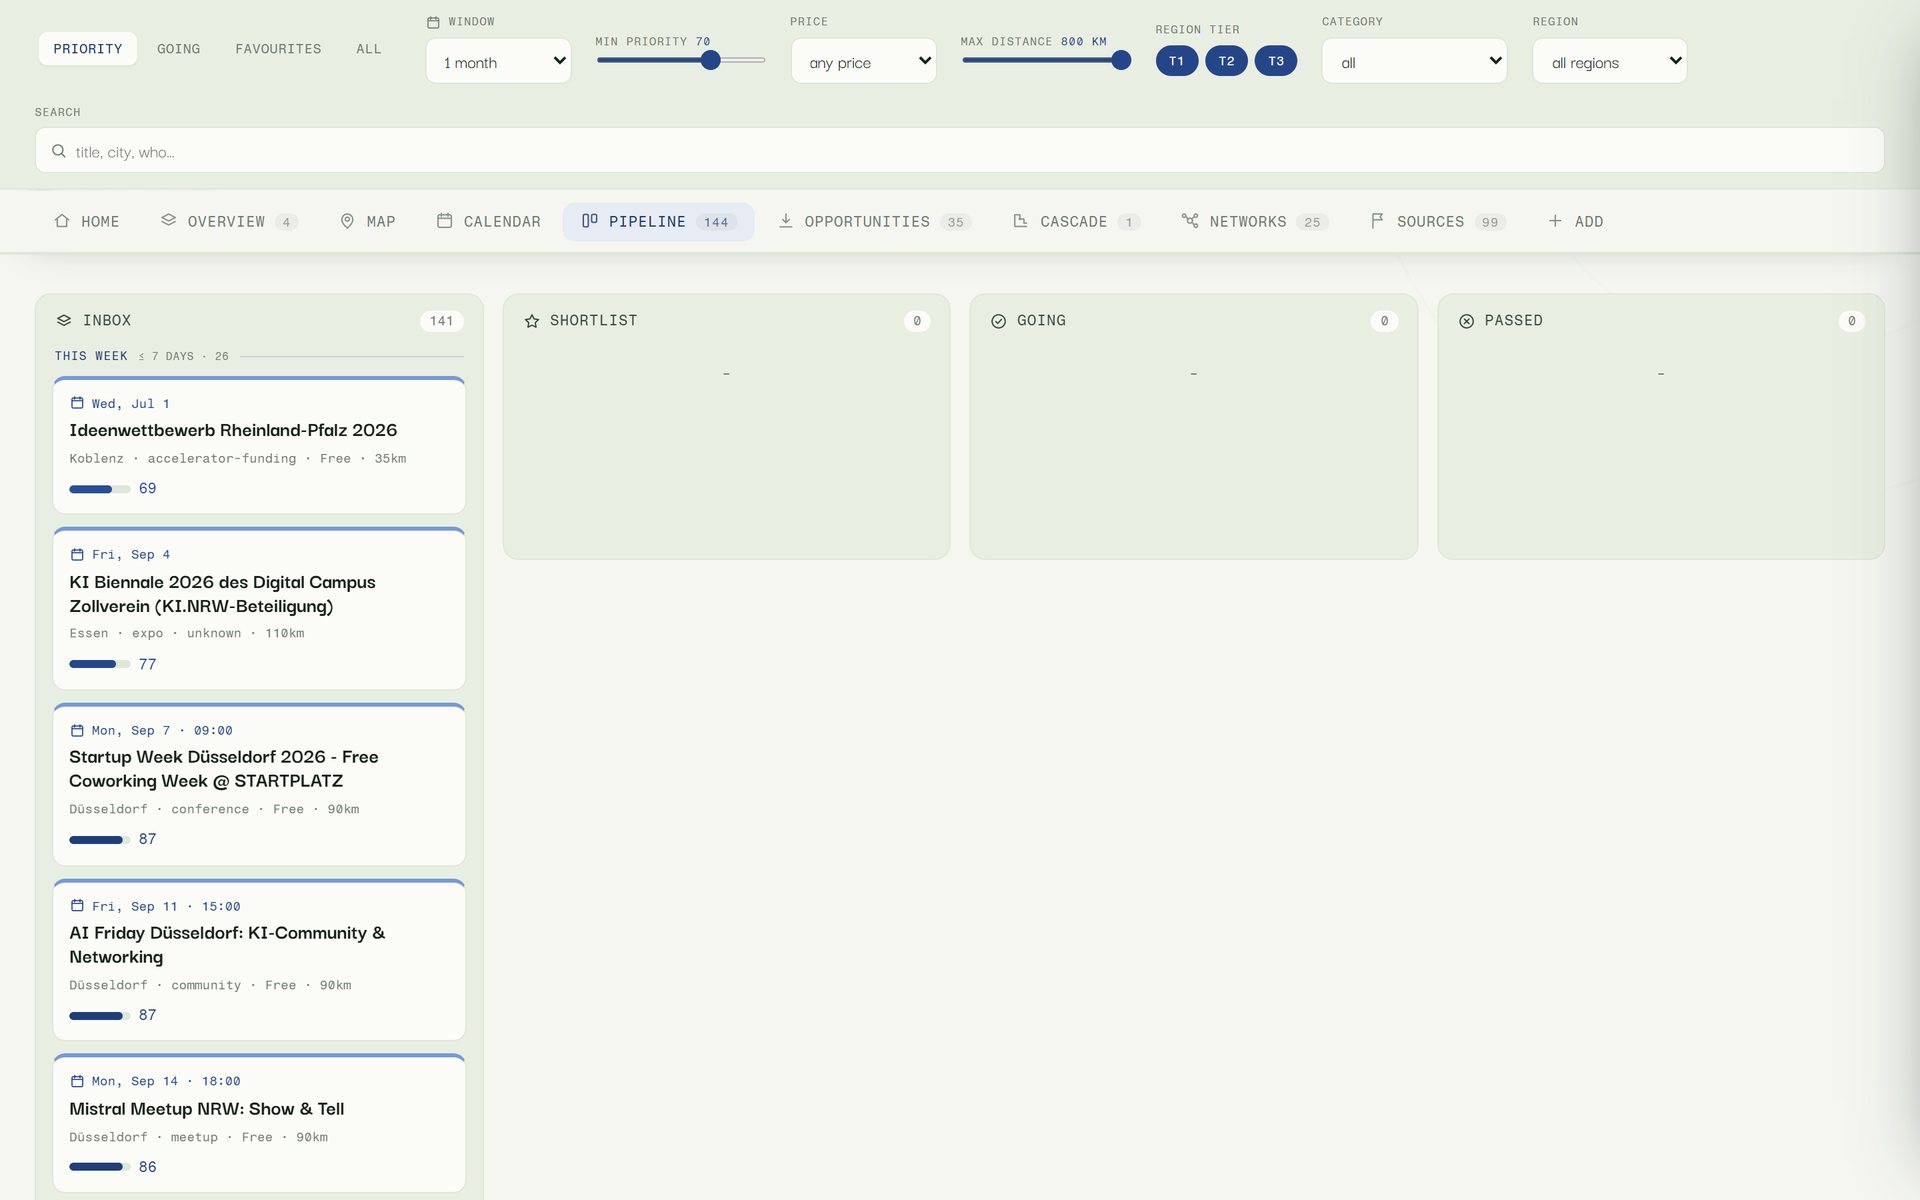
La note ne reste pas un nombre dans un fichier. Sur la page d'accueil et dans le pipeline, elle apparaît comme une barre à côté de chaque événement, dont la longueur et l'intensité de couleur croissent avec la note. Dans l'agenda, les entrées d'un jour sont teintées selon la priorité, et les filtres au-dessus des onglets, dont un curseur de priorité minimale, s'appliquent à toutes les vues à la fois.
Pour savoir pourquoi un événement figure en tête, on ouvre sa vue détaillée. La note y est décomposée : situation et proximité dans le temps de manière exacte, puisqu'elles découlent directement de la formule, le reste comme part commune pour le public, la relation et le levier. S'y ajoutent un renvoi vers la source par laquelle il a été trouvé et une entrée d'agenda préremplie.
La distance comme niveau
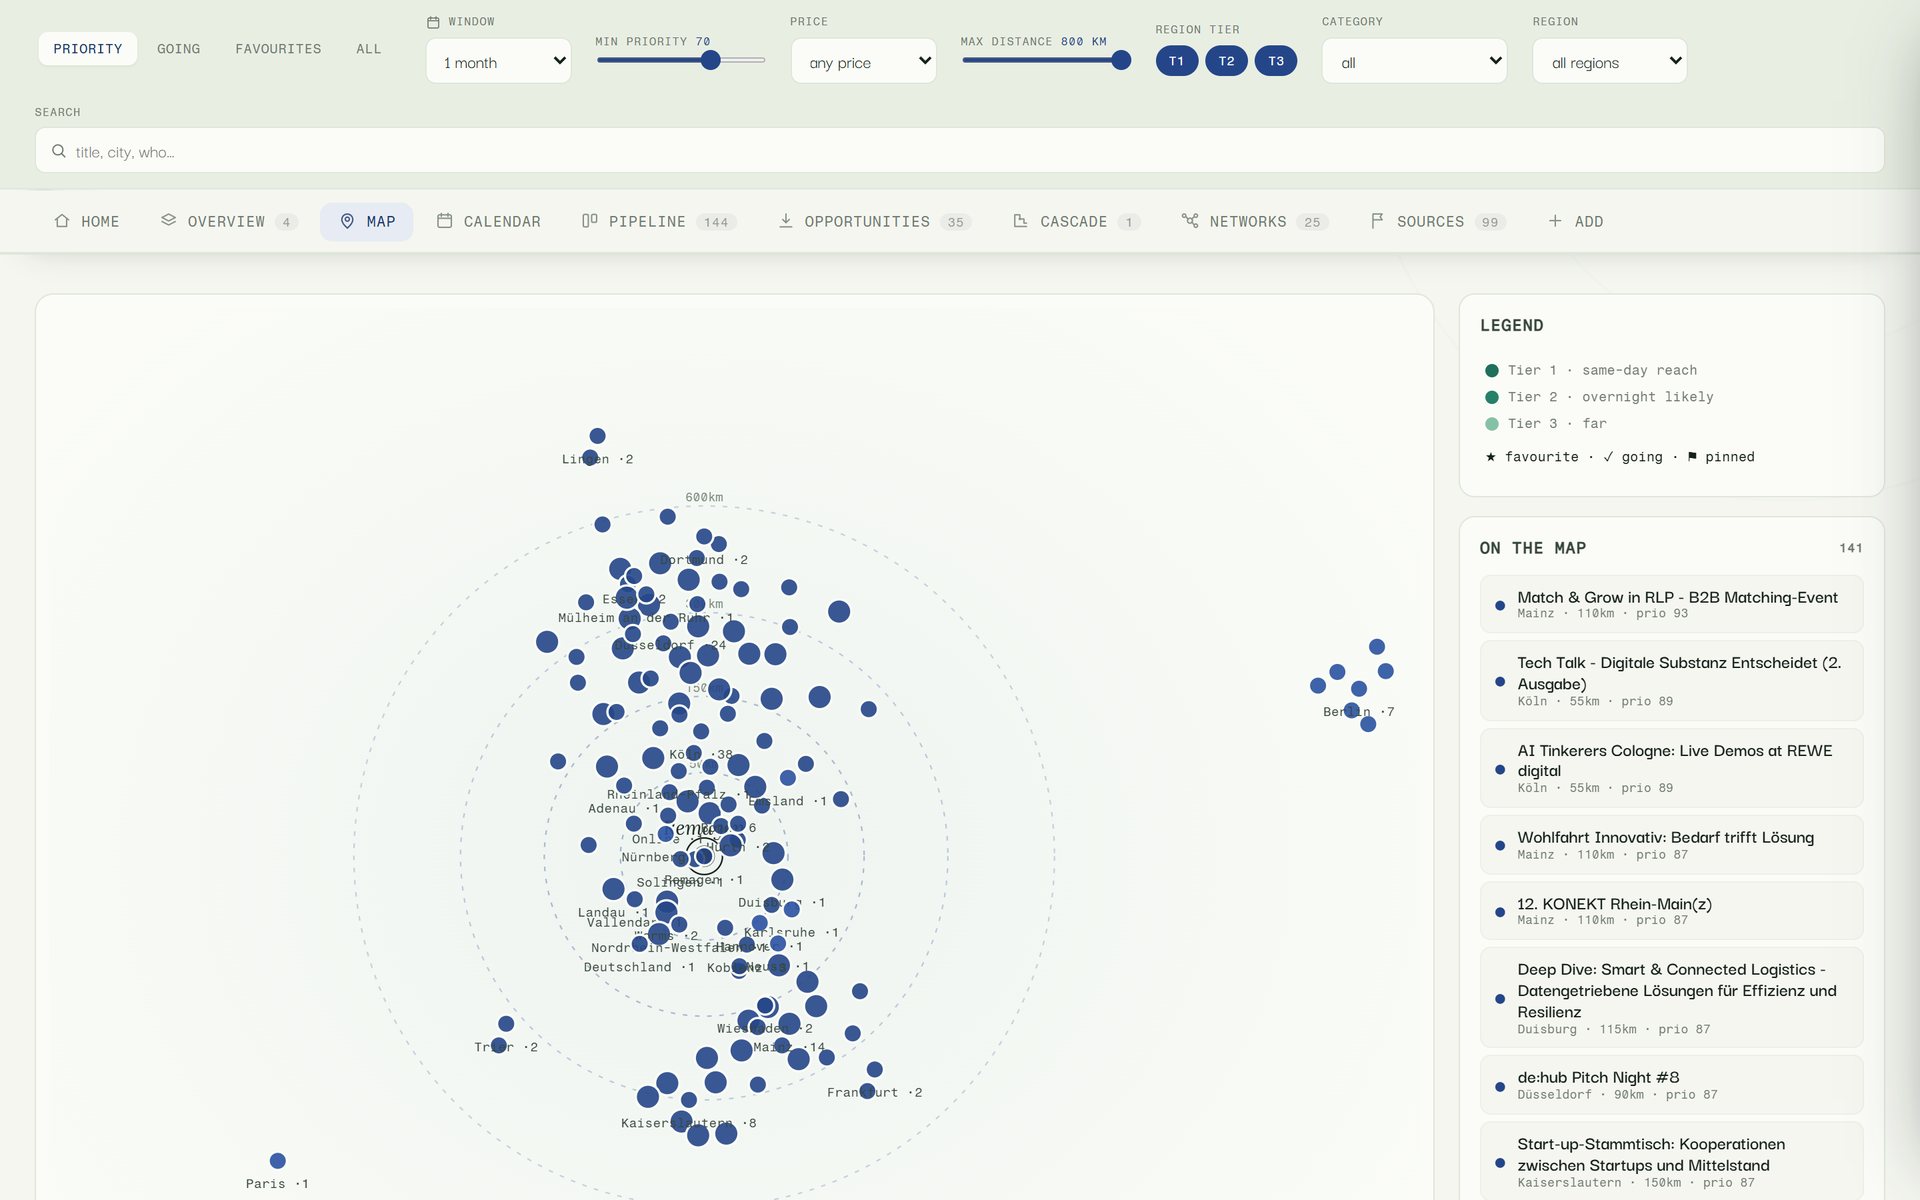
Les anneaux marquent 50, 150, 300 et 600 kilomètres, tracés à intervalles fixes et non à l'échelle. Chaque ville connue a une position fixe, les points d'une même ville se déploient autour d'elle, et les événements bien notés reçoivent un point plus grand. La liste de droite classe la même sélection par priorité.
Pour la notation, ce n'est pas le nombre de kilomètres qui compte, mais le niveau. Le niveau 1 couvre la Rhénanie-Palatinat, la Rhénanie-du-Nord-Westphalie et la Hesse avec leurs environs, des destinations accessibles en aller-retour dans la journée. Le niveau 2 s'étend au reste de l'Allemagne, au Luxembourg, à la Suisse et à la France ; le niveau 3 est le reste de l'Europe, retenu seulement pour des occasions exceptionnelles. Les temps de trajet proviennent d'une table de villes fournie.
Planification
Les sources méritent la fréquence à laquelle on les consulte
Une source consultée chaque semaine avec la même minutie coûte du temps, même si elle n'a rien livré d'utile depuis des mois. Chaque source tient donc un court historique de rendement : combien d'événements le modèle en a retenus lors des cinq dernières exécutions. La moyenne la place dans l'une de trois bandes. Le jugement du modèle ne pilote ainsi la planification qu'à travers un nombre compté.
La bande A est consultée à chaque exécution. Elle réunit les sources dont la moyenne atteint au moins trois événements retenus et celles jugées particulièrement importantes, même après une exécution vide. La bande B contient les sources ayant un certain rendement ou encore sans historique ; elles redeviennent dues après sept jours, huit au plus par exécution, les plus anciennes d'abord. La bande C regroupe les sources qui ne livrent rien à répétition. Elles sont mises en pause sept, puis quatorze, puis vingt-huit jours, trente au plus, puis réessayées, trois au plus par exécution.
Une page qui se charge mais ne montre aucun événement ne fait que reculer dans l'ordre. Une source n'est considérée comme défectueuse qu'après trois échecs de récupération consécutifs. Les nouvelles sources proviennent notamment d'un registre de réseaux publics, d'accélérateurs, d'instituts de recherche et de clusters de la région : si une organisation y dispose d'une page d'événements absente de la base de sources, celle-ci peut être ajoutée. Le registre lui-même n'est jamais lu comme source d'événements, afin que rien ne soit compté deux fois.
Les décisions humaines reviennent dans le même registre
Ce que quelqu'un compte faire d'un événement n'est pas décidé par un modèle. Dans la vue pipeline, une carte se glisse de la boîte d'entrée vers la présélection, la participation ou le refus ; dans les listes, on peut aussi marquer des événements comme favoris, les épingler ou les archiver.
Le tableau de bord est un fichier HTML unique sans serveur ; ces décisions résident donc d'abord dans le navigateur. Un bouton les exporte sous forme de fichier d'état, et l'exécution suivante les intègre dans events.json avant toute récupération : participation, favori, archive, épinglage, événements ajoutés à la main et nouvelles sources proposées.
Les favoris sont exclus du nettoyage et restent dans le registre même après des années. Une date épinglée apparaît sur la page d'accueil quelle que soit sa note, et aucune de ces marques ne modifie la note de priorité elle-même.
Un jeu de données, trois lectures
Les mêmes événements en liste, carte et calendrier
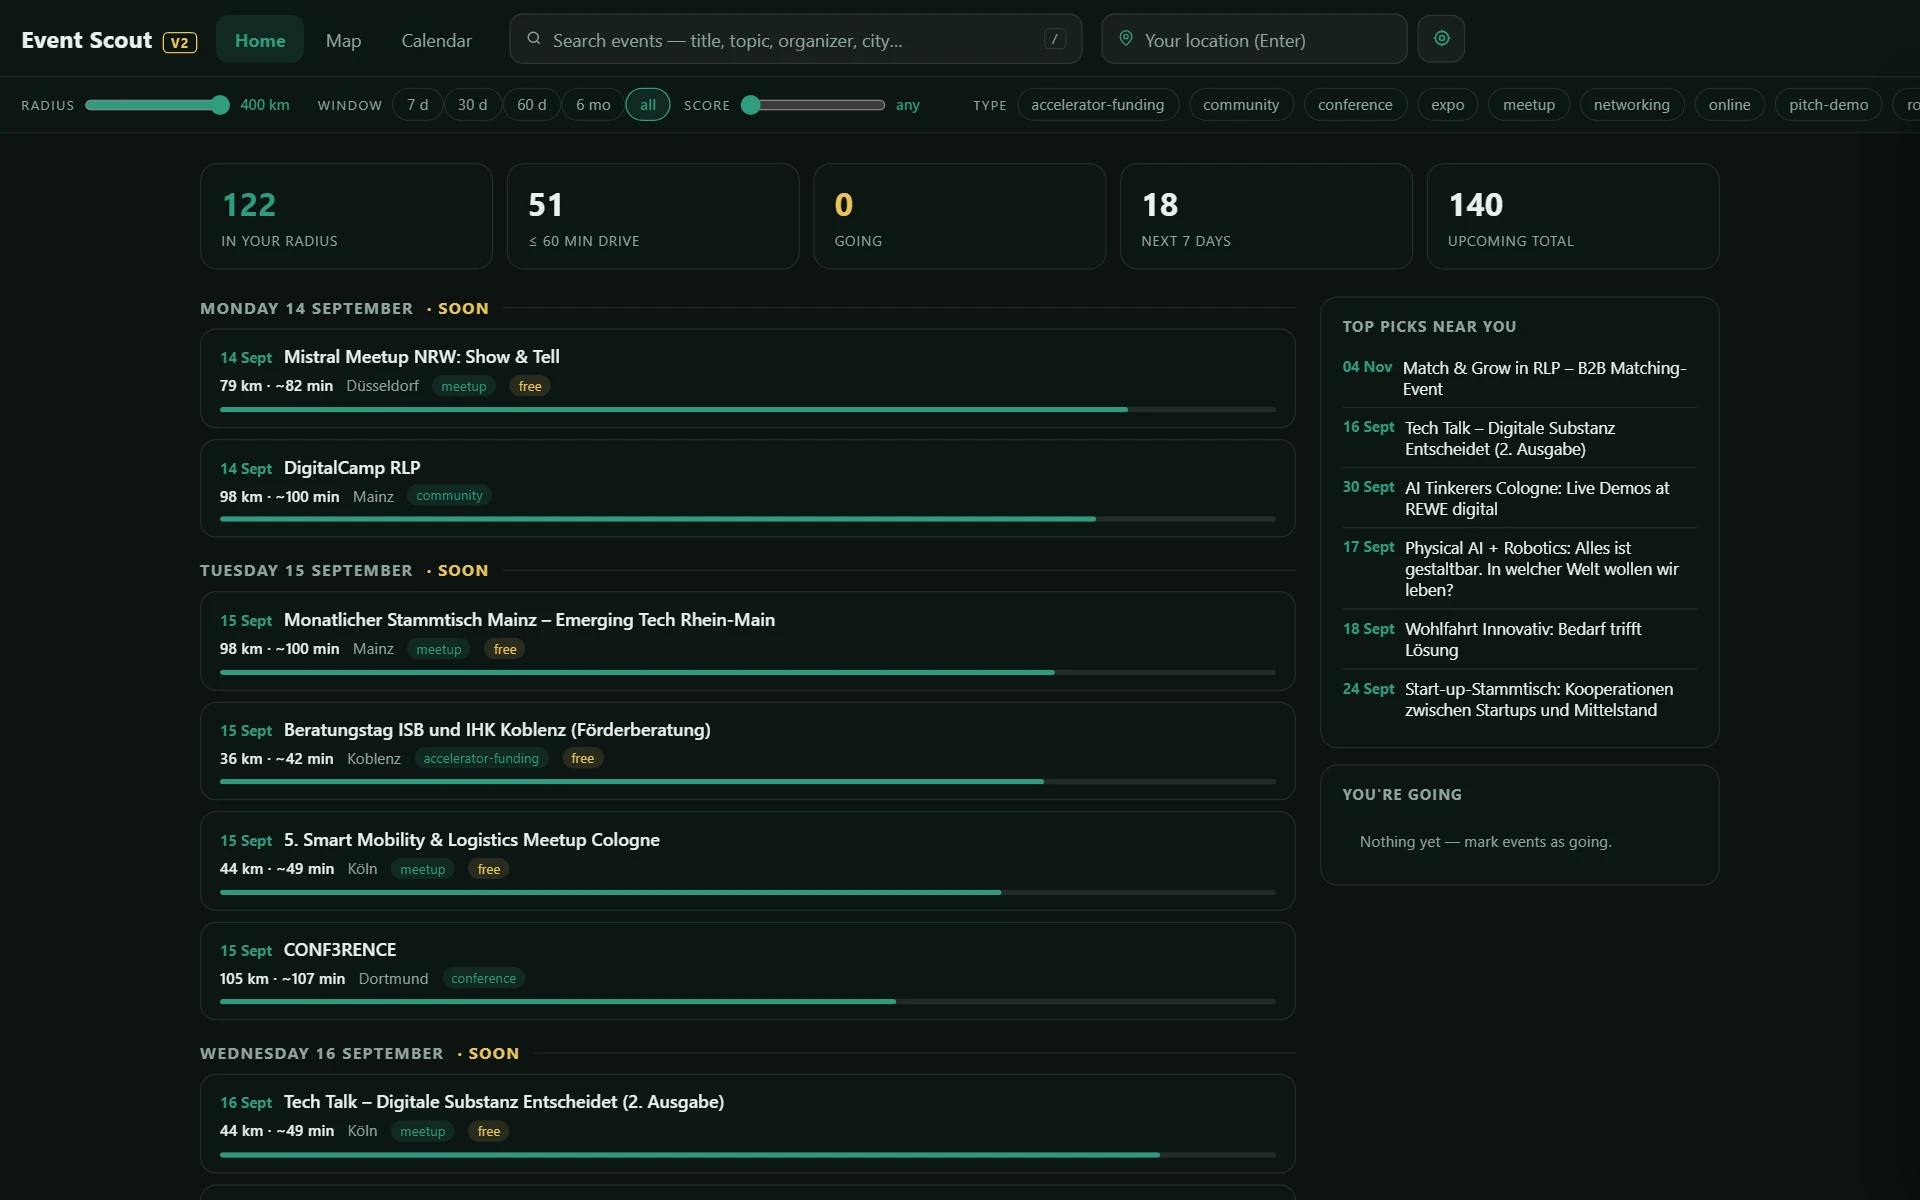
ListeLes trois vues montrent le même jeu de données filtré. Le rayon, la fenêtre temporelle et la pertinence minimale en haut valent pour la liste, la carte et le calendrier.
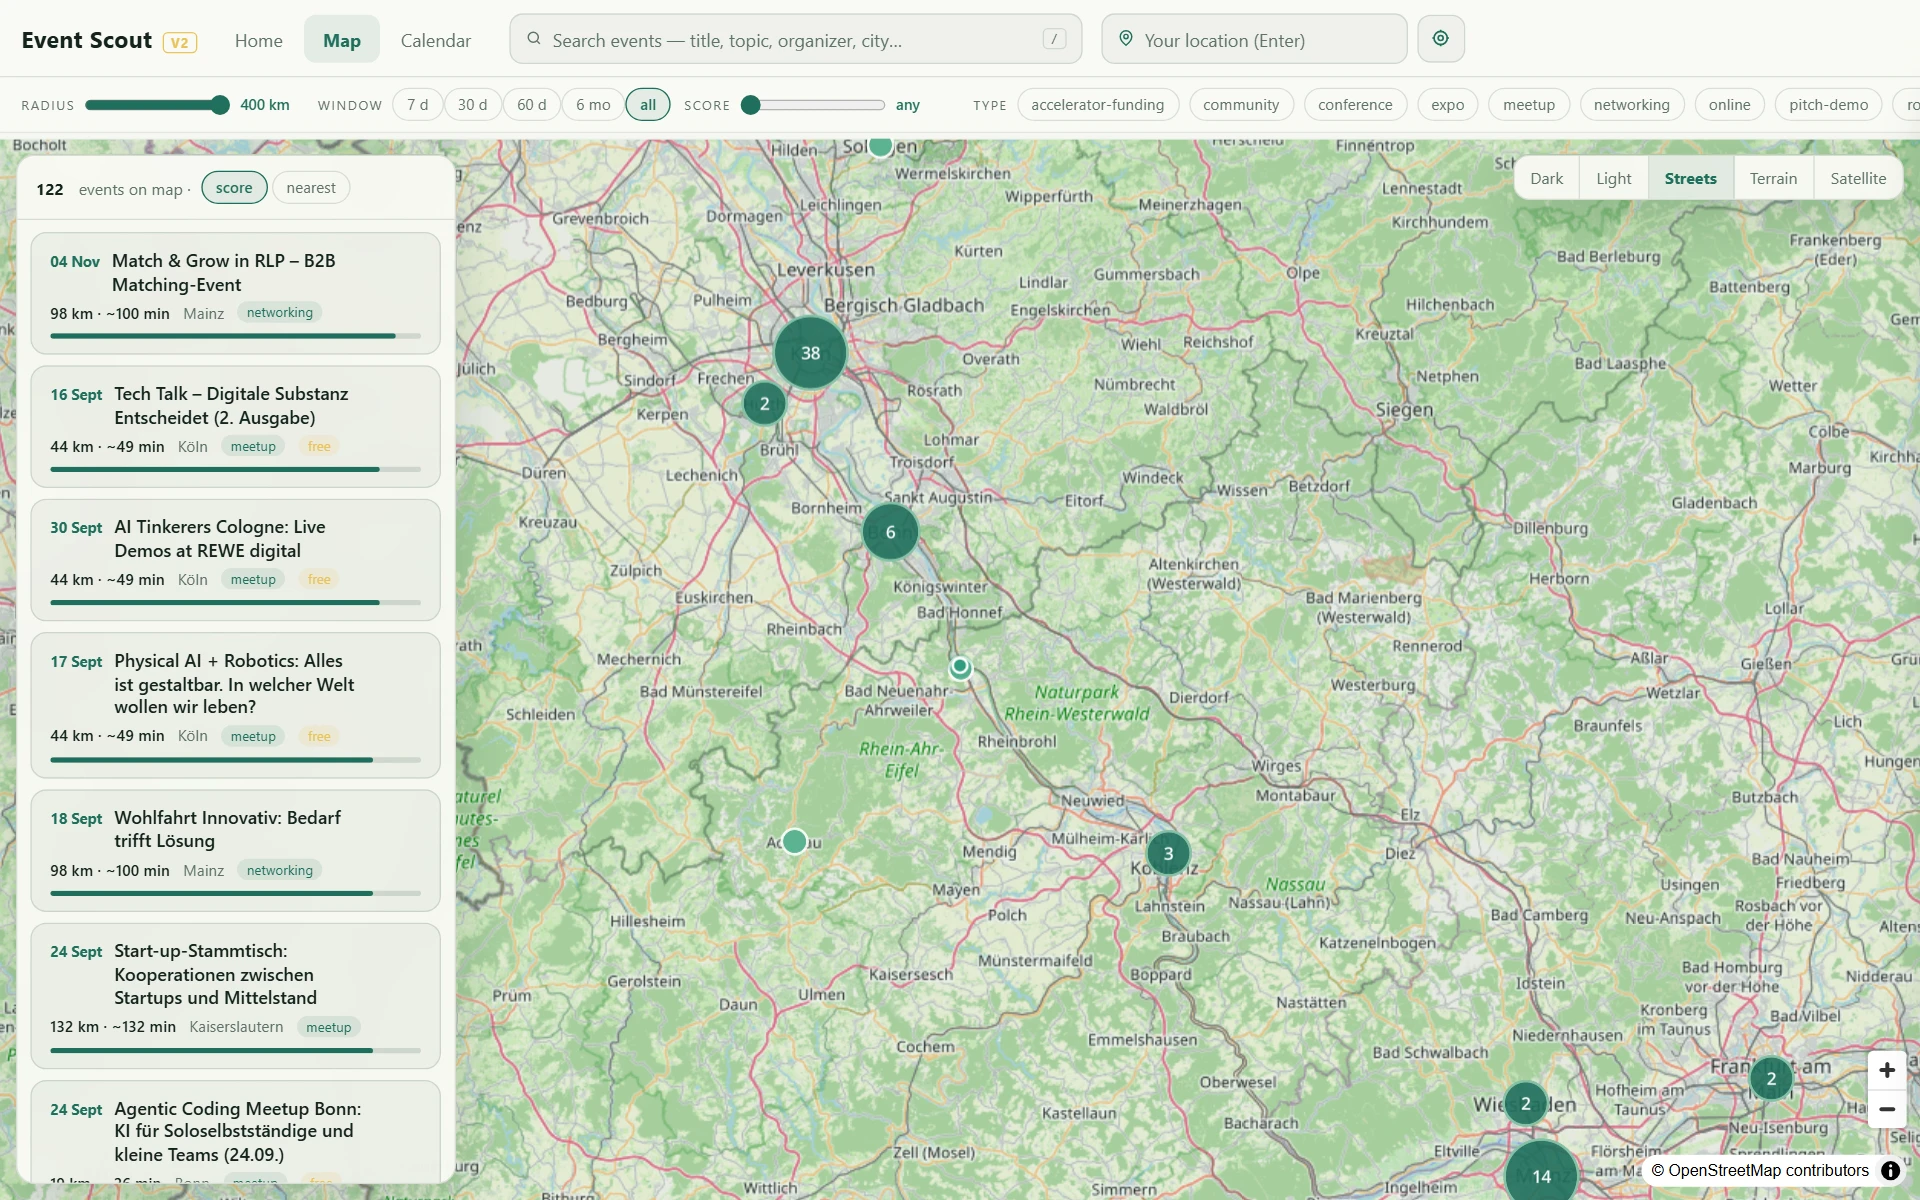
CarteLes amas montrent d'un coup d'œil où les événements se concentrent : Cologne et Bonn portent les plus grands nombres, la vallée de l'Ahr et Coblence les plus petits.
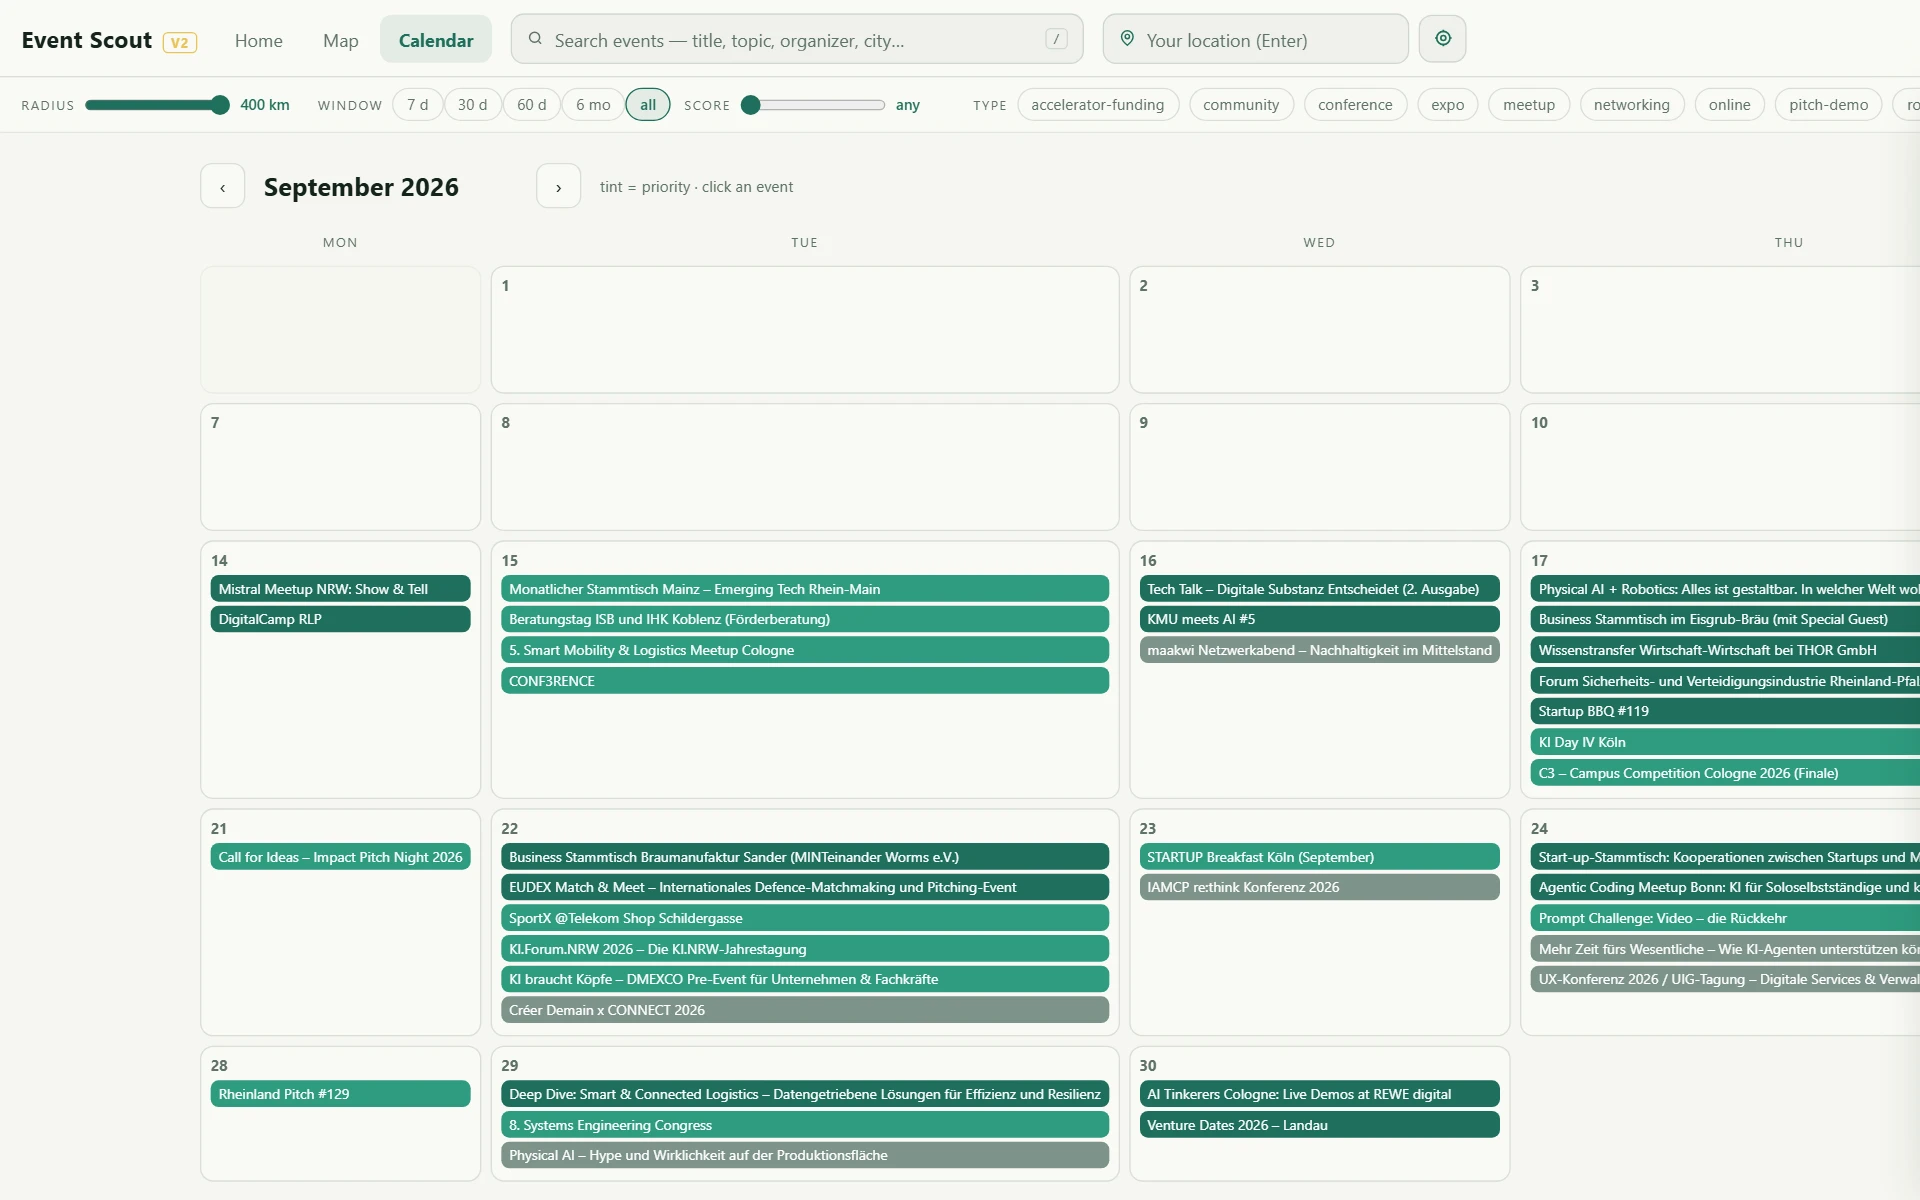
CalendrierLe calendrier est en clair, la liste et la carte en sombre : la même interface adaptée à chaque tâche, sans que les données changent.
Où la même construction s'applique
- Passer en revue les appels d'offres publics de plusieurs plateformes et les classer selon vos propres critères.
- Suivre les évolutions de normes, de directives ou de documentation fournisseur sur de nombreux sites d'éditeurs.
- Veille marché et concurrence à partir de communiqués, de pages produits et d'agendas professionnels.
- Réunir les listes d'exposants et de fournisseurs de différents salons dans un registre commun et dédoublonné.
- Toute veille récurrente pour laquelle quelqu'un ouvre aujourd'hui les mêmes pages à la main chaque semaine.
Crédits images : toutes les images sont des captures de notre propre application, réalisées à partir d'une copie nettoyée du registre. Les événements visibles sont des dates annoncées publiquement par leurs organisateurs respectifs.
Pourquoi c'est publié
Ce que cela signifie pour votre projet
Plus du laboratoire
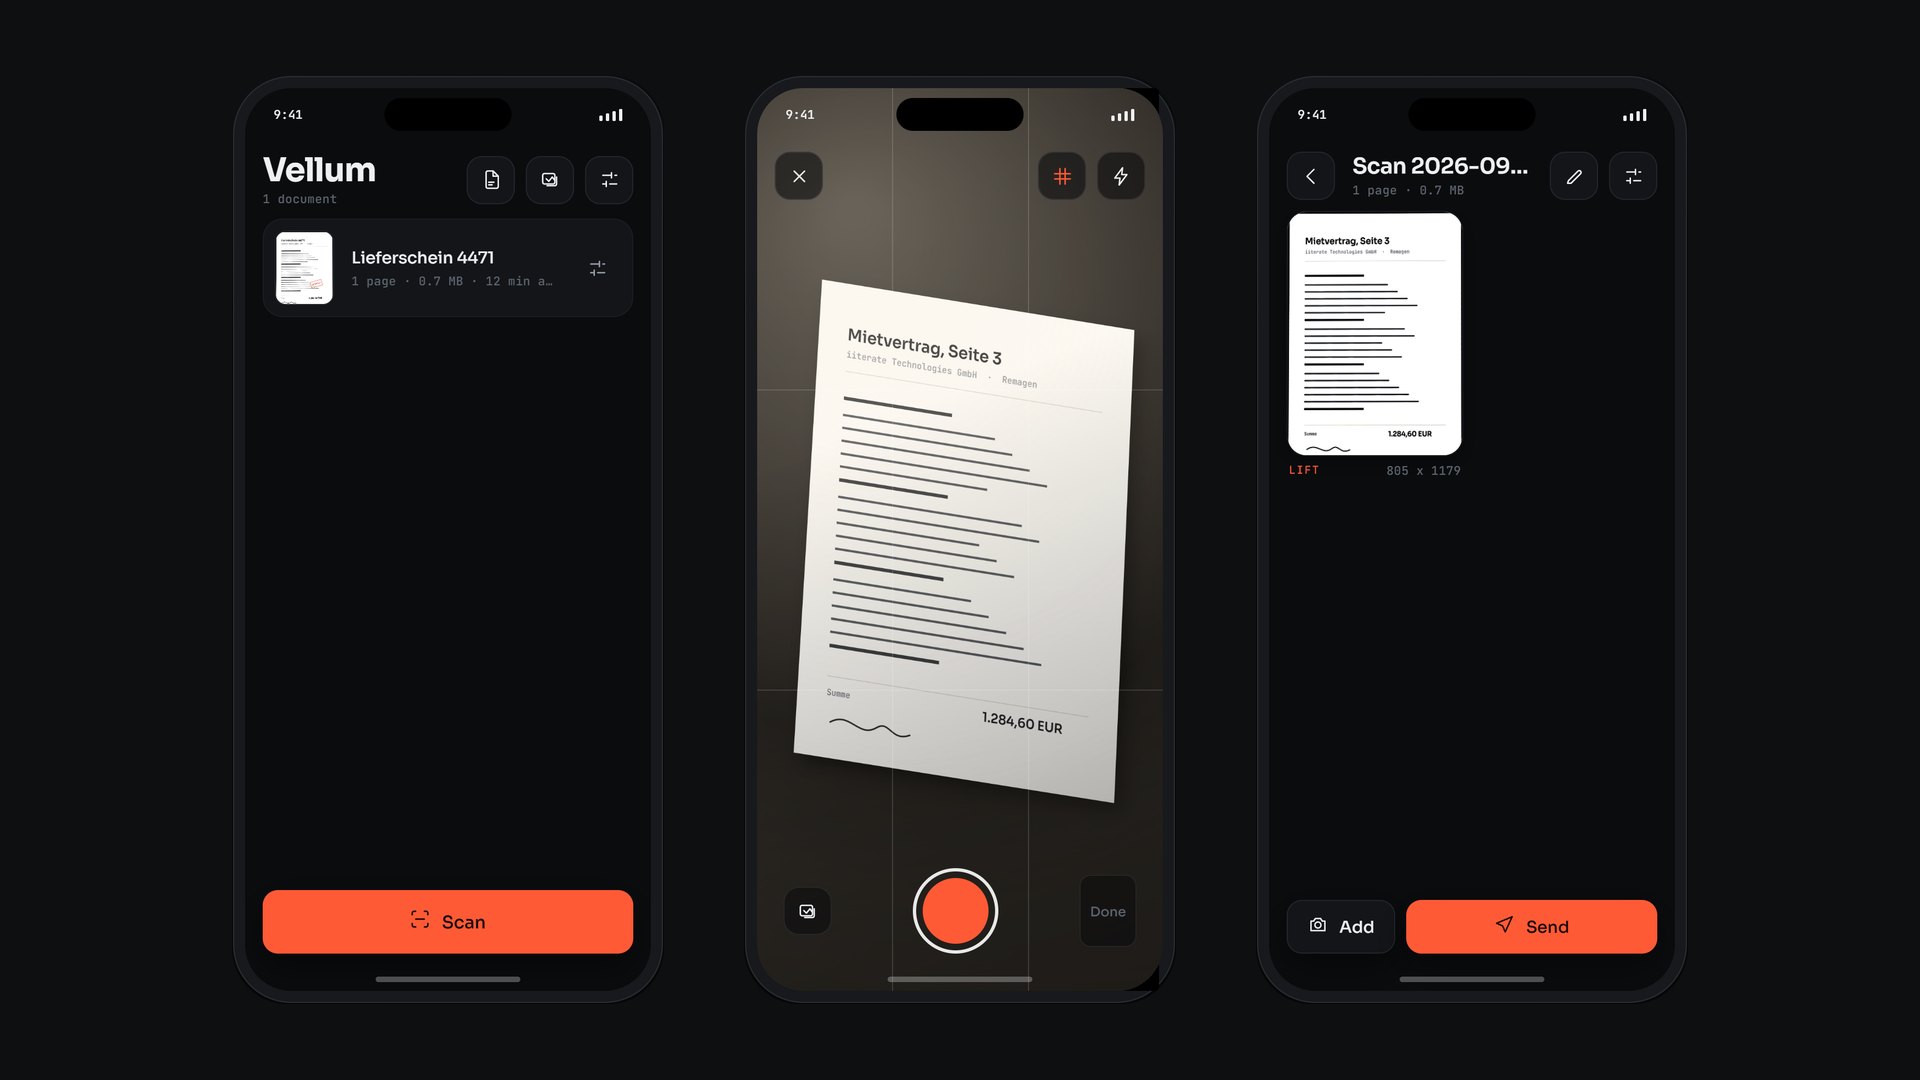 Recherche appliquée Vellum Bords, perspective, lumière et texte sont calculés sur le téléphone. Un document ne quitte l'appareil que lorsque quelqu'un l'envoie.
 Design computationnel Atlas EV1 Douze chapitres démontent une voiture électrique, jusqu'à une cellule. Aucun fichier de modèle, aucune texture : 327 pièces issues d'un tableau.
 Méthode Contradiction Indiquez ce qui doit s'améliorer et ce qui se dégrade en même temps. Vous obtenez les principes qui ont résolu exactement cette paire, et les inventions qui l'ont fait.
Quelqu'un chez vous ouvre-t-il chaque semaine les mêmes pages pour tenir une liste à jour ? C'est précisément à cela que sert un pilote.
Nous contacter