

R&D LAB Método En uso Construido para nuestro propio desarrollo comercial
Event Scout
Una pipeline agéntica para eventos presenciales de la región
Un modelo de lenguaje lee las páginas de eventos; todo lo demás es código fijo. Queda una lista breve de dónde merece la pena un día presencial.
- 5componentes ponderados en la puntuación de prioridad
- 3niveles de distancia alrededor de la sede
- 3bandas de consulta, guiadas por el rendimiento de cada fuente
- 0servidores de base de datos: el registro es un archivo JSON
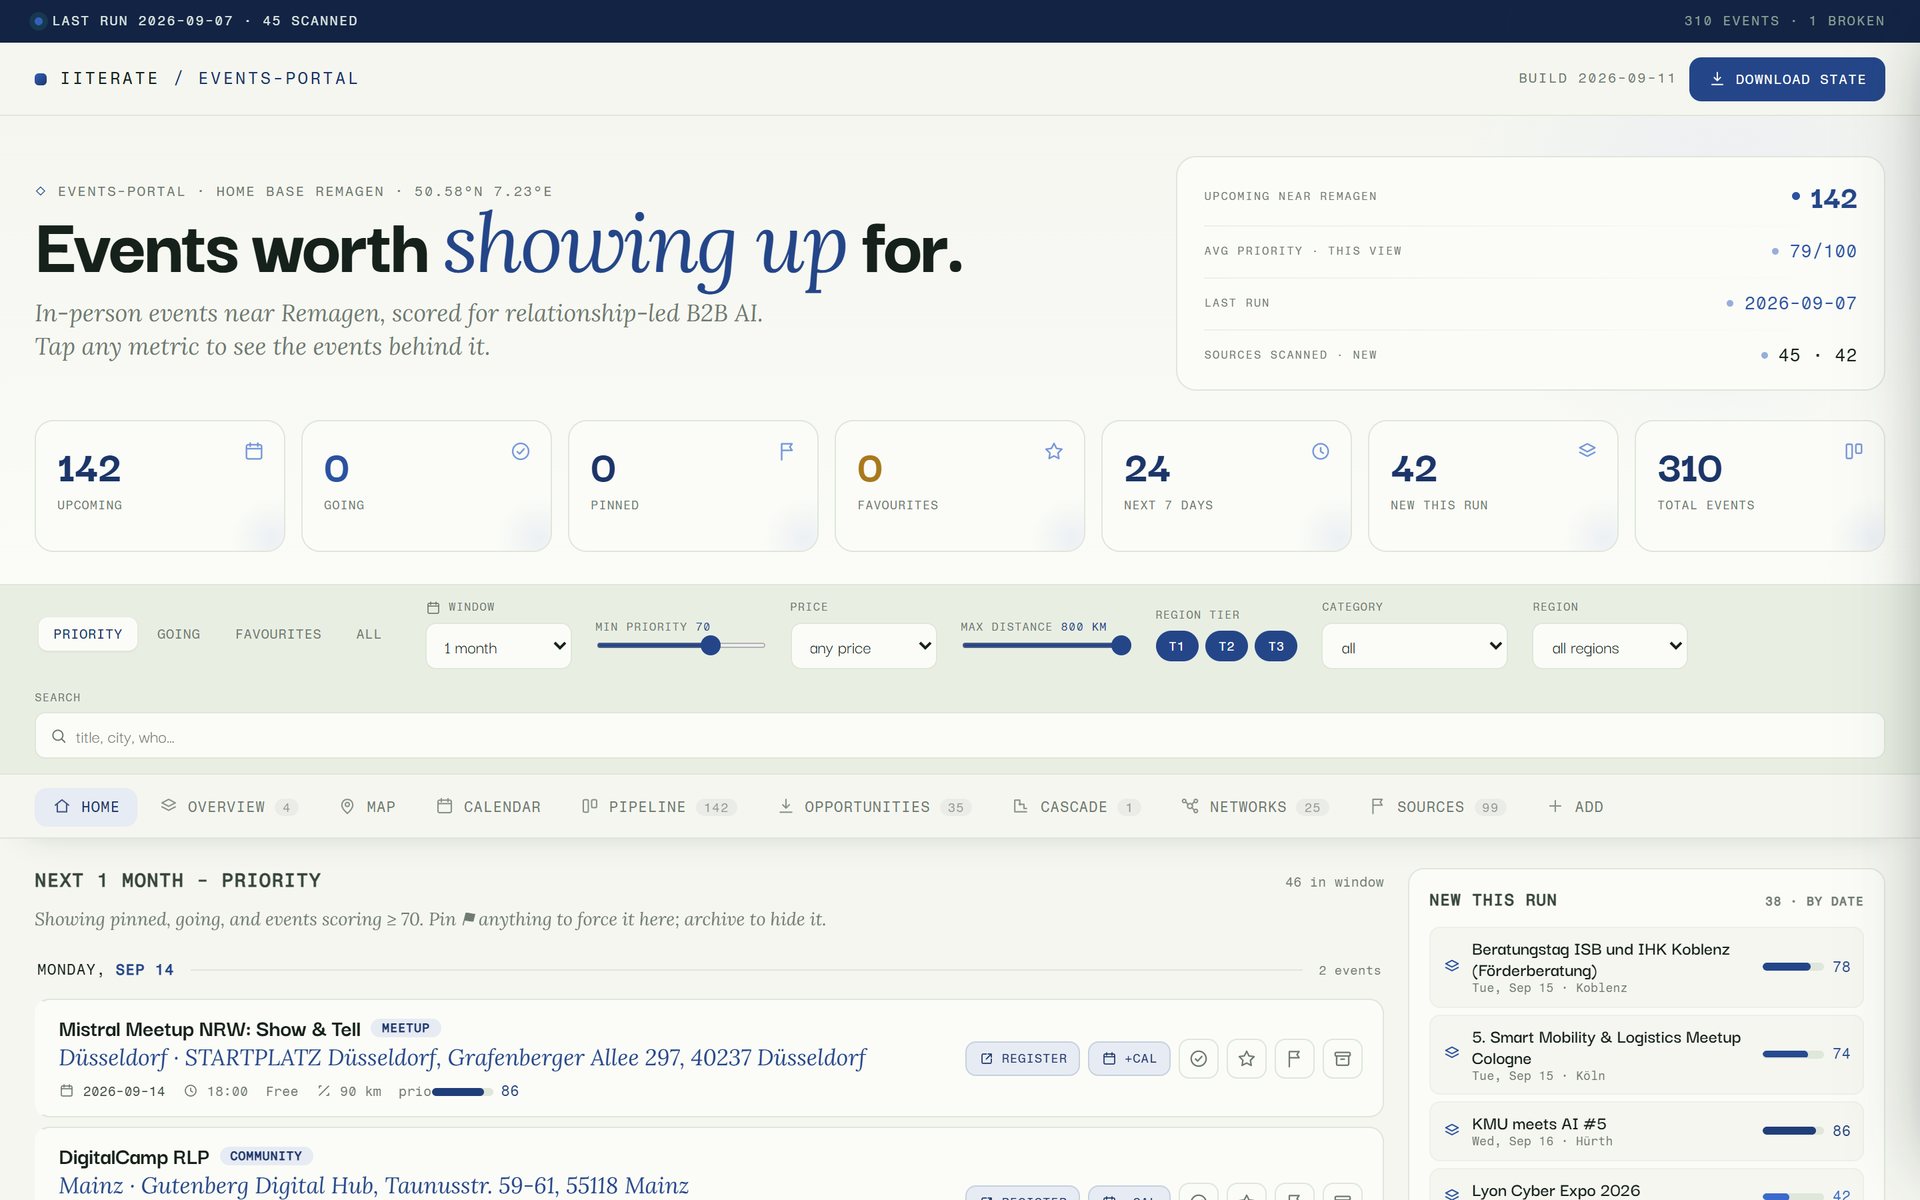
Vista de inicio a partir de una copia depurada del registro. Asistencia y favoritos marcan cero porque esas marcas se eliminaron antes de la captura.
Por qué se publica
Vendemos IA y software. Event Scout es la prueba de la pregunta que llega primero en cualquier proyecto agéntico: cómo encajar un modelo de lenguaje en un proceso del que uno puede fiarse cada semana. La respuesta aquí es un reparto de tareas. Descarga, planificación, deduplicación, limpieza y fórmula de puntuación son código fijo, el modelo asume el único paso que exige leer, y un archivo con un esquema fijo es el contrato entre ambos. Si quiere automatizar una revisión recurrente en su propia organización, aquí ve dónde trazamos esa línea.
Los eventos donde de verdad se conoce a clientes no están reunidos en un solo sitio. Se reparten entre los calendarios de cámaras y redes, boletines, grupos de meetup y páginas de universidades, cada uno con su formato, muchos legibles solo después de que un script cargue la lista. Revisar todo eso a mano cada semana es justo el tipo de tarea que acaba quedándose sin hacer. Event Scout es la pipeline que se encarga por nosotros: mantiene una base de datos seleccionada de esas fuentes, descarga en un lote las que tocan, hace que un modelo de lenguaje extraiga solo eventos presenciales futuros al alcance de la sede, los puntúa para una venta B2B basada en la relación, los fusiona en un único registro y reconstruye a partir de él un panel autónomo.
La decisión
El modelo lee, el código lleva el registro
Una página de eventos es un mal formato de datos. El mismo dato aparece una vez como tabla, otra en el texto de un boletín, otra en un calendario que solo carga al desplazarse. Una expresión regular fracasa ahí; un modelo de lenguaje no. Justo ahí, y solo ahí, se sitúa por tanto el modelo: lee las páginas descargadas, decide qué es un evento presencial futuro al alcance y rellena para cada uno los campos de un esquema fijo.
Todo lo anterior y lo posterior es código corriente. Qué fuentes tocan hoy, cómo se descargan, cuándo dos entradas son el mismo evento, qué sale del registro al cabo de un año y qué aspecto tiene el panel están escritos en el código, no en una instrucción al modelo. El modelo tampoco escribe él mismo en el registro. Entrega un archivo, y un script lo incorpora a events.json según reglas fijas.
Ese archivo es el contrato. Tiene un esquema definido, es la única fuente de verdad y todas las vistas se generan a partir de él. No hay base de datos, ni servidor, ni suscripción. De ello se deriva la ventaja práctica más importante: cuando algo parece incorrecto, se puede abrir el archivo y ver si el error está en la lectura o en las reglas.
Que las reglas sean código no las hace correctas. La primera versión de la deduplicación consideraba dos entradas el mismo evento en cuanto llevaban el mismo enlace. Pero muchos organizadores publican todas las fechas de una serie bajo una única página de resumen, y así, en una sola ejecución, 23 fechas nuevas desaparecieron dentro de sus predecesoras más antiguas. Se detectó porque el fallo dejó un rastro comprobable: eventos pasados marcados como encontrados de nuevo ese mismo día. Desde entonces, un enlace igual solo cuenta como coincidencia si las fechas de inicio distan tres días como máximo.
Un modelo de lenguaje sabe leer bien una página desordenada. Llevar un registro no es una tarea de ese tipo.
Una ejecución
De la lista de fuentes al panel
- 01 Planificar Un script lee la base de datos de fuentes y decide, según los rendimientos anteriores, qué fuentes tocan en esta ejecución. El plan puede mostrarse de antemano, con el motivo de cada fuente omitida.
- 02 Descargar Cada fuente que toca se renderiza en un navegador sin interfaz y se desplaza hasta el final para que las listas de carga diferida estén completas. Se guardan el texto legible y, cuando la página los ofrece, los datos estructurados schema.org Event, además de un registro por fuente.
- 03 Leer El modelo de lenguaje lee las páginas guardadas, primero los datos estructurados. Solo conserva eventos presenciales futuros al alcance, y citas solo en línea únicamente si tema y público encajan claramente. Para cada uno rellena fecha, lugar, precio, enlaces, un breve resumen y el motivo de su relevancia.
- 04 Puntuar Cada evento recibe una puntuación de prioridad de 0 a 100 compuesta por cinco componentes ponderados. Los pesos son fijos; el nivel que alcanza un público o un formato lo estima el modelo al leer.
- 05 Fusionar Un script incorpora las nuevas entradas. El mismo enlace con fechas de inicio separadas como máximo tres días, o el mismo título normalizado con la misma fecha de inicio, cuenta como duplicado: la entrada guardada se mantiene y se completan los campos vacíos. Una nueva fecha de una serie es una entrada nueva.
- 06 Limpiar y construir Lo que pasó hace más de un año y no está marcado como favorito pasa a un registro de limpieza. El número de eventos conservados por fuente vuelve al planificador, y después se regeneran el panel y una versión de texto legible del registro.
Quién decide qué
Código fijo
- Qué fuentes tocan en una ejecución y en qué orden.
- La descarga, el desplazamiento y el guardado de texto y datos estructurados.
- Los pesos de la fórmula de puntuación y el tope para formatos caros sin palanca.
- Las distancias a ciudades conocidas, desde una tabla incluida.
- La deduplicación, la limpieza al cabo de un año y la incorporación de decisiones humanas.
- La construcción del panel a partir del archivo de registro.
Modelo de lenguaje
- Si una entrada es realmente un evento, y si es futuro y presencial.
- Fecha, lugar, precio y enlaces a partir de texto heterogéneo.
- El nivel de público, potencial de relación y palanca de acceso que entra en la fórmula.
- Un resumen y la frase sobre por qué el evento es relevante.
- Una distancia estimada cuando una ciudad aún no está en la tabla. Después se añade a ella.
De qué se compone la puntuación de prioridad
La prioridad aparece en cada evento
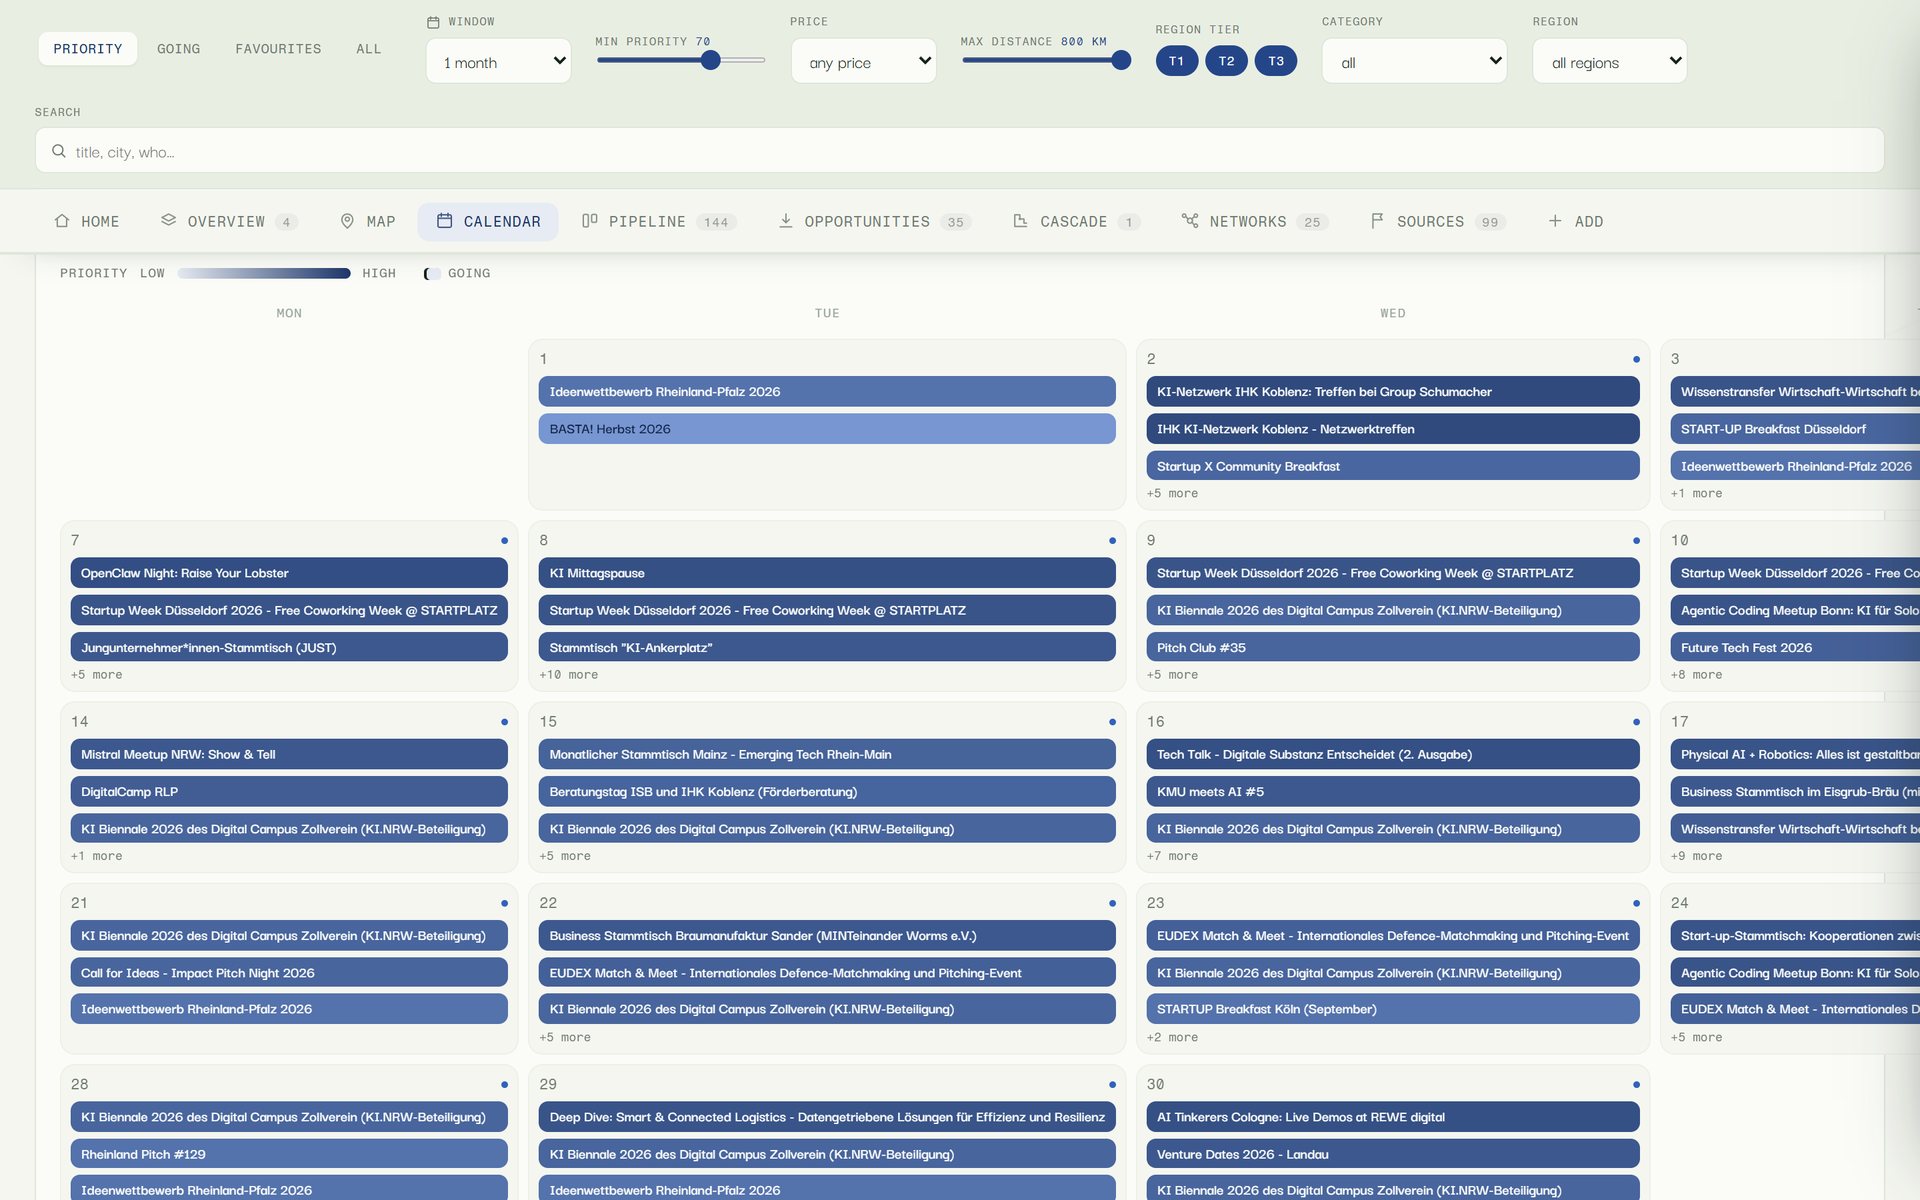
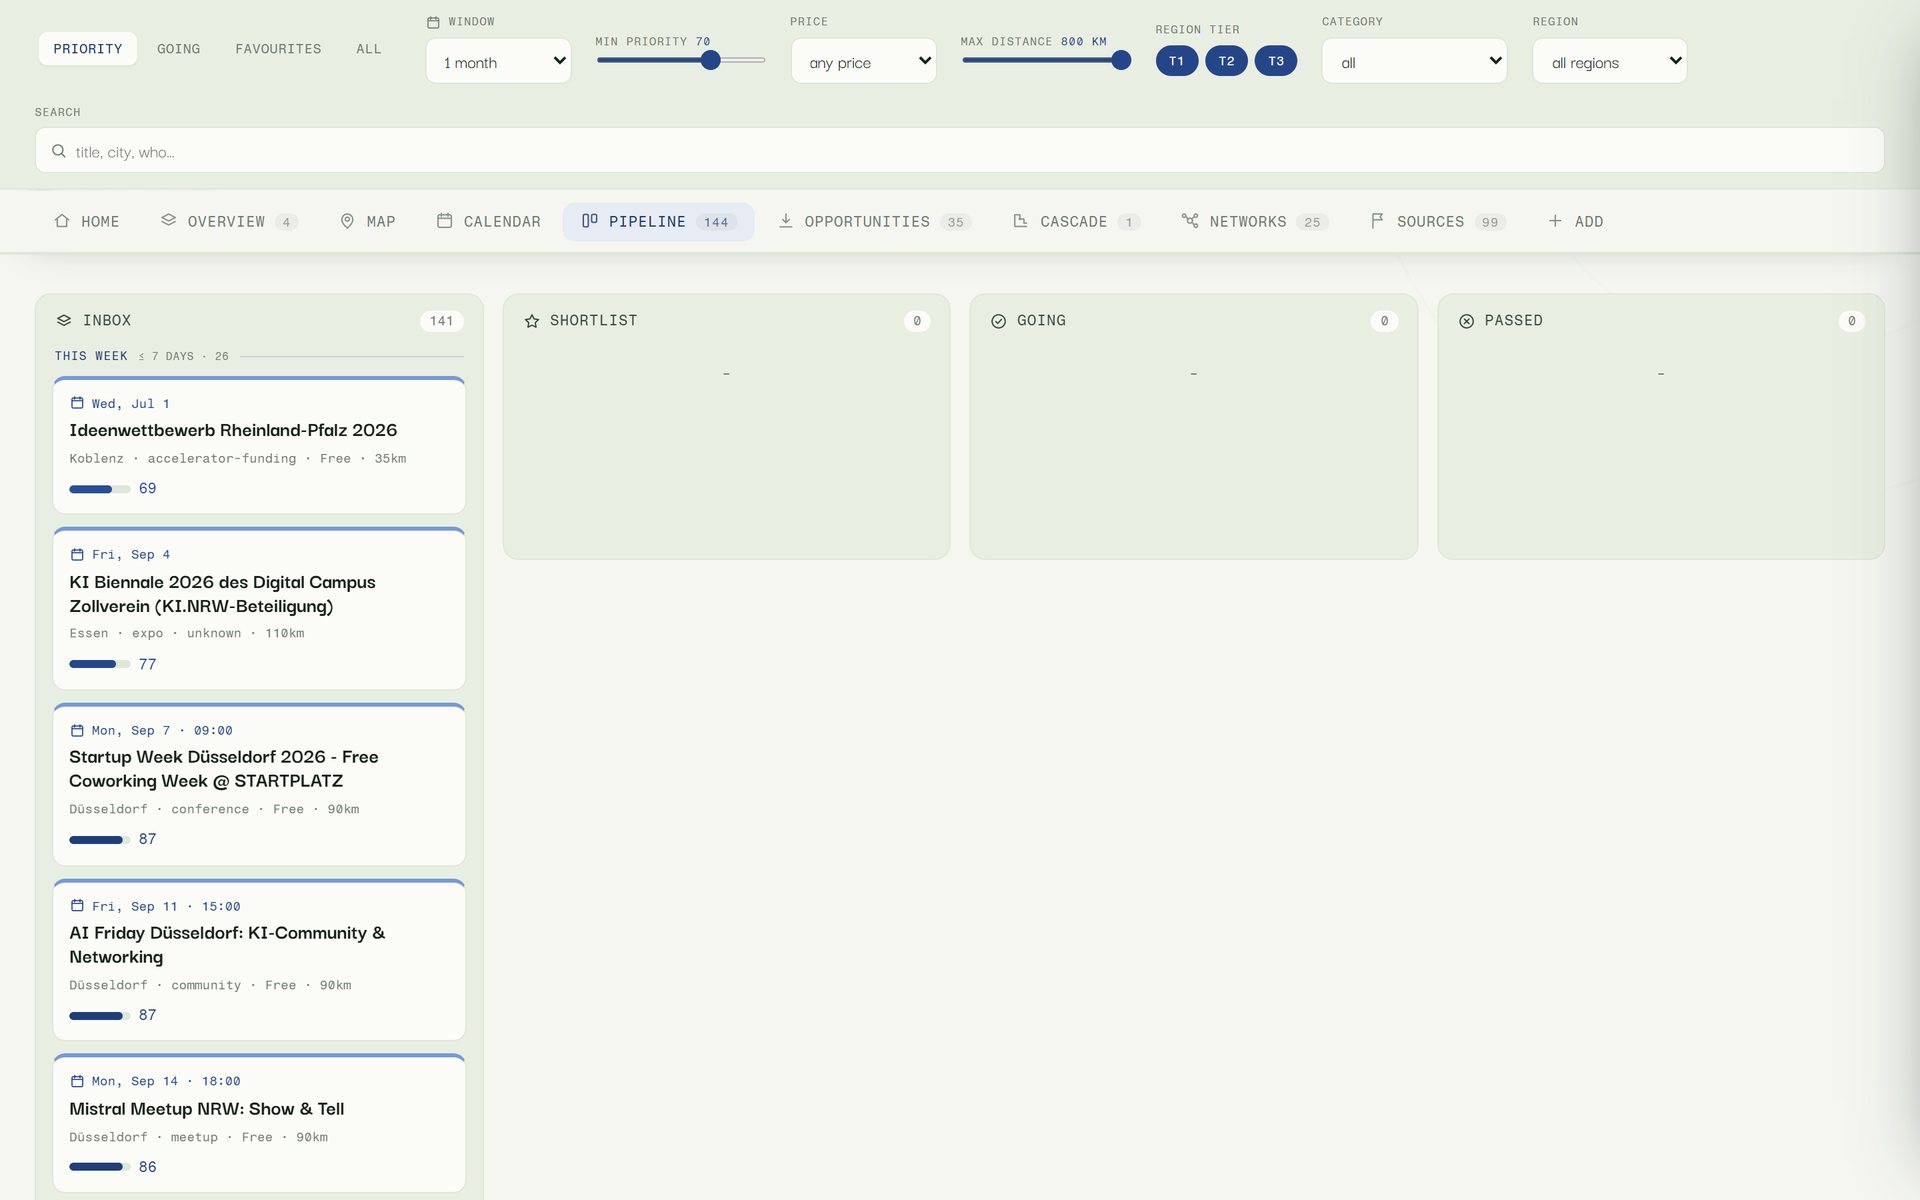
La puntuación no se queda en un número dentro de un archivo. En la vista de inicio y en la pipeline aparece como una barra junto a cada evento, cuya longitud e intensidad de color crecen con la puntuación. En el calendario, las entradas de un día se tiñen según la prioridad, y los filtros situados sobre las pestañas, entre ellos un control de prioridad mínima, se aplican a todas las vistas a la vez.
Quien quiera saber por qué un evento está arriba abre su vista de detalle. Allí la puntuación aparece desglosada: ubicación y proximidad temporal con exactitud, porque se derivan directamente de la fórmula, y el resto como parte conjunta de público, relación y palanca. Se añaden una referencia a la fuente por la que se encontró y una entrada de calendario ya rellenada.
La distancia como nivel
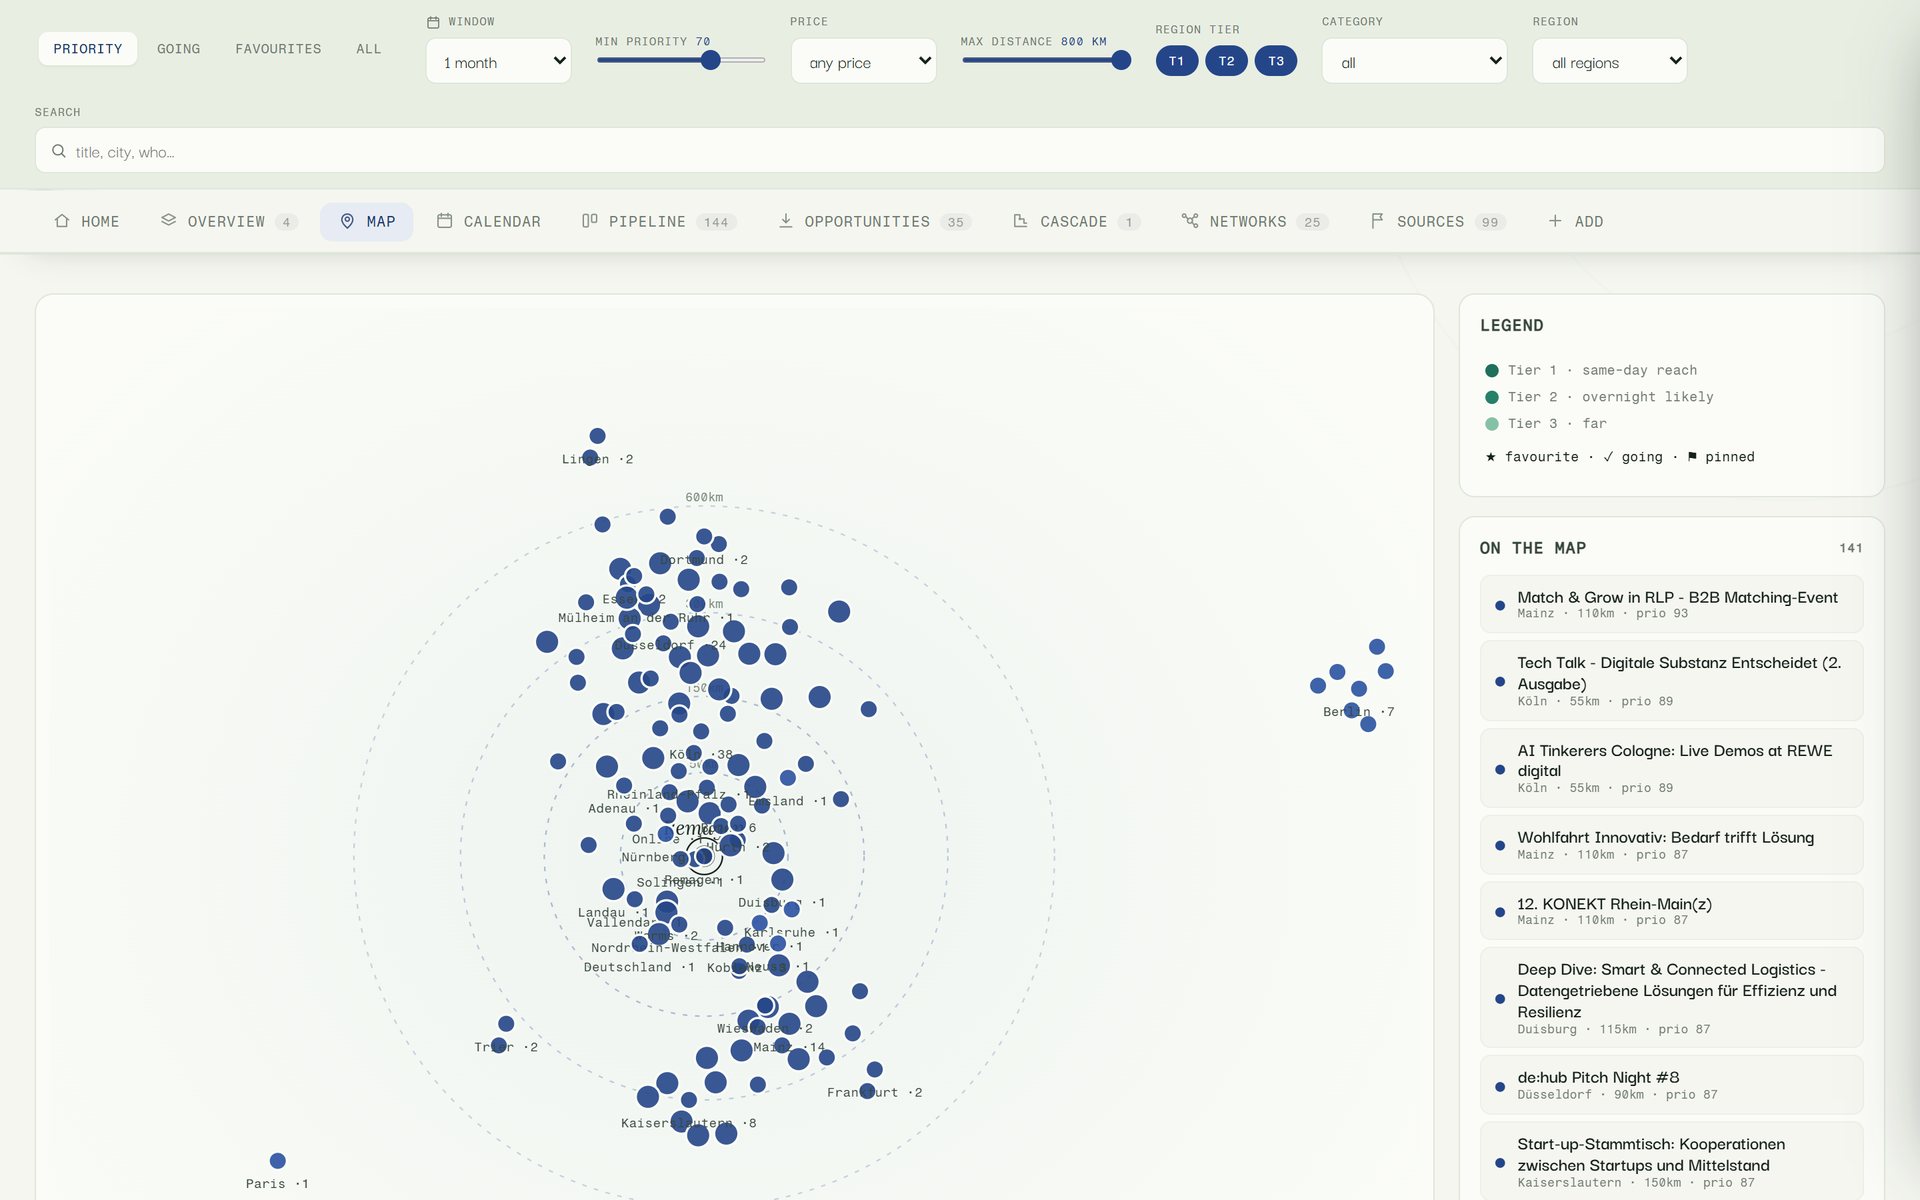
Los anillos marcan 50, 150, 300 y 600 kilómetros, dibujados a intervalos fijos y no a escala. Cada ciudad conocida tiene una posición fija, los puntos de una ciudad se abren en abanico a su alrededor y los eventos con puntuación alta reciben un punto mayor. La lista de la derecha ordena la misma selección por prioridad.
Para la puntuación no cuenta el número de kilómetros sino el nivel. El nivel 1 abarca Renania-Palatinado, Renania del Norte-Westfalia y Hesse con sus alrededores, destinos alcanzables en ida y vuelta en un día. El nivel 2 se extiende por el resto de Alemania hasta Luxemburgo, Suiza y Francia; el nivel 3 es el resto de Europa y solo entra en ocasiones excepcionales. Los tiempos de viaje proceden de una tabla de ciudades incluida.
Planificación
Las fuentes se ganan la frecuencia con que se consultan
Una fuente consultada cada semana con la misma minuciosidad cuesta tiempo aunque lleve meses sin aportar nada útil. Por eso cada fuente lleva un breve historial de rendimiento: cuántos eventos conservó el modelo de ella en las últimas cinco ejecuciones. La media la sitúa en una de tres bandas. El juicio del modelo solo guía la planificación a través de un número contado.
La banda A se consulta en cada ejecución. Incluye fuentes con una media de al menos tres eventos conservados y fuentes calificadas como especialmente importantes, incluso tras una ejecución vacía. La banda B contiene fuentes con algo de rendimiento o todavía sin historial; vuelven a tocar a los siete días, como máximo ocho por ejecución, las más antiguas primero. La banda C reúne fuentes que no aportan nada de forma repetida. Pausan siete, luego catorce, luego veintiocho días, treinta como máximo, y después se vuelven a probar, como máximo tres por ejecución.
Una página que carga pero no muestra eventos solo retrocede en el orden. Una fuente se considera rota únicamente cuando no se pudo descargar tres veces seguidas. Las fuentes nuevas proceden, entre otros sitios, de un registro de redes públicas, aceleradoras, institutos de investigación y clústeres de la región: si una organización tiene allí una página de eventos que aún no está en la base de datos de fuentes, puede añadirse. El registro en sí nunca se lee como fuente de eventos, para que nada cuente dos veces.
Las decisiones humanas vuelven al mismo registro
Lo que alguien piensa hacer con un evento no lo decide un modelo. En la vista de pipeline, una tarjeta se arrastra de la bandeja de entrada a la preselección, a asistencia o a descartado; en las listas, los eventos también pueden marcarse como favoritos, fijarse o archivarse.
El panel es un único archivo HTML sin servidor, así que estas decisiones viven primero en el navegador. Un botón las exporta como archivo de estado, y la siguiente ejecución las incorpora a events.json antes de descargar nada: asistencia, favorito, archivo, fijado, eventos añadidos a mano y nuevas fuentes propuestas.
Los favoritos quedan excluidos de la limpieza y permanecen en el registro incluso después de años. Una fecha fijada aparece en la vista de inicio sea cual sea su puntuación, y ninguna de estas marcas modifica la puntuación de prioridad.
Un conjunto de datos, tres lecturas
Los mismos eventos como lista, mapa y calendario
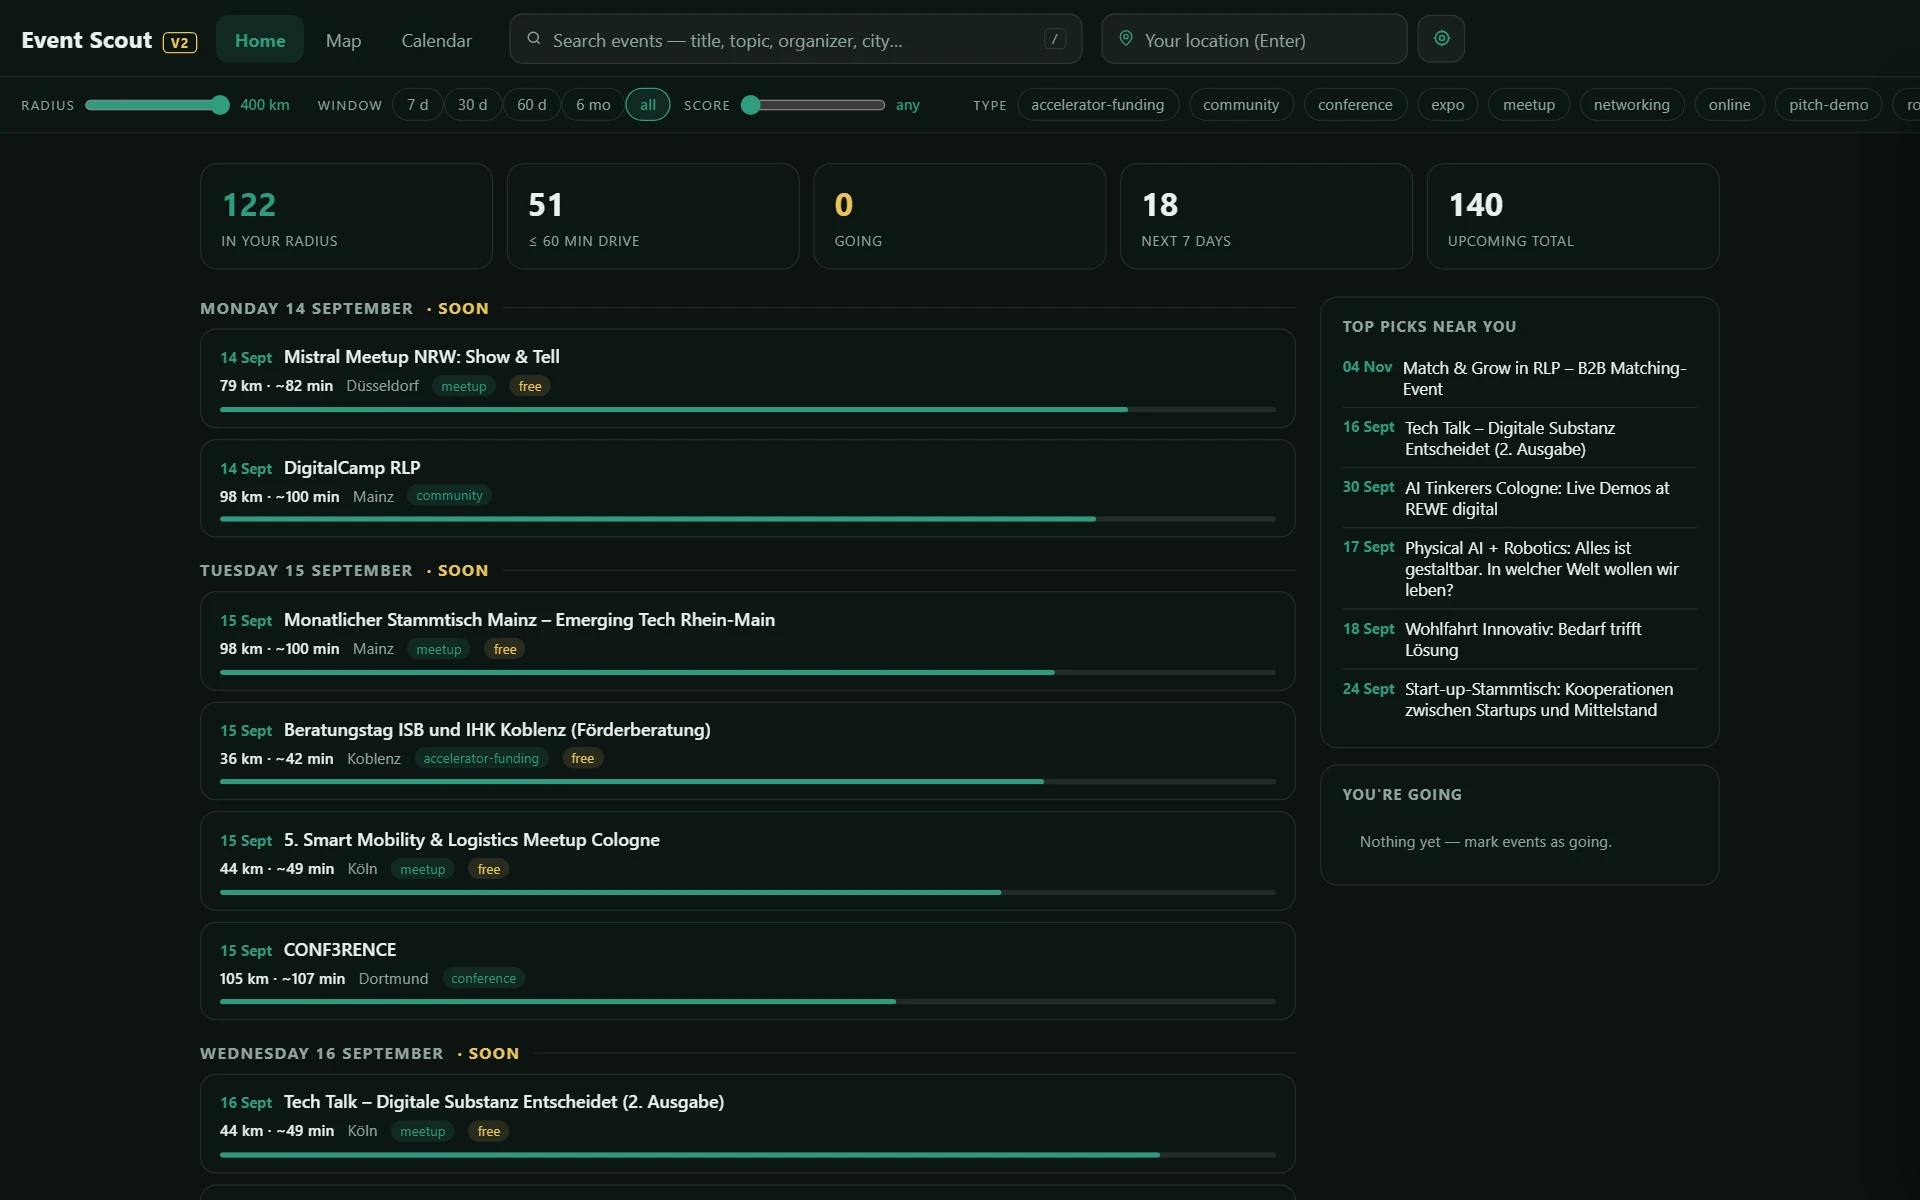
ListaLas tres vistas muestran el mismo conjunto filtrado. El radio, la ventana temporal y la relevancia mínima de arriba se aplican por igual a lista, mapa y calendario.
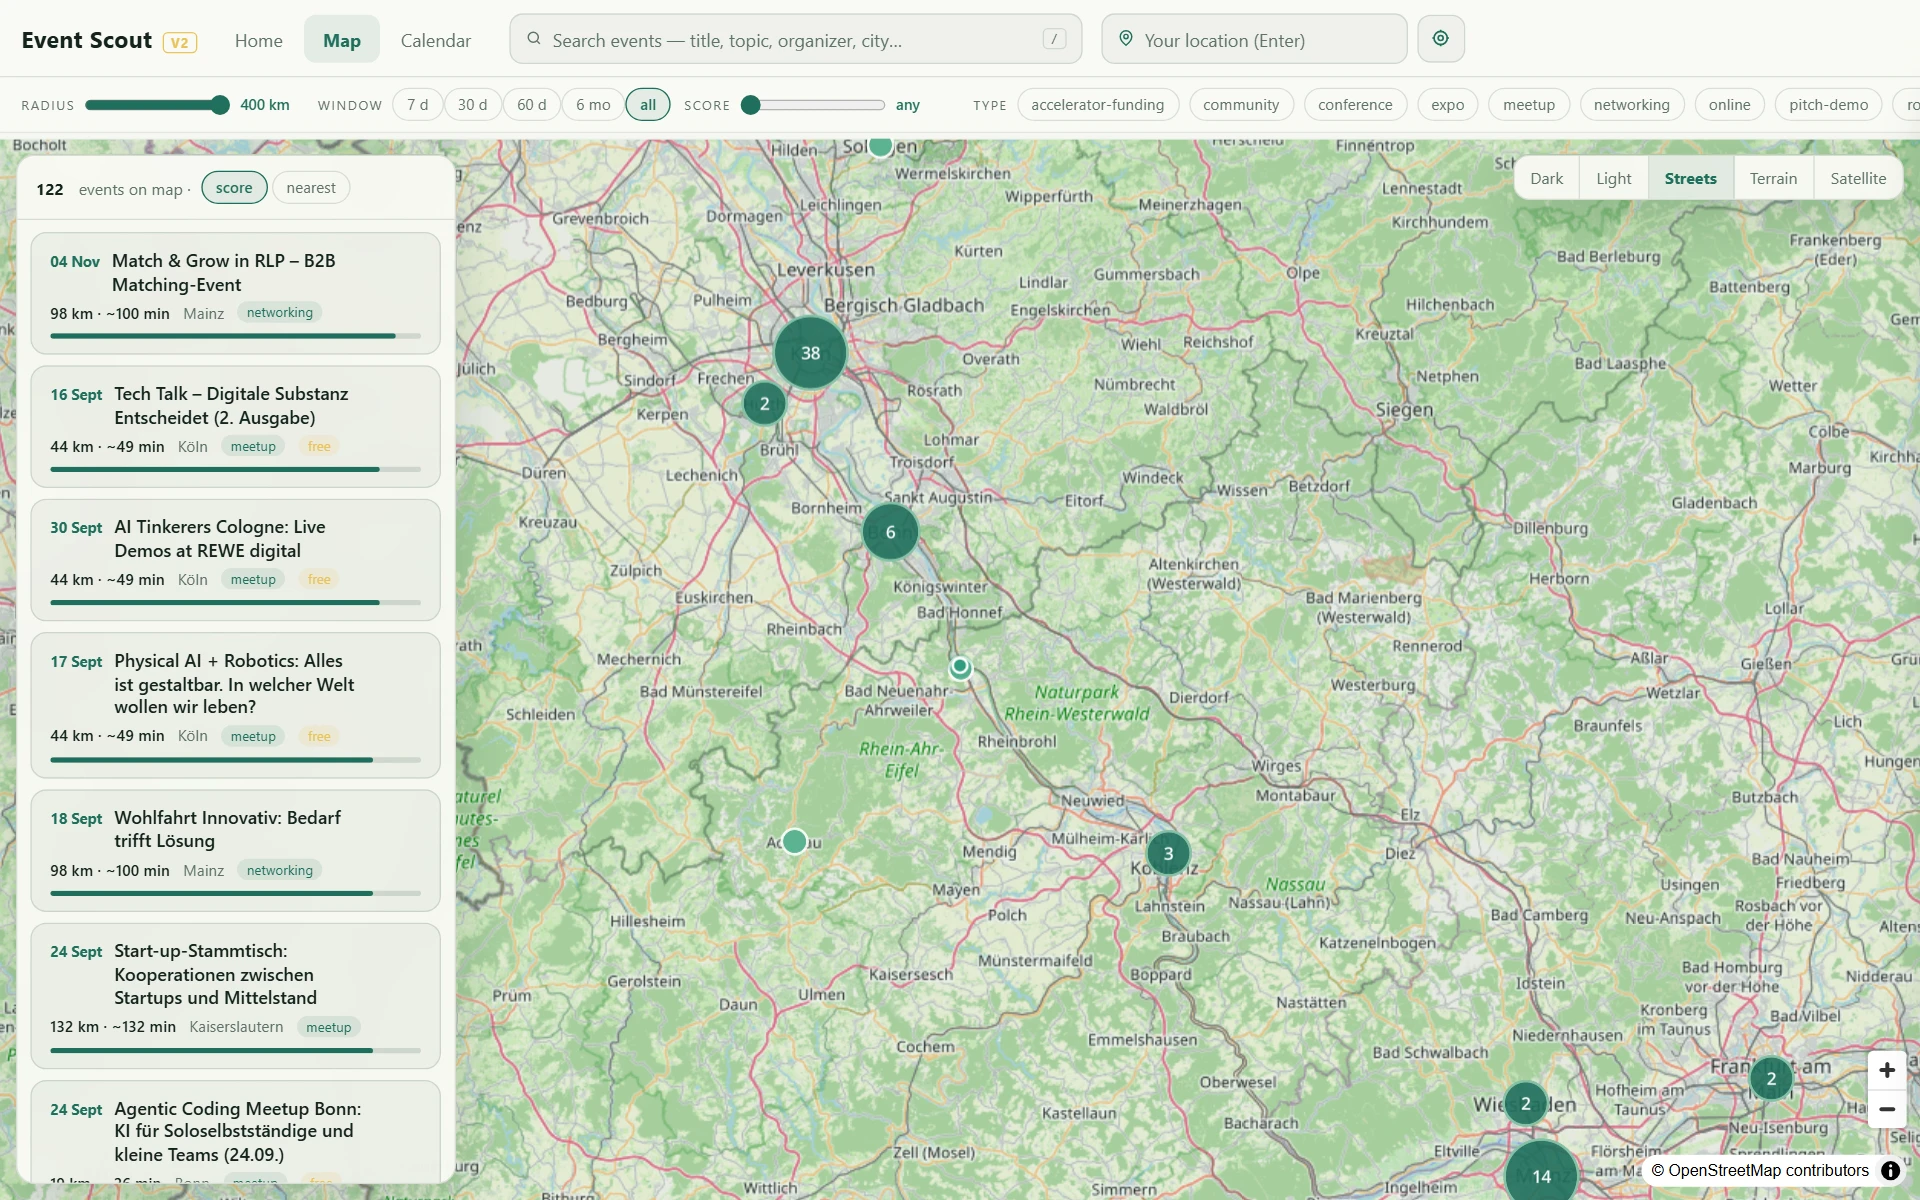
MapaLos cúmulos muestran de un vistazo dónde se concentran los eventos: Colonia y Bonn llevan los mayores recuentos, el valle del Ahr y Coblenza los menores.
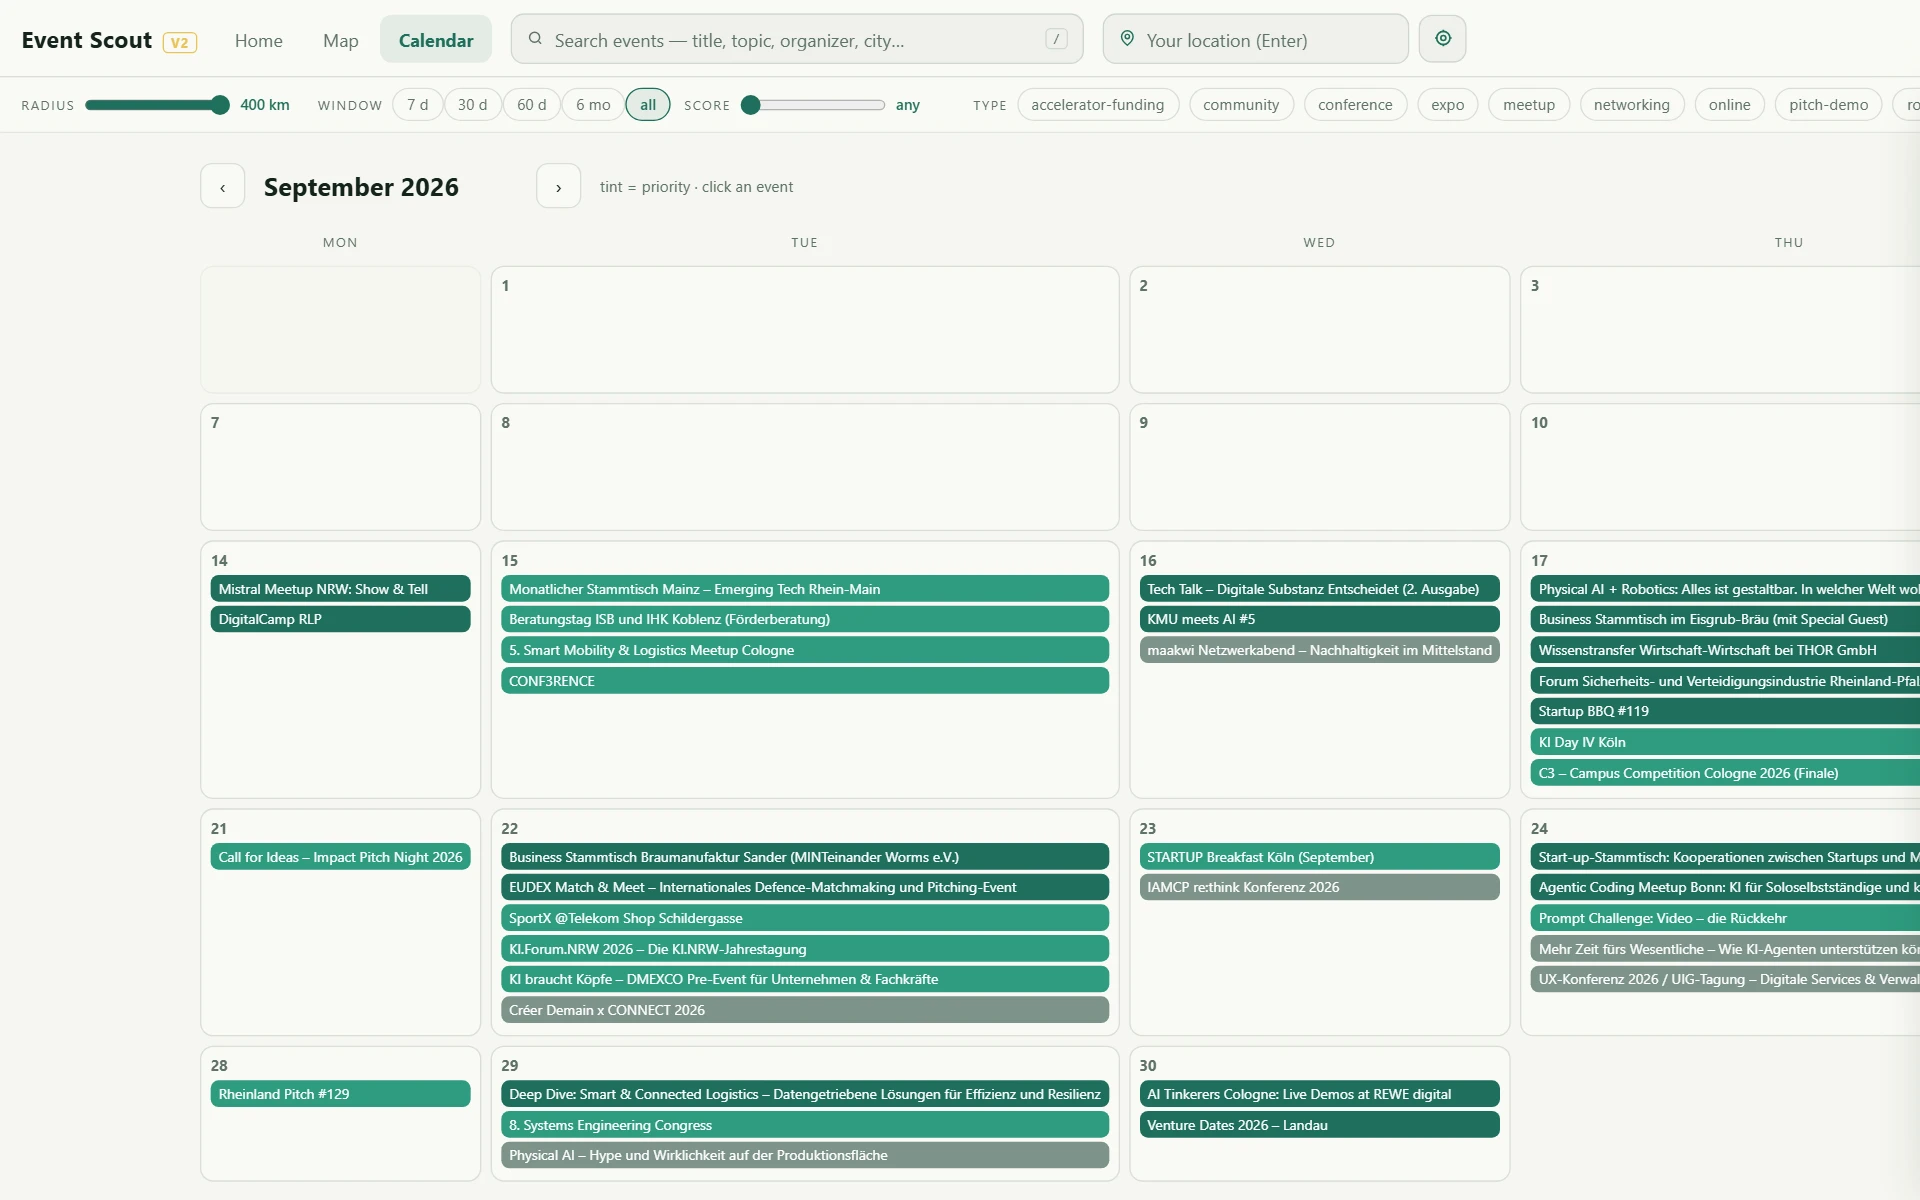
CalendarioEl calendario está en claro, la lista y el mapa en oscuro: la misma interfaz ajustada a cada tarea, sin que los datos cambien.
Dónde encaja la misma construcción
- Revisar licitaciones públicas de varios portales de contratación y ordenarlas según criterios propios.
- Seguir cambios en normas, directrices o documentación de fabricantes en muchos sitios de editores.
- Vigilancia de mercado y competencia a partir de notas de prensa, páginas de producto y calendarios sectoriales.
- Reunir listas de expositores y proveedores de distintas ferias en un registro común y deduplicado.
- Cualquier revisión recurrente en la que hoy alguien abre a mano las mismas páginas cada semana.
Créditos de imagen: todas las imágenes son capturas de nuestra propia aplicación, hechas a partir de una copia depurada del registro. Los eventos visibles son fechas anunciadas públicamente por sus respectivos organizadores.
Por qué se publica
Lo que esto significa para su proyecto
Más del laboratorio
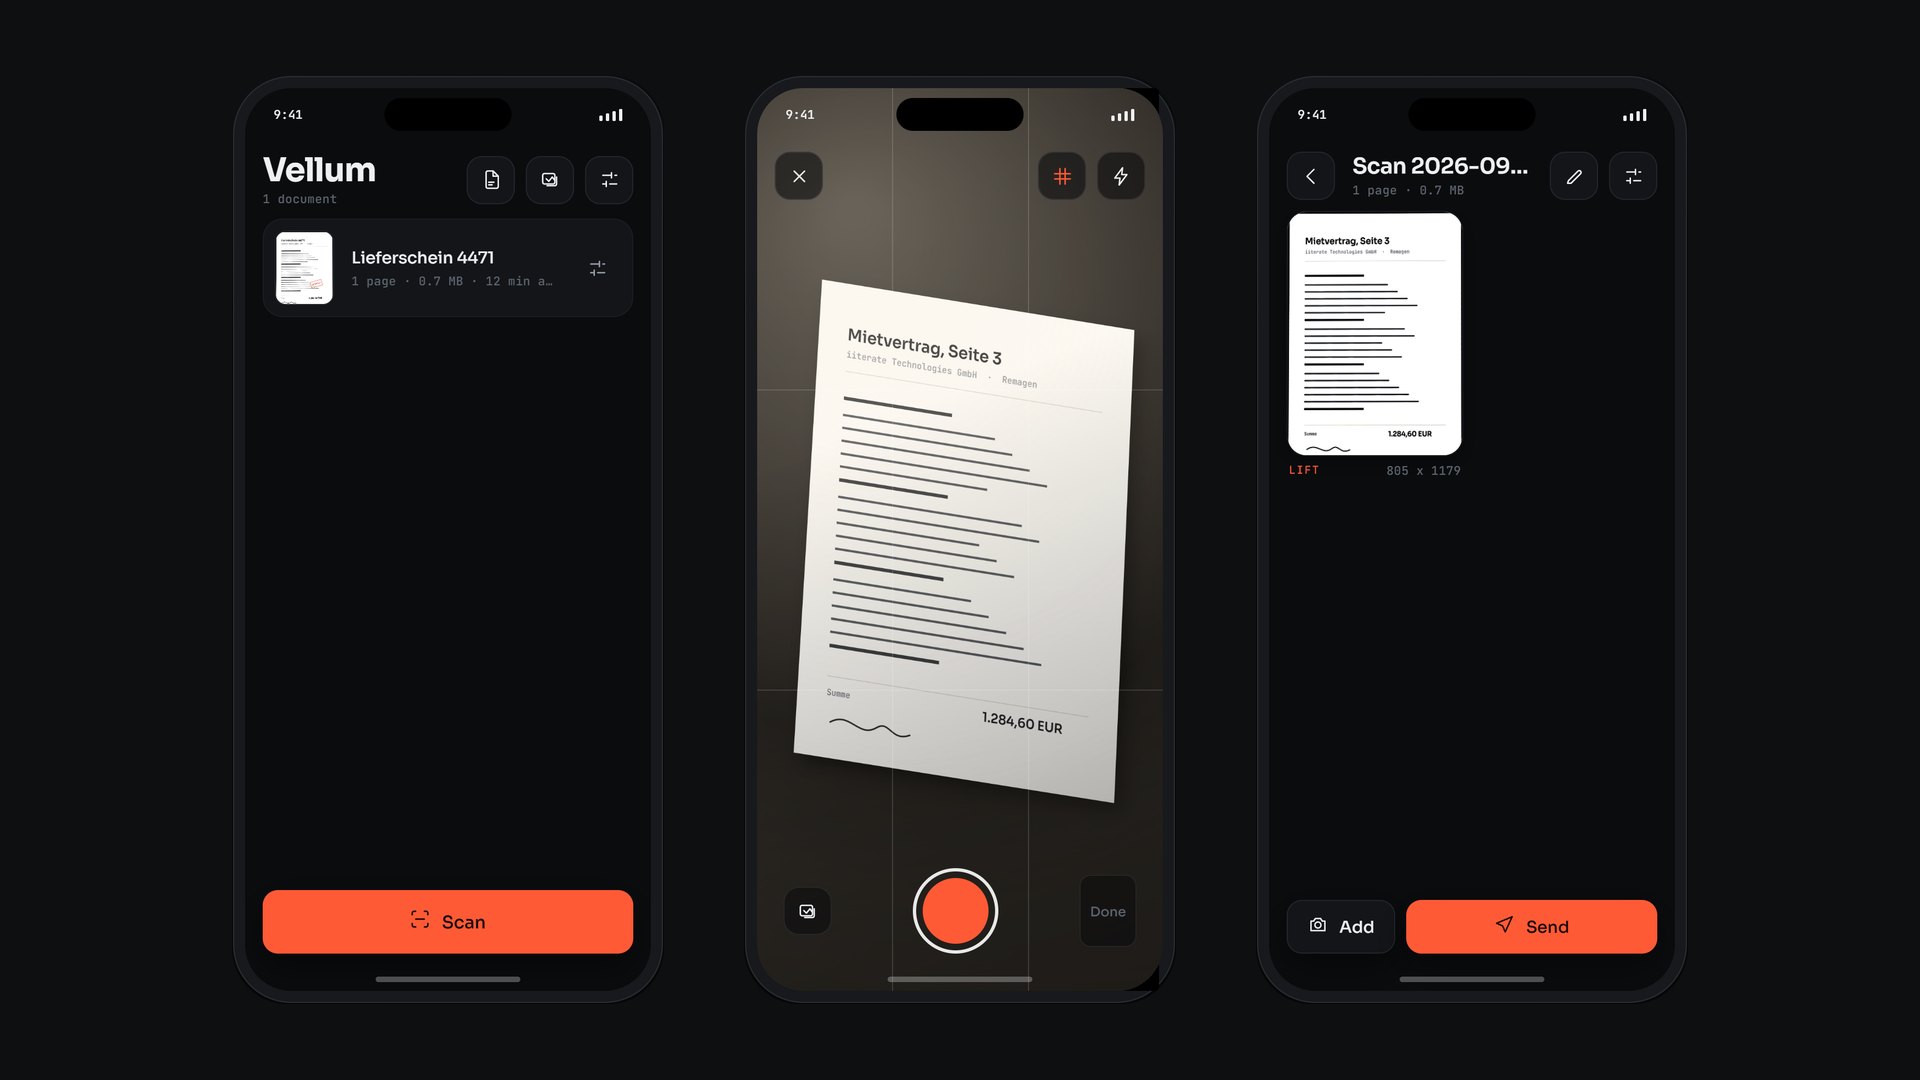 Investigación aplicada Vellum Bordes, perspectiva, luz y texto se calculan en el teléfono. Un documento solo sale del dispositivo cuando alguien lo envía.
 Diseño computacional Atlas EV1 Doce capítulos desmontan un coche eléctrico, hasta una sola celda. Sin archivos de modelo ni texturas: 327 piezas de una tabla de medidas.
 Método Contradiction Indique qué debe mejorar y qué empeora al hacerlo. Obtiene los principios que resolvieron ese par exacto y los inventos que lo lograron.
¿Hay alguien en su organización que abre cada semana las mismas páginas para mantener una lista al día? Para eso existe un piloto.
Contactar