Vellum
Ein Dokumentenscanner, der auf dem Telefon rechnet
Kanten, Perspektive, Licht und Text werden auf dem Telefon berechnet. Ein Dokument verlässt das Gerät erst, wenn jemand es sendet.
- Server, über die eine Seite läuft
- 0
- GPU-Durchgang für Entzerrung und Tonwert
- 1
- Bildmodi im selben Shader
- 11
- Kantendetektoren: Sucher und Aufnahme
- 2
Live-Demo
Kanten finden, Seite entzerren, Text erkennen
Vereinfachtes Modell im Browser, kein Bildschirmmitschnitt des Produkts.
Die Demo zeigt vereinfacht die Schritte auf dem Gerät: Ein grobes Raster sucht die Seitenkanten, die Ecken werden angepasst, eine Homographie entzerrt die Seite, das Licht wird ausgeglichen, und erkannte Zeilen landen als unsichtbare Textebene im PDF.
Der Zähler für das Hochladen bleibt dabei bei 0 B. Bewegen Sie den Mauszeiger über die Szene, klicken Sie zum Aufnehmen und ziehen Sie die orange Ecke an ihren Platz. Es ist eine vereinfachte Darstellung des Ablaufs, nicht die App.
Publikationsgrund
Wir bauen Dokumenten-KI und beraten dazu, wo Daten liegen dürfen. Vellum zeigt den Teil dieser Arbeit, der vor jedem Modell liegt: ein Bild so aufzubereiten, dass es lesbar ist, und das dort zu tun, wo das Dokument ohnehin schon ist. Dazu gehört Bildverarbeitung, deren Genauigkeit gemessen statt geschätzt wird, und die Disziplin, auf echter Hardware zu testen, weil sich dort Fehler zeigen, die kein Browser findet. Wer eine Verarbeitung sensibler Dokumente ohne Umweg über fremde Server plant, sieht hier, wie wir so etwas bauen.
Ein Scanner fotografiert Dokumente, die man ungern aus der Hand gibt: Verträge, Lieferscheine, Ausweise. Vellum findet die Seitenkanten schon im Kamerabild, entzerrt die Perspektive über eine Homographie, gleicht Licht und Kontrast in einem Fragment-Shader auf der GPU aus und erkennt den Text auf dem Telefon. Es gibt keinen Server, über den eine Seite dabei läuft. PDF und Bilder verlassen das Gerät über das Teilen-Menü des Betriebssystems, also erst dann, wenn jemand selbst auf Senden tippt. Gebaut ist die App mit Expo und React Native; ein Android-Build wird derzeit auf einem Emulator und auf einem Telefon erprobt.
Die Entscheidung
Das Telefon ist schon da, wo das Dokument ist
Die erste Frage an diesen Scanner war nicht, wie gut er Kanten findet, sondern wohin eine Seite dabei geht. Ein Server, der Bilder aufbereitet und Text liest, ist schnell gebaut. Er ist aber auch ein weiterer Ort, an dem Verträge, Ausweise und Lieferscheine liegen, mit allen Fragen, die daran hängen: wer Zugriff hat, wie lange, in welchem Land. Vellum hat deshalb keinen. Erkennung, Entzerrung, Tonwertkorrektur und Texterkennung laufen auf dem Telefon.
Aus dieser Entscheidung folgt fast jede weitere. Die Perspektivkorrektur ist eine Homographie in einem Fragment-Shader und kein Aufruf an einen Dienst. Die Texterkennung schreibt eine unsichtbare Textebene in das PDF, an die Stelle jeder erkannten Zeile, und macht die Bibliothek durchsuchbar, ohne dass der Text je hochgeladen wird. Senden heißt: Das Mail-Programm oder das Teilen-Menü des Betriebssystems öffnet sich mit der Datei, und ein Mensch tippt auf Senden.
Der Preis dafür ist ehrlich zu nennen. Alles, was einen Server braucht, fehlt bewusst: Synchronisation zwischen Geräten, Freigabelinks, Übersetzung, Texterkennung in der Cloud. Unbeaufsichtigtes Versenden gibt es ebenfalls nicht, weil jeder Versand über eine Person läuft. Und die Rechenleistung ist die des Telefons, also muss jeder Schritt in dessen Budget passen.
Was das Gerät nicht verlässt, liegt an keinem zweiten Ort.
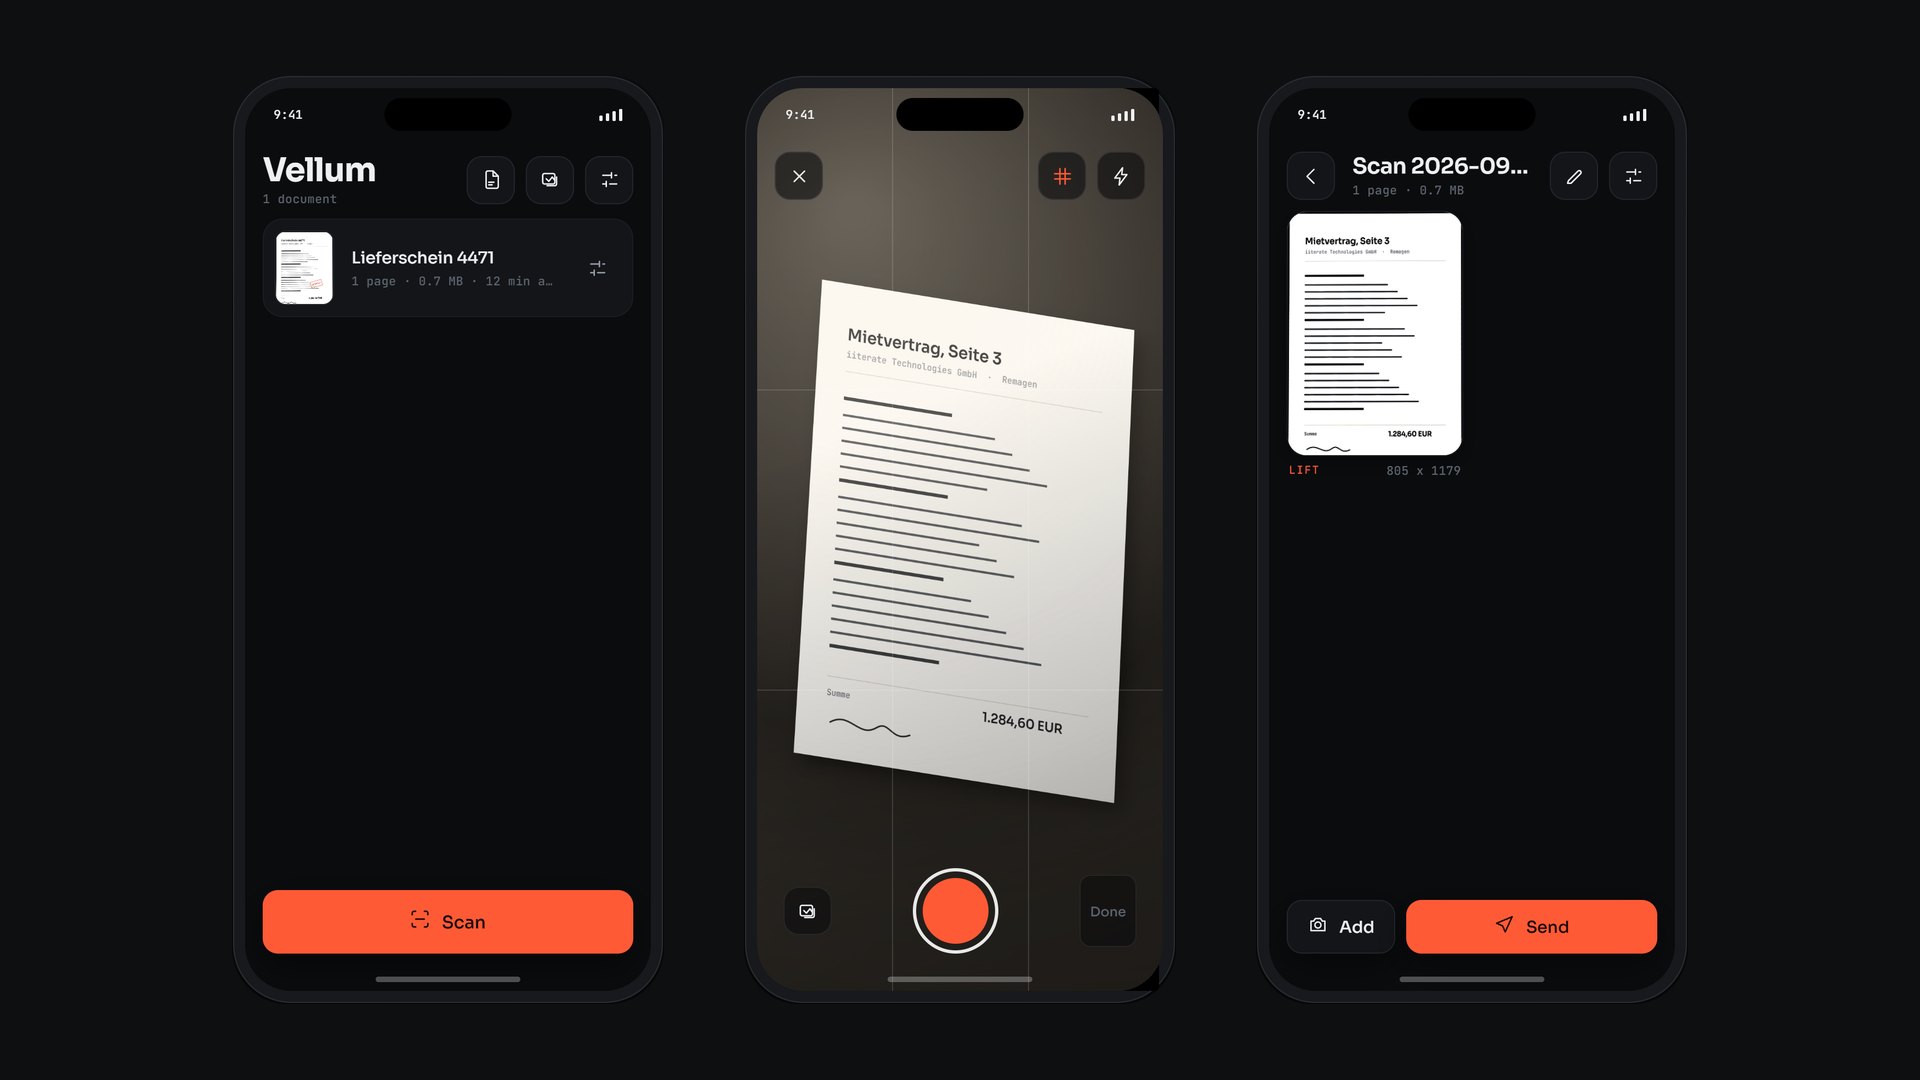
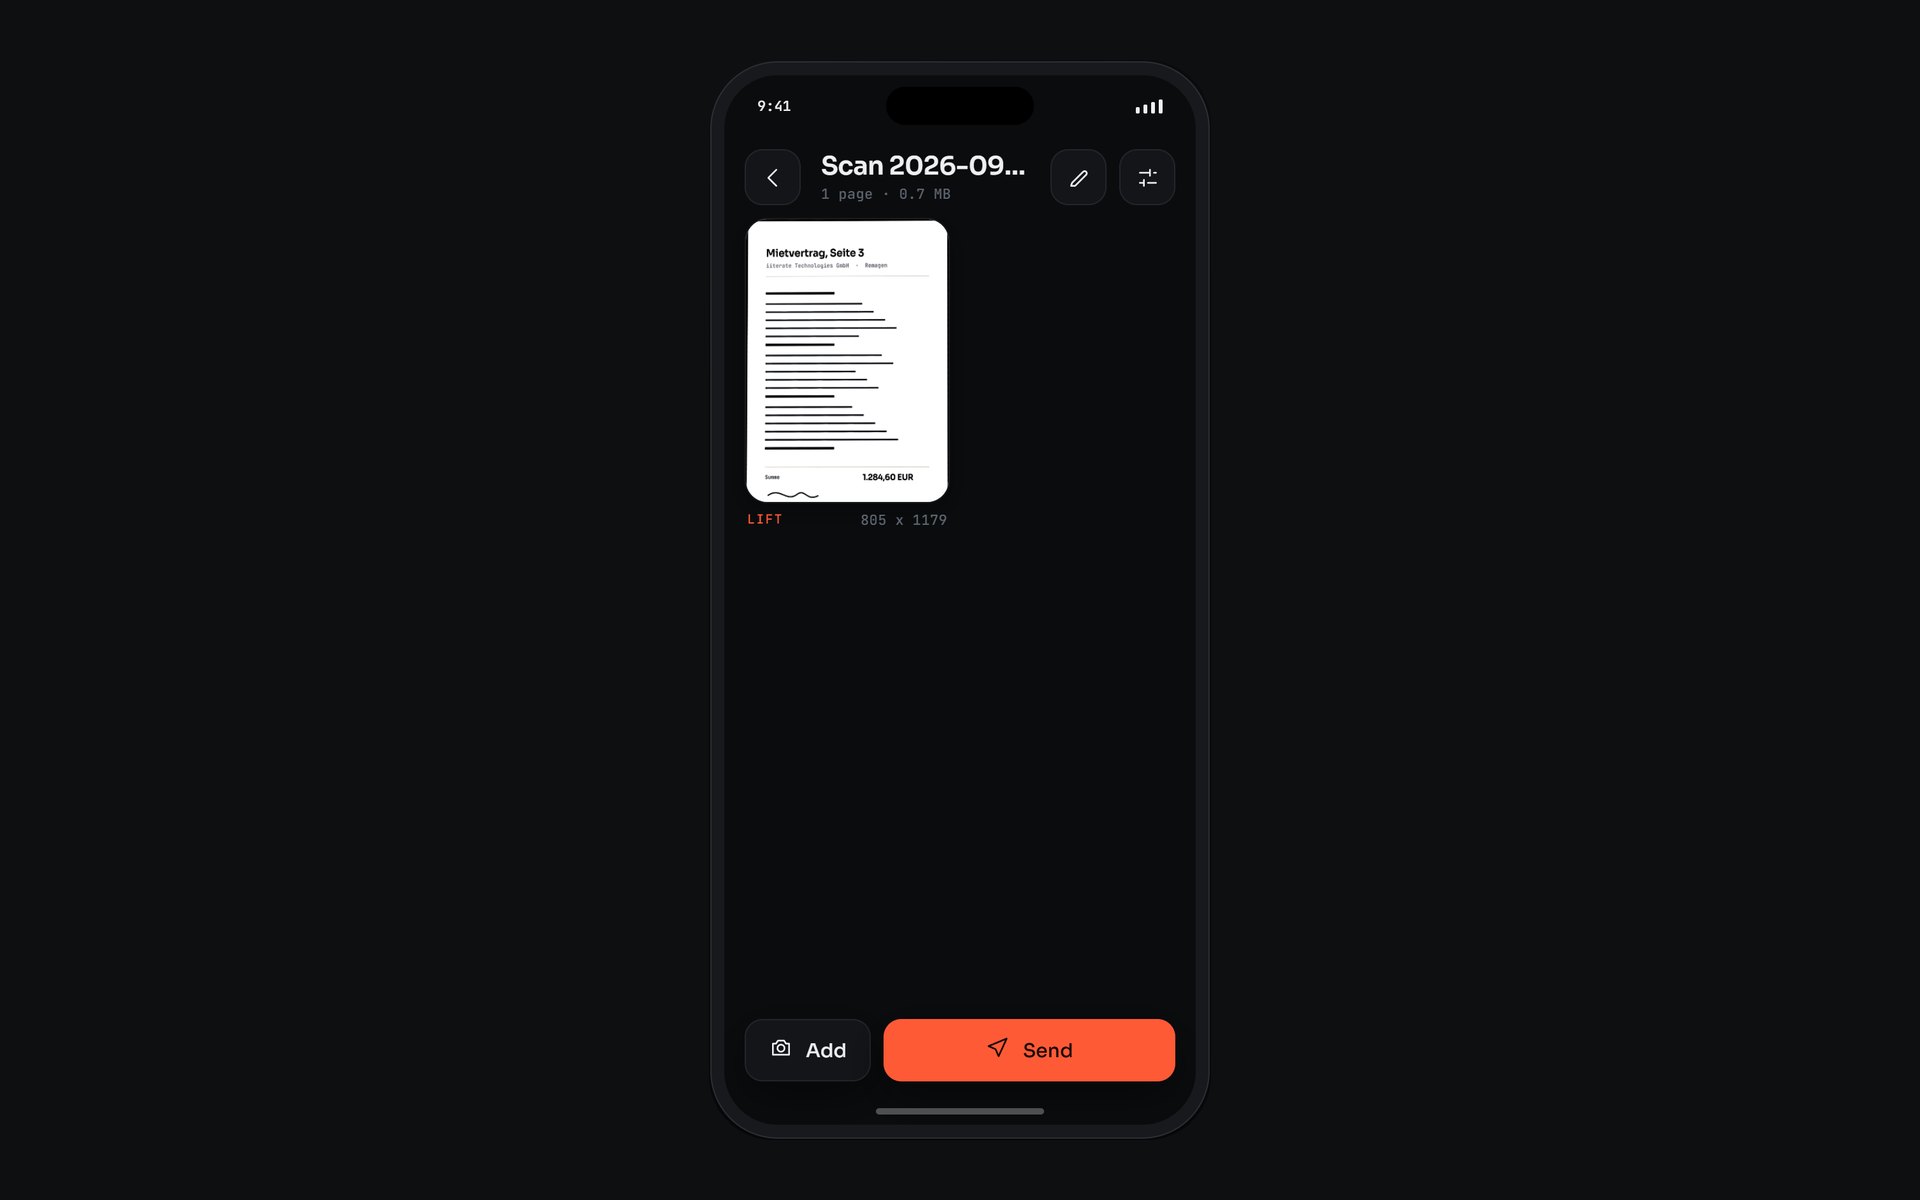
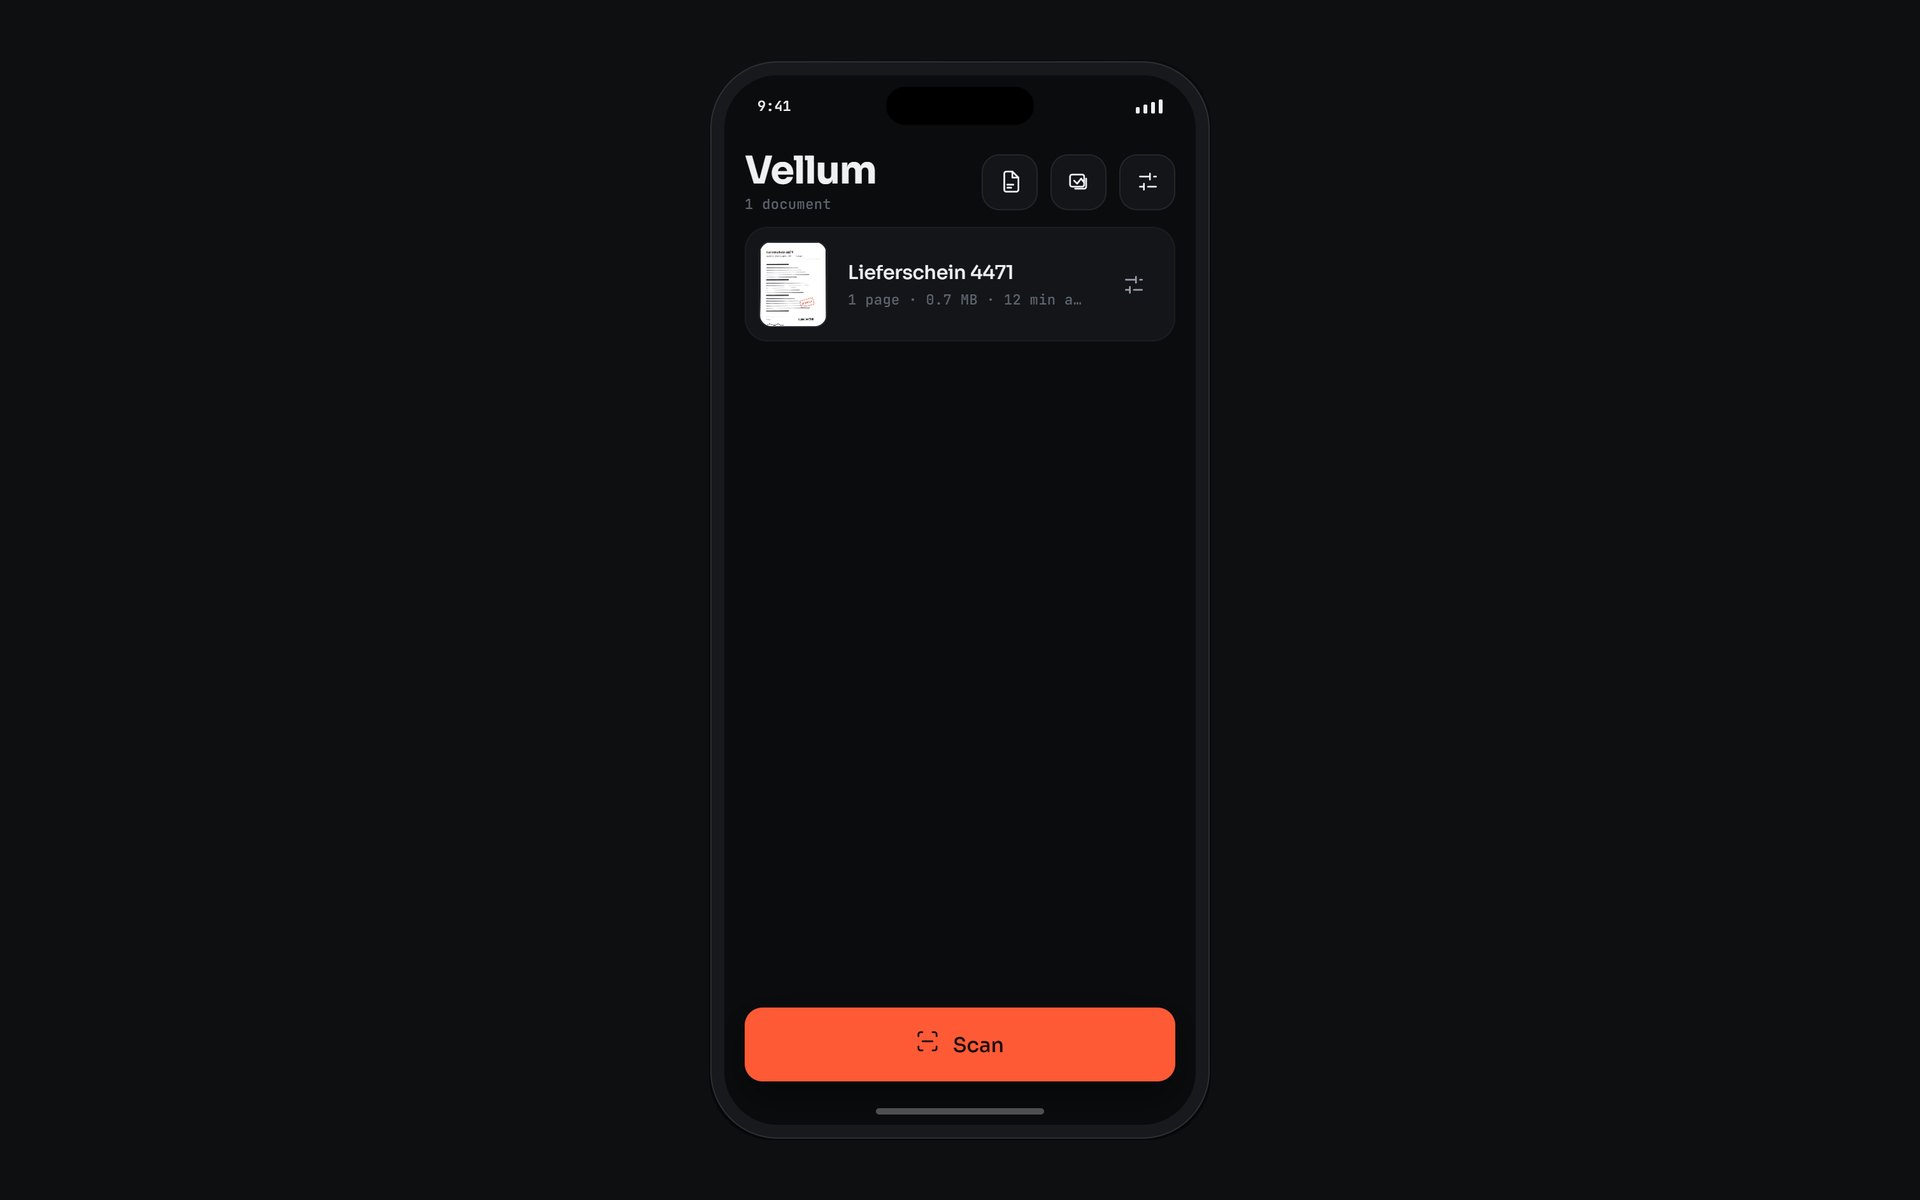
Drei Bildschirme der App: Bibliothek, Sucher, fertige Seite
Der Weg einer Seite
Vom Kamerabild zur durchsuchbaren Datei
- 01
Kanten im Sucher
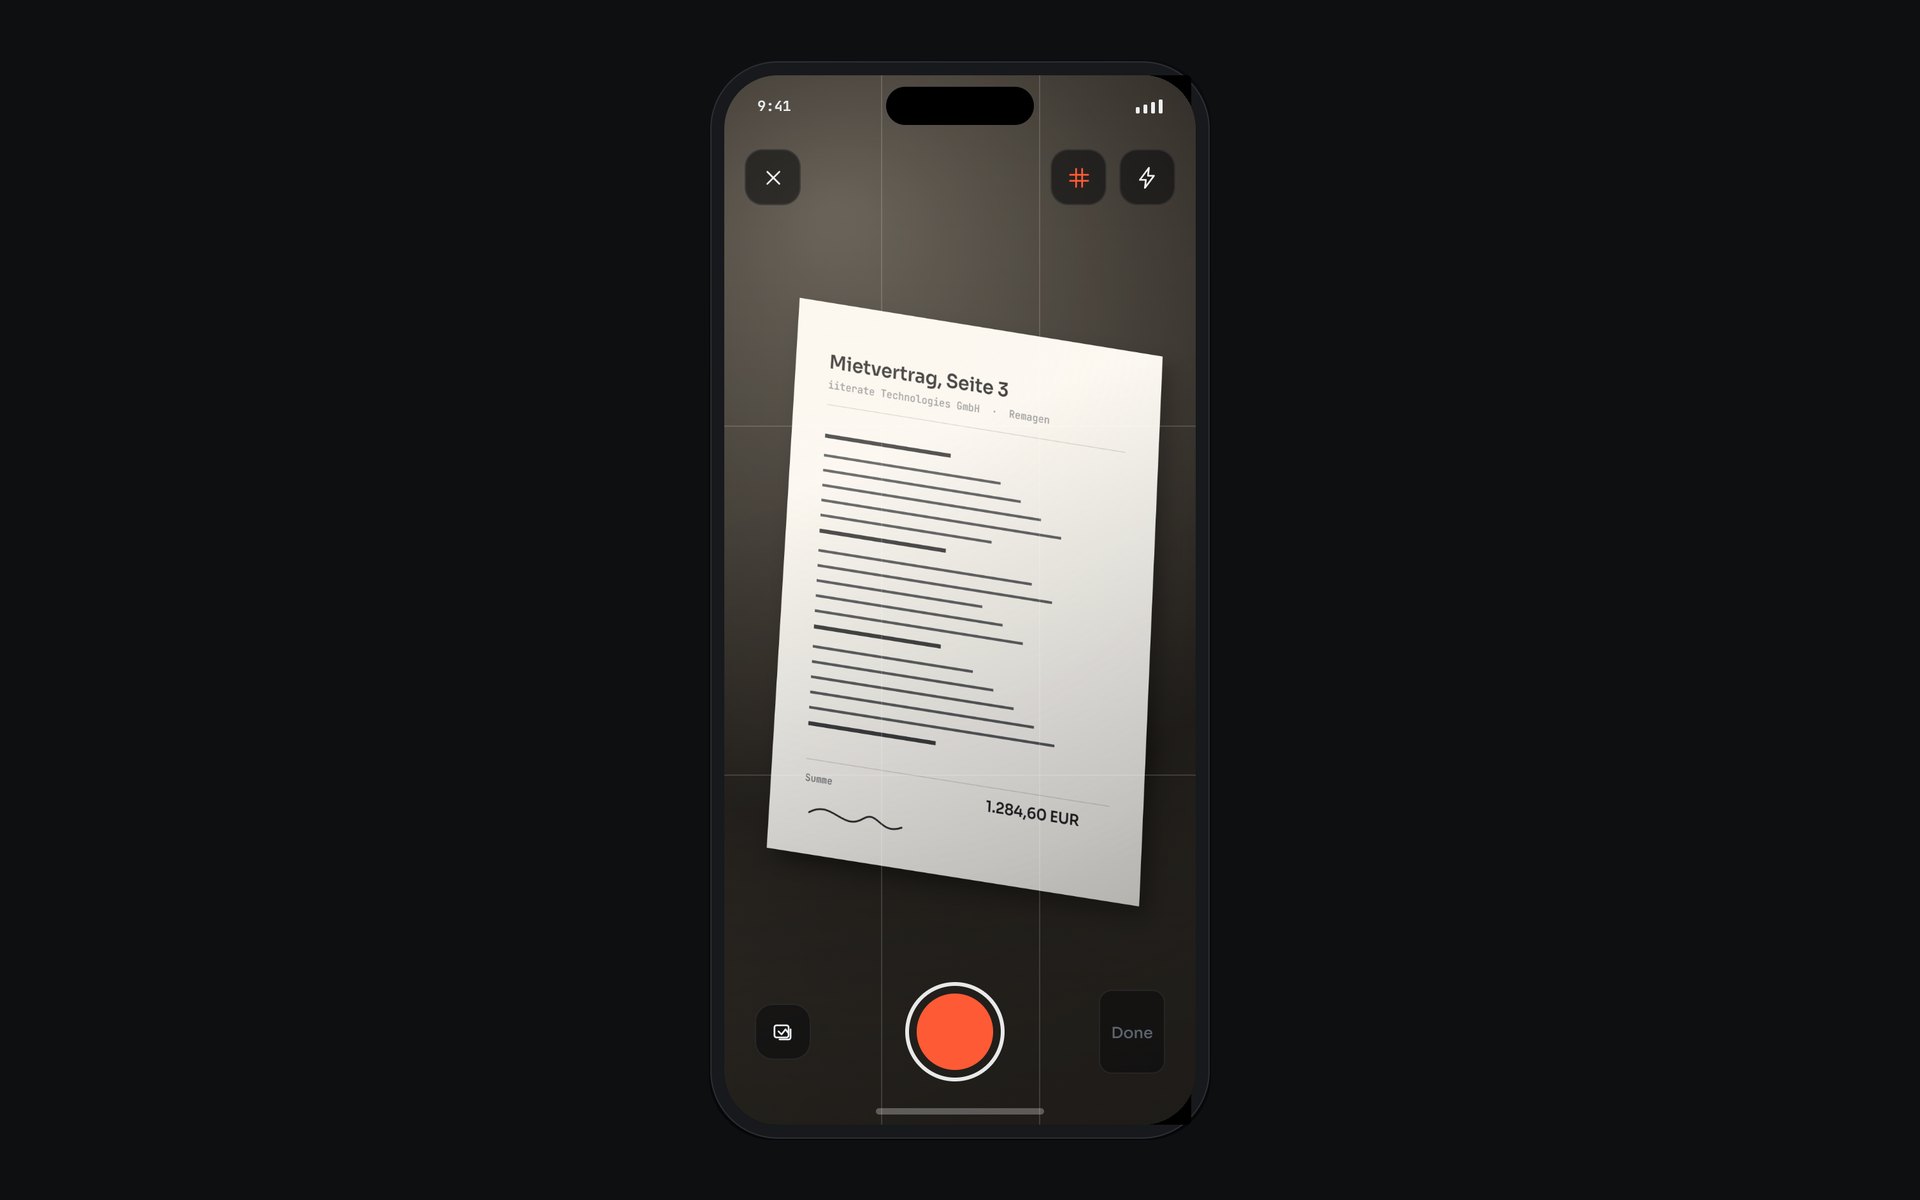
Bei jedem Kamerabild liest ein Worklet die Helligkeitsebene in einem groben Raster, und zwar nur den Teil, den der Bildschirm tatsächlich zeigt. Daraus entsteht ein Umriss, der geglättet wird und ein paar verlorene Bilder lang stehen bleibt. Die Ecken lassen sich vor dem Auslösen ziehen.
- 02
Ecken nach der Aufnahme
Auf dem Foto sucht ein gründlicherer Detektor: Schwellwert nach Otsu, zusammenhängende Flächen, nur Randzellen auf einer echten Helligkeitsstufe, dann eine Gerade je Seite nach der Methode der kleinsten Quadrate. Findet er nichts, gilt das ganze Bild, und die Ecken werden von Hand gesetzt. Standardmäßig folgt eine Eckenkontrolle.
- 03
Entzerren und Licht ausgleichen
Ein einziger GPU-Durchgang. Der Shader rechnet jede Ausgabekoordinate über die Homographie in das Foto zurück und liest dort. Das Papierweiß schätzt er aus zwei verkleinerten Kopien des Fotos, sodass jede Helligkeit relativ zum Papier gilt, egal wo die Lampe steht.
- 04
Text erkennen
Die Texterkennung läuft auf dem Gerät. Aus der Richtung der erkannten Zeilen liest die App, ob die Seite gedreht werden muss und wie schief sie liegt, und korrigiert beides über die Eckenliste. Stimmen die Zeilen nicht überein, bleibt die Seite, wie sie ist.
- 05
PDF und Versand
Die Seiten werden zu einem PDF mit unsichtbarer Textebene oder zu Einzelbildern. Eine Größenvorgabe senkt erst die JPEG-Qualität und dann die Auflösung. Hinaus geht die Datei über das Mail-Programm oder das Teilen-Menü des Betriebssystems.
Gesucht wird nur, was man sieht
Die Vorschau füllt den Bildschirm, das Kamerabild hat aber ein anderes Seitenverhältnis. Auf einem hohen Telefon liegt deshalb etwa ein Drittel jedes Bildes außerhalb des Bildschirms. Solange der Detektor dieses Drittel mit durchsuchte, konnte er eine Ecke an eine Stelle legen, die niemand sah und niemand ziehen konnte. Beide Detektoren suchen jetzt nur im sichtbaren Ausschnitt.
Die zweite Ursache für eine verrutschte Kante war eine helle Fläche neben der Seite, etwa ein Lichtkegel, die mit dem Papier zu einem Fleck verschmolz. Seitdem wird jede Seite des Umrisses danach bewertet, ob über sie hinweg ein echter Helligkeitssprung liegt. Ein Lichtkegel läuft weich aus, eine Papierkante nicht.
Beide Detektoren haben eine Messumgebung, die den Eckfehler auf einem festen Satz Testseiten gegen unabhängig bestimmte Sollwerte ausgibt. Jede Änderung wird vorher und nachher gemessen.
Was auf dem Gerät festgelegt ist
- Schwärzung verändert Pixel
- Geschwärzte Bereiche sind Uniforms im Shader und werden beim Rendern in die Bitmap der Seite gemalt. Unter dem schwarzen Feld liegt danach nichts mehr, und jeder spätere Export trägt die Schwärzung mit. Die Grenze von zwölf Feldern je Seite ist die Größe dieses Arrays.
- Unterschriften werden keine Datei
- Eine Unterschrift liegt als Vektorpfad im geschützten Speicher des Betriebssystems und wird als Pfad in das PDF gezeichnet. Das Teilen-Menü bekommt nur Dateien aus dem Exportordner und damit keinen Weg zur gespeicherten Unterschrift.
- Text als unsichtbare Ebene
- Jede erkannte Zeile wird an ihrer Position unsichtbar in das PDF geschrieben. Die Datei bleibt ein Bild der Seite und wird zugleich markierbar und durchsuchbar.
- Das Original bleibt neben der Seite
- Zu jeder gerenderten Seite wird die ursprüngliche Aufnahme aufbewahrt. Ecken, Bildmodus, Drehung und Schwärzung bleiben dadurch änderbar, weil jede Korrektur neu aus dem Original rechnet. Das kostet doppelten Speicher je Seite.
- Eine Selbstprüfung in der App
- In den Einstellungen läuft eine mitgelieferte, schräg fotografierte Testseite durch Erkennung, Entzerrung, eine Prüfung gegen schwarze Ausgabe, die Zeilenreihenfolge, die Drehung und die Texterkennung, mit Zeiten und einem kopierbaren Bericht. Eigene Fehler protokolliert die App auf dem Gerät.
Nach der Aufnahme bleibt alles änderbar
Die Dokumentansicht zeigt jede Seite mit ihrem Bildmodus und ihrer Ausgabegröße. Von hier aus lässt sich jede Seite nachbearbeiten: Ecken ziehen, mit einer Lupe, die auf die gegenüberliegende Seite springt, damit der Finger die Ecke nicht verdeckt, und einen Bildmodus aus einer Leiste wählen, die jeden Modus als kleine Vorschau des aktuellen Ausschnitts zeigt.
Drehen, das Nachsetzen der Ecken und das Teilen einer Doppelseite aus einem Buch an der Falz sind Änderungen an der Eckenliste desselben Originals, kein Bearbeiten von Pixeln. Die Doppelseite braucht dafür kein zweites Foto. Seiten lassen sich außerdem verschieben, neu aufnehmen und mit einem anderen Dokument zusammenführen.
Was der Prüfstand beweist und was erst das Gerät zeigt
Im Browser nachweisbar
- Die Geometrie der Kantenerkennung, weil der Prüfstand denselben Detektor ausführt.
- Der Tonwert jedes Bildmodus, weil derselbe GLSL-ES-1.00-Shader auf WebGL läuft.
- Ein heller Saum an der Seitenkante, der entstand, weil der Umriss minimal zu groß gewählt war.
- Der Eckfehler je Testseite, gemessen gegen feste Sollwerte.
Erst im Android-Build sichtbar
- Eine Kamerasitzung, die sich nicht konfigurieren ließ, weil die Kameraansicht bereits eine eigene Vorschau mitbringt.
- Umrisse an der falschen Stelle, weil Sensorkoordinaten in der Ausrichtung des Sensors ankommen und erst gedreht werden müssen.
- Senkrecht gespiegelte Seiten, weil ein Framebuffer von unten nach oben ausgelesen wird.
- Schwarze Seiten, weil eine native Bilddekodierung fehlschlug, ohne einen Fehler zu melden.
- Abstürze, die nur im Release-Build auftreten und in der Entwicklung höchstens eine Warnung sind.
Suchen in dem, was das Telefon gelesen hat
Die Bibliothek filtert nach Etiketten, nach Alter und nach dem Text, der auf den Seiten erkannt wurde. Ein Dokument trägt bis zu acht Etiketten. Voreinstellungen für Beleg, Vertrag und Ausweis setzen Bildmodus und Layout gemeinsam; beim Ausweis landen zwei Aufnahmen auf einem A4-Blatt.
Auf Wunsch arbeitet eine Warteschlange die Texterkennung für bereits gespeicherte Seiten ab, eine Seite nach der anderen und nur, solange die App im Vordergrund ist. Ein Foto, das eine andere App an Vellum weitergibt, läuft durch dieselbe Pipeline wie eine Aufnahme. In beiden Fällen verlässt kein Bild das Gerät.
Wofür diese Bauweise gedacht ist
- Dokumente, die nicht bei einem Scan-Dienst liegen sollen: Verträge, Personalunterlagen, Ausweiskopien.
- Außendienst und Lager, wo ein Lieferschein vor Ort erfasst und von dort aus versendet wird.
- Belege mit verblasstem Thermodruck, für die es einen eigenen Bildmodus gibt.
- Als erster Schritt einer Dokumenten-KI mit Datenhaltung im eigenen Haus: Seiten werden auf dem Gerät lesbar gemacht, bevor irgendetwas weiterverarbeitet wird.
- Als Vorlage für eigene Apps, die Bilder mit Shadern auf dem Gerät verarbeiten statt auf einem Server.
Was das für Ihr Projekt heißt
Weiteres aus dem Lab
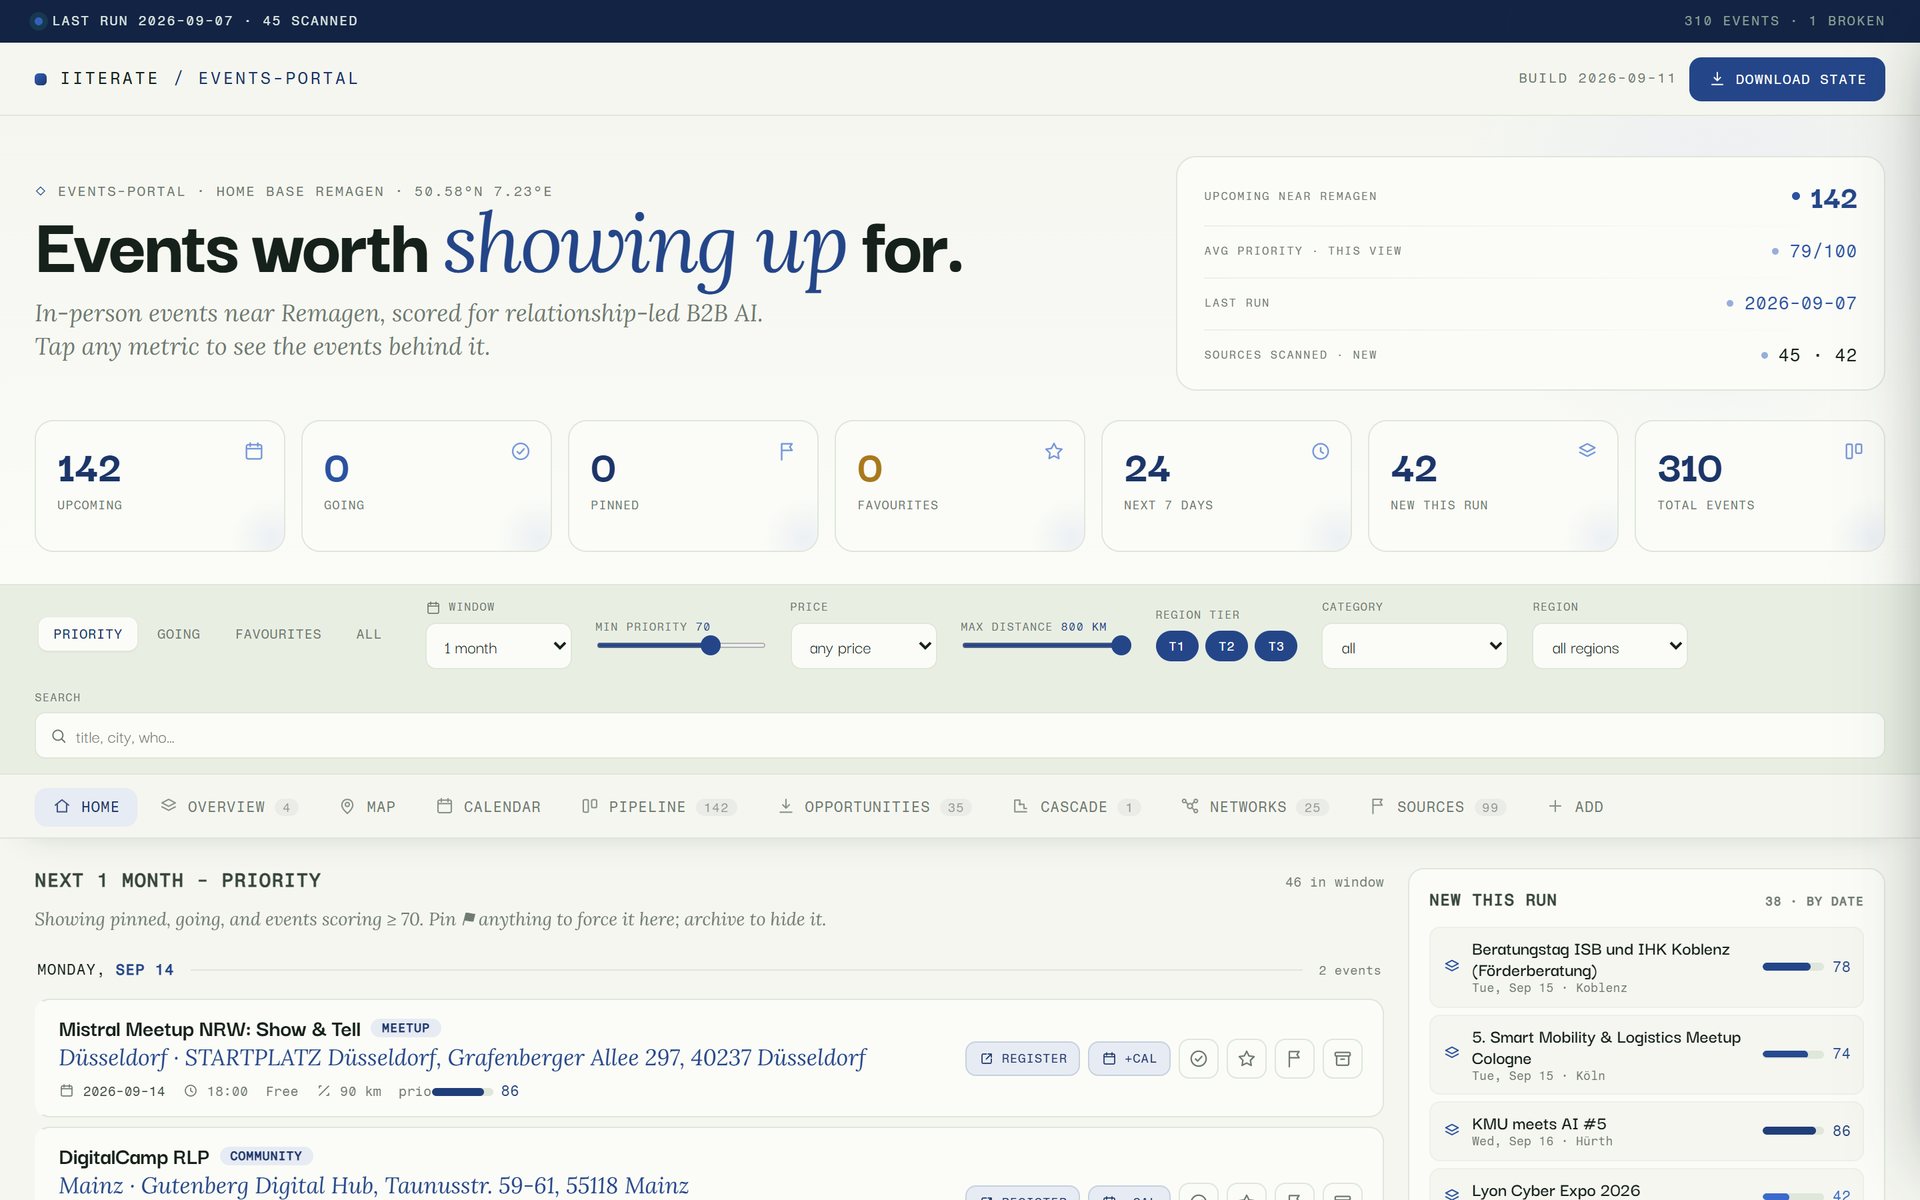 Methode Event Scout Ein Sprachmodell liest die Veranstaltungsseiten, alles andere ist festes Programm. Übrig bleibt eine kurze Liste, wo sich ein Tag vor Ort lohnt.
 Computational Design Atlas EV1 Zwölf Kapitel nehmen ein Elektroauto auseinander, bis zur einzelnen Zelle. Keine Modelldateien, keine Texturen: 327 Teile aus einer Maßtabelle.
Projekt besprechen
Sollen sensible Dokumente lesbar werden, ohne einen Umweg über fremde Server? Genau dafür gibt es einen Piloten.
Kontakt aufnehmen