Warum KI-Features in der Praxis scheitern: sieben Stufen, an denen Fehler entstehen
Eine falsche KI-Antwort hat fast immer eine Adresse. Wer die sieben Stufen eines KI-Features kennt, findet den Fehler, bevor jemand das Modell tauscht.
Ein Servicetechniker fragt den Assistenten seines Unternehmens, welche Leckrate an der Pumpe P-40 noch zulässig ist. Die Antwort nennt einen Grenzwert aus dem Lieferantendatenblatt und klingt plausibel. Die Anweisung aus dem Wartungshandbuch, ab welcher Leckage die Pumpe außer Betrieb zu nehmen ist, fehlt. Im Ticket steht am Ende ein Satz, den viele Teams kennen: „Die KI hat sich etwas ausgedacht.“
Mit diesem Satz lässt sich nicht arbeiten, weil er keinen Ort nennt. Ein KI-Feature besteht aus mehreren Stufen, und fast jeder Fehler entsteht an genau einer davon. Das Beispiel mit der Pumpe ist erfunden, der Weg zur Ursache ist übertragbar.
01. Warum „die KI“ keine Fehlerursache ist
Von außen sind bei einem KI-Feature zwei Dinge sichtbar: die Frage und die Antwort. Alles dazwischen wirkt wie eine geschlossene Kiste, und Fehlermeldungen landen deshalb beim Sprachmodell, weil es der einzige Baustein ist, dessen Namen alle kennen. Die naheliegende Reaktion ist ein anderes Modell, eine längere Anweisung oder ein teurerer Tarif.
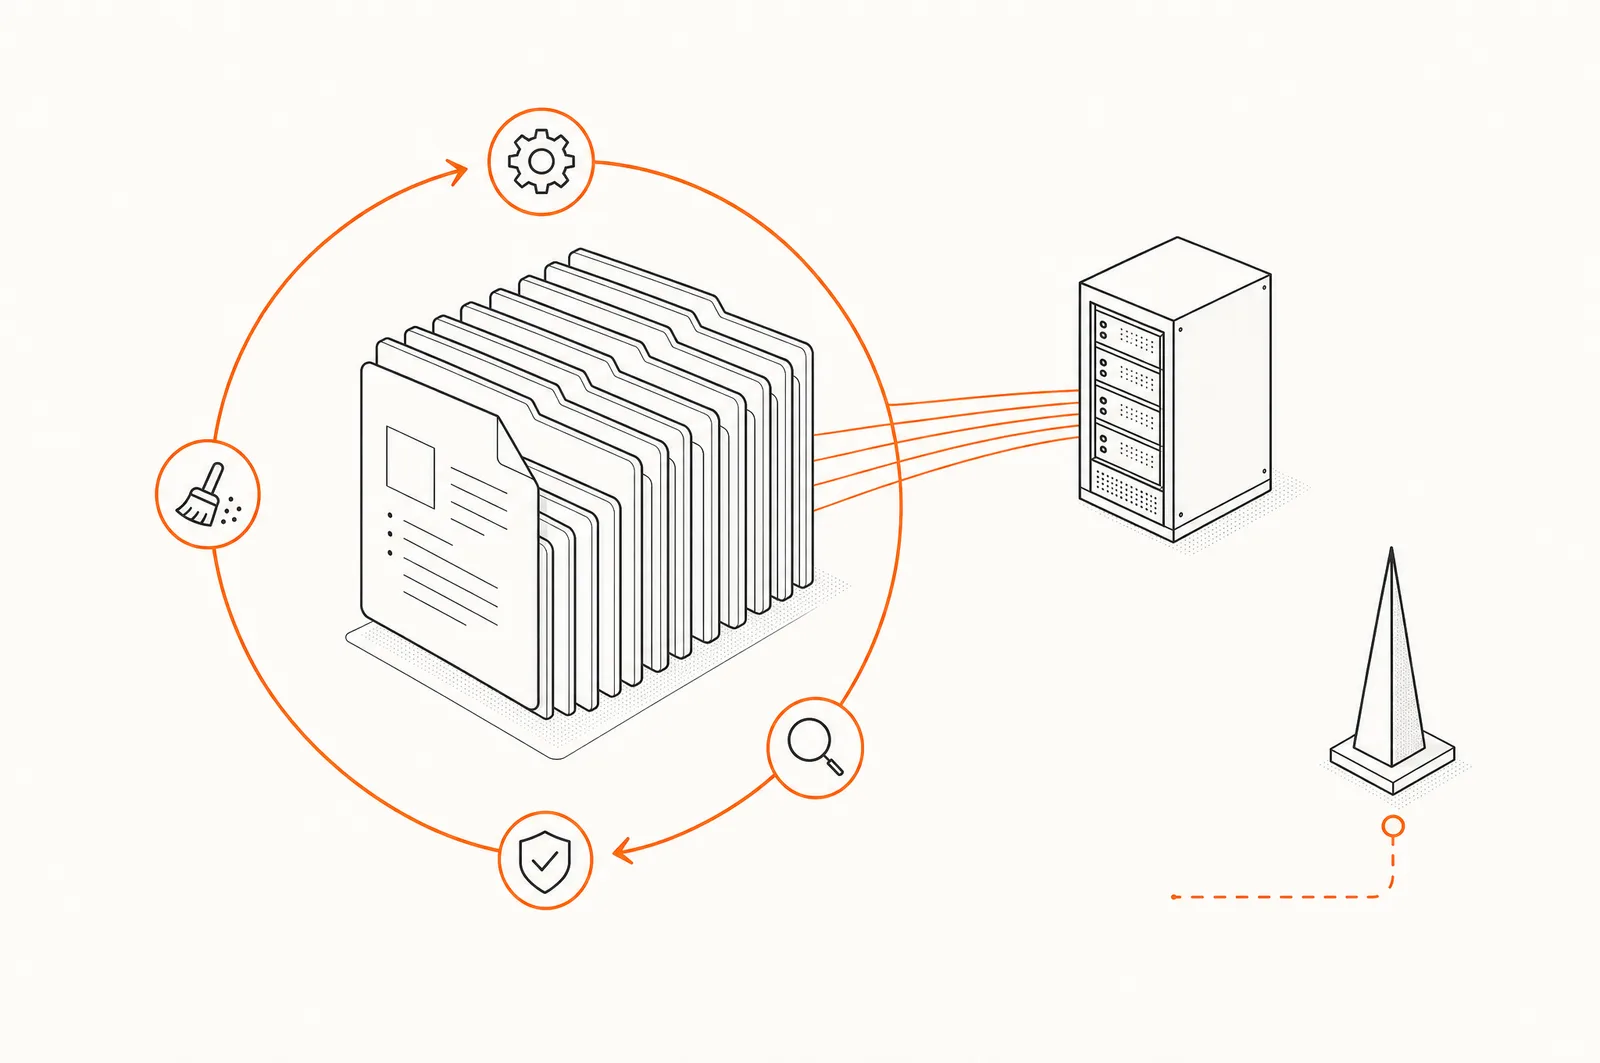
In einem gebauten System ist die Kiste eine Kette. Dokumente werden eingesammelt, zerlegt, indiziert und bei jeder Frage durchsucht, erst danach formuliert ein Modell, und im besten Fall prüft eine weitere Stufe das Ergebnis, bevor es ausgegeben wird. Zerlegt man die Meldung des Technikers entlang dieser Kette, zeigt sich ein anderes Bild: Das Handbuch lag im Index, der richtige Abschnitt stand in der Trefferliste aber erst auf Rang sechs, und an das Modell gingen nur die ersten vier.
Die Reparatur liegt in diesem Fall in der Suche. Am Sprachmodell müsste niemand etwas ändern, und ein Modellwechsel hätte den Fehler bestenfalls überdeckt.
02. Die sieben Stufen eines KI-Features und ihre typischen Fehler
Die folgende Einteilung ist auf Fehlersuche ausgerichtet. Wie die Verarbeitung technisch abläuft, von der Zerlegung über Einbettungen bis zur Neuordnung der Treffer, erklärt der Wissensbeitrag Retrieval-Augmented Generation. Für die Fehlersuche zählt bei jeder Stufe nur, was dort schiefgeht und woran Sie es merken.
1. Eingang. Dokumente, Tickets und Datensätze werden eingesammelt, mit Fassung und Leserechten. Typische Fehler sind ein unvollständiger Bestand, veraltete Fassungen und Scans ohne Textebene. Sie merken es daran, dass Antworten eine überholte Fassung zitieren oder bestimmte Aktenbestände nie auftauchen.
2. Aufbereitung. Texte werden in Abschnitte zerlegt, die einzeln gefunden werden können. Zerreißt die Zerlegung eine Tabelle oder trennt eine Überschrift von ihrem Inhalt, findet die Suche Bruchstücke ohne Zusammenhang. Das Symptom sind Antworten, die eine Zahl ohne ihre Einheit oder Bedingung nennen.
3. Index. Die Abschnitte werden durchsuchbar abgelegt, als Stichwortindex, als Vektorindex oder beides. Fehler entstehen, wenn geänderte Dokumente nicht nachgezogen werden oder Berechtigungen beim Import verloren gehen. Dann zitiert der Assistent Dokumente, die gelöscht sind oder die die fragende Person nicht öffnen dürfte.
4. Abruf. Zur Frage sucht das System passende Abschnitte und übergibt eine begrenzte Anzahl an das Modell. Liegt die richtige Stelle zu weit hinten oder verwendet die Frage andere Wörter als das Dokument, kommt sie nie an. Das Symptom ist eine allgemeine, halb richtige Antwort, obwohl das Wissen im Bestand steht.
5. Modell. Das Sprachmodell formuliert aus Frage, Anweisung und übergebenen Abschnitten eine Antwort. Es kann Abschnitte falsch gewichten, Bedingungen weglassen oder Lücken mit plausiblem Allgemeinwissen füllen. Sie erkennen diesen Fall daran, dass die richtige Stelle nachweislich übergeben wurde und die Antwort trotzdem abweicht.
6. Prüfung. Eine Prüfstufe gleicht Aussagen mit Belegen ab, kontrolliert Format und Rechte und hält im Zweifel eine Antwort zurück. Fehlt sie oder ist sie zu großzügig eingestellt, gehen unbelegte Aussagen durch. Ist sie zu streng, bekommen Nutzer auffällig oft gar keine Antwort.
7. Ausgabe. Die Antwort erreicht ein Zielsystem, etwa eine Oberfläche, ein Ticket oder einen Datensatz. Dort gehen Fußnoten verloren, Zahlen werden umformatiert oder Felder abgeschnitten. Das Symptom ist eine Antwort, die im Protokoll richtig war und beim Nutzer falsch ankommt.
03. Warum die Suche so oft die Ursache ist
Ein Sprachmodell liest bei jeder Frage nur das, was im Kontextfenster liegt, also Anweisung, Frage und übergebene Abschnitte. Das ist vergleichbar mit einem Kollegen, dem man vier Seiten aus einem Ordner in die Hand drückt: Er kann gut formulieren, aber nur über diese vier Seiten. Wie viele Abschnitte übergeben werden, ist eine Einstellung, und jede Einstellung schneidet die Trefferliste an irgendeiner Stelle ab.
Dazu kommt ein Wortproblem. Der Techniker schreibt „Leckrate“, das Handbuch spricht von „Leckage“, und eine reine Stichwortsuche sieht darin zwei verschiedene Begriffe. Vektorsuche und hybride Verfahren mildern das, besonders bei Fachbegriffen, Typenbezeichnungen und zusammengesetzten Wörtern bleibt die Lücke aber ein häufiger Grund für Fehltreffer. Welche Verfahren es gibt und wie sie sich kombinieren lassen, beschreibt der Wissensbeitrag Semantische Suche im Unternehmen.
Beide Effekte sind leise. Die Antwort klingt flüssig, weil das Modell aus den übergebenen Abschnitten etwas Passendes macht, und niemand sieht die Trefferliste, in der die richtige Stelle knapp unter der Grenze steht.
04. Probieren Sie die Suche aus Stufe 4 selbst aus
Die Demonstration arbeitet mit dreizehn erfundenen Abschnitten aus Wartungshandbuch, Norm-Auszug, Datenblatt und Instandhaltungsprotokollen. Voreingestellt ist die Frage des Technikers, bewertet wird mit einer einfachen Stichwortsuche, die seltene Wörter stärker gewichtet. Achten Sie auf die markierte Zeile mit dem Handbuchabschnitt 4.5 Leckage und auf die Angabe, ob er beim Modell ankommt.
Stellen Sie danach sechs Abschnitte im Kontextfenster ein. Schalten Sie anschließend zurück auf vier und aktivieren Sie die Synonymliste.
Diese Stelle müsste eine belegte Antwort zitieren
Wartungshandbuch P-40 · 4.5 Leckage
Tritt an der Dichtung eine Leckage von mehr als 5 Millilitern je Stunde auf, ist die Pumpe außer Betrieb zu nehmen. Der Dichtsatz ist vollständig zu tauschen, ein Nachziehen der Verschraubung genügt nicht.
Rang 6 von 13: Der Abschnitt liegt außerhalb des Kontextfensters, das Modell bekommt diesen Satz nie zu sehen.
- 01 Protokoll Instandhaltung · 12.03., Werk 2 0,249 im Kontext
- 02 Protokoll Instandhaltung · 04.06., Werk 2 0,219 im Kontext
- 03 Lieferantendatenblatt DS-118 · Grenzwerte 0,122 im Kontext
- 04 Wartungshandbuch P-40 · 2.3 Vor dem Eingriff 0,118 im Kontext
- 05 Wartungshandbuch P-40 · 4.2 Schmierung und Fristen 0,111 nicht übergeben
- 06 Wartungshandbuch P-40 · 4.5 Leckage 0,099 nicht übergeben
- 07 Norm-Auszug, interne Fassung · 7.1 Dichtheit 0,093 nicht übergeben
- 08 Wartungshandbuch P-40 · 6.1 Anzugsmomente 0,000 nicht übergeben
- 09 Norm-Auszug, interne Fassung · 5.4 Prüffristen 0,000 nicht übergeben
- 10 Norm-Auszug, interne Fassung · 9.2 Ersatzteile 0,000 nicht übergeben
- 11 Lieferantendatenblatt DS-118 · Werkstoffe 0,000 nicht übergeben
- 12 Lieferantendatenblatt DS-118 · Lagerung 0,000 nicht übergeben
- 13 Protokoll Instandhaltung · 12.03., Werk 2 0,000 nicht übergeben
- Abschnitte im Bestand: 13
- Suchwörter mit Treffer: 2 von 3
- Rang der Fundstelle: 6 von 13
- Beim Modell angekommen: nein
Mit sechs Abschnitten rutscht der Handbuchabschnitt gerade noch ins Kontextfenster. Mit der Synonymliste steigt er auf Rang 1, weil die Suche „Leckrate“ nun auch als „Leckage“ versteht. Beide Korrekturen liegen in Stufe 4, und keine davon berührt das Sprachmodell.
05. Was die Demonstration zeigt und wo sie aufhört
Die zwei Korrekturen haben unterschiedliche Preise. Mehr Abschnitte im Kontextfenster verlängern jede Anfrage und geben dem Modell mehr Material, das es falsch gewichten kann. Eine Synonymliste wirkt gezielt, muss aber von jemandem gepflegt werden, der die Sprache der Dokumente und die Sprache der Fragenden kennt.
Probieren Sie auch die Frage „Wann ist die Pumpe undicht?“. Ohne Synonymliste landet der richtige Abschnitt auf Rang 5, mit ihr auf Rang 1, und direkt dahinter steht der Norm-Auszug mit seiner Definition von Dichtheit. Das ist ein gutes Ergebnis, weil beide Stellen zusammen die vollständige Antwort ergeben.
Die Demonstration hat bewusst enge Grenzen. Sie rechnet ohne Einbettungen, ohne Neuordnung und ohne Sprachmodell, und ihr Bestand ist so klein, dass sich jede Zeile nachvollziehen lässt. Die Rangzahlen sind Rechenergebnisse der Demonstration und keine Messwerte aus einem System, das Muster dahinter gilt aber auch in großen Beständen: Eine richtige Antwort setzt voraus, dass die richtige Stelle ankommt.
06. Eine Testmenge macht Fehler zählbar
Einzelne Meldungen zeigen, dass etwas schiefgeht, aber nicht, wie oft. Dafür braucht es eine feste Sammlung echter Fragen, zu denen vorher notiert ist, welche Fundstelle eine richtige Antwort zitieren müsste. Einige Dutzend solcher Fragen aus dem Alltag genügen für einen ersten Stand.
Die Testmenge trennt zwei Fragen, die in einer Fehlermeldung vermischt sind. Die erste lautet, ob die richtige Fundstelle im Kontextfenster angekommen ist; wenn nicht, liegt der Fehler in den Stufen 1 bis 4. Die zweite lautet, ob die Antwort aus der angekommenen Stelle richtig und belegt formuliert ist; wenn nicht, liegt er in Modell, Anweisung oder Prüfung.
Nach jeder Änderung an Zerlegung, Index, Suche, Modell oder Anweisung läuft dieselbe Testmenge erneut. So wird sichtbar, ob eine Änderung geholfen oder an anderer Stelle etwas verschlechtert hat. Wie sich Antworten an Quellen binden und bewerten lassen, bis hin zu menschlichen Stichproben, behandelt der Wissensbeitrag KI-Antworten prüfen. Warum diese Auswertung eine laufende Position ist und keine Projektphase, steht in Was ein RAG-System im Betrieb wirklich kostet.
07. In welcher Reihenfolge Sie eine Fehlermeldung eingrenzen
Für eine einzelne Meldung lohnt eine feste Reihenfolge, weil jeder Schritt ganze Stufen ausschließt. Wer beim Modell beginnt, prüft zuerst die Stelle, an der der Fehler am seltensten sichtbar wird.
- Frage und erwartete Fundstelle festhalten. Ohne die Stelle, die eine richtige Antwort zitieren müsste, lässt sich kein Fehler belegen.
- Prüfen, ob die Fundstelle im Index liegt, in der gültigen Fassung und mit den richtigen Rechten. Fehlt sie, liegt die Ursache in Stufe 1 bis 3.
- Den Rang der Fundstelle in der Trefferliste ansehen. Liegt sie hinter der Grenze des Kontextfensters, liegt die Ursache in Stufe 4.
- Wurde die Stelle übergeben, Anweisung und Antwort vergleichen. Weicht die Antwort trotzdem ab, liegt die Ursache in Stufe 5.
- Zuletzt Prüfstufe und Ausgabe kontrollieren, also ob eine belegte Antwort zurückgehalten, gekürzt oder umformatiert wurde.
Dafür braucht das System ein Suchprotokoll, das zu jeder Antwort festhält, was gefunden, was übergeben und was verwendet wurde. Fehlt dieses Protokoll, bleibt nur Raten, und die Fehlersuche endet wieder beim Modell.
08. Wann ein KI-Feature nicht die passende Lösung ist
Nicht jede Frage aus dem Betrieb braucht sieben Stufen. Lässt sich eine Frage als feste Abfrage formulieren, etwa nach einem Termin oder einem Stammdatum, ist eine Datenbank genauer und günstiger als jedes Sprachmodell.
Zwei weitere Fälle scheitern vor der Technik. Kursieren drei Fassungen desselben Handbuchs, muss zuerst festgelegt werden, welche gilt. Und ohne eine Person, die neue Fassungen einpflegt und alte zurückzieht, veralten die Antworten, ohne dass es jemand bemerkt.
Löst ein einzelner Fehler Zahlungen, Sicherheitsrisiken oder Stillstand aus, gehört ein Mensch an die Entscheidung. Ob die Pumpe P-40 wieder anläuft, entscheidet der Techniker, und der Assistent liefert ihm die Fundstelle dazu. Wie weit Ihr eigener Bestand für ein solches System vorbereitet ist, lässt sich mit dem RAG-Readiness-Check einschätzen, welche Bausteine eine Umsetzung umfasst, beschreibt die Seite KI-Entwicklung.
Dazu arbeiten wir