

PROJECTAI
RegioWizard
Een werkend prototype dat de regionale wiki van het district Ahrweiler in gewone taal beantwoordt: met een voetnoot bij elke bewering, een kaart, een redactietafel en een zichtbaar zoekprotocol.
4.295
artikelen in de lokale index
20.543
opvraagbare tekstpassages
1.040
gelokaliseerde vermeldingen
De kennis is er allang, alleen kan niemand haar iets vragen
 AI-GEGENEREERD
De AW-Wiki op aw-wiki.de verzamelt al jaren wat er over het district Ahrweiler bekend is: verenigingen, gebouwen, wijngaarden, wandelpaden, gemeenteraden, bedrijven, gebeurtenissen, mensen. Ongeveer 39.000 artikelen in de hoofdnaamruimte, geschreven en onderhouden door mensen uit de regio.
Wie daar iets zoekt, moet echter weten waarnaar hij zoekt. Een zoekveld beantwoordt de vraag „welke verenigingen in Dernau zijn door de overstroming getroffen?” niet. Het vindt pagina's met het woord Dernau. De rest doet de mens.
Precies daar zit het gat: het corpus is er, de vragen zijn er, en ertussen ontbreekt een systeem dat beide verbindt zonder iets te verzinnen. RegioWizard is ons antwoord daarop: een draaiend prototype, geen conceptnotitie.
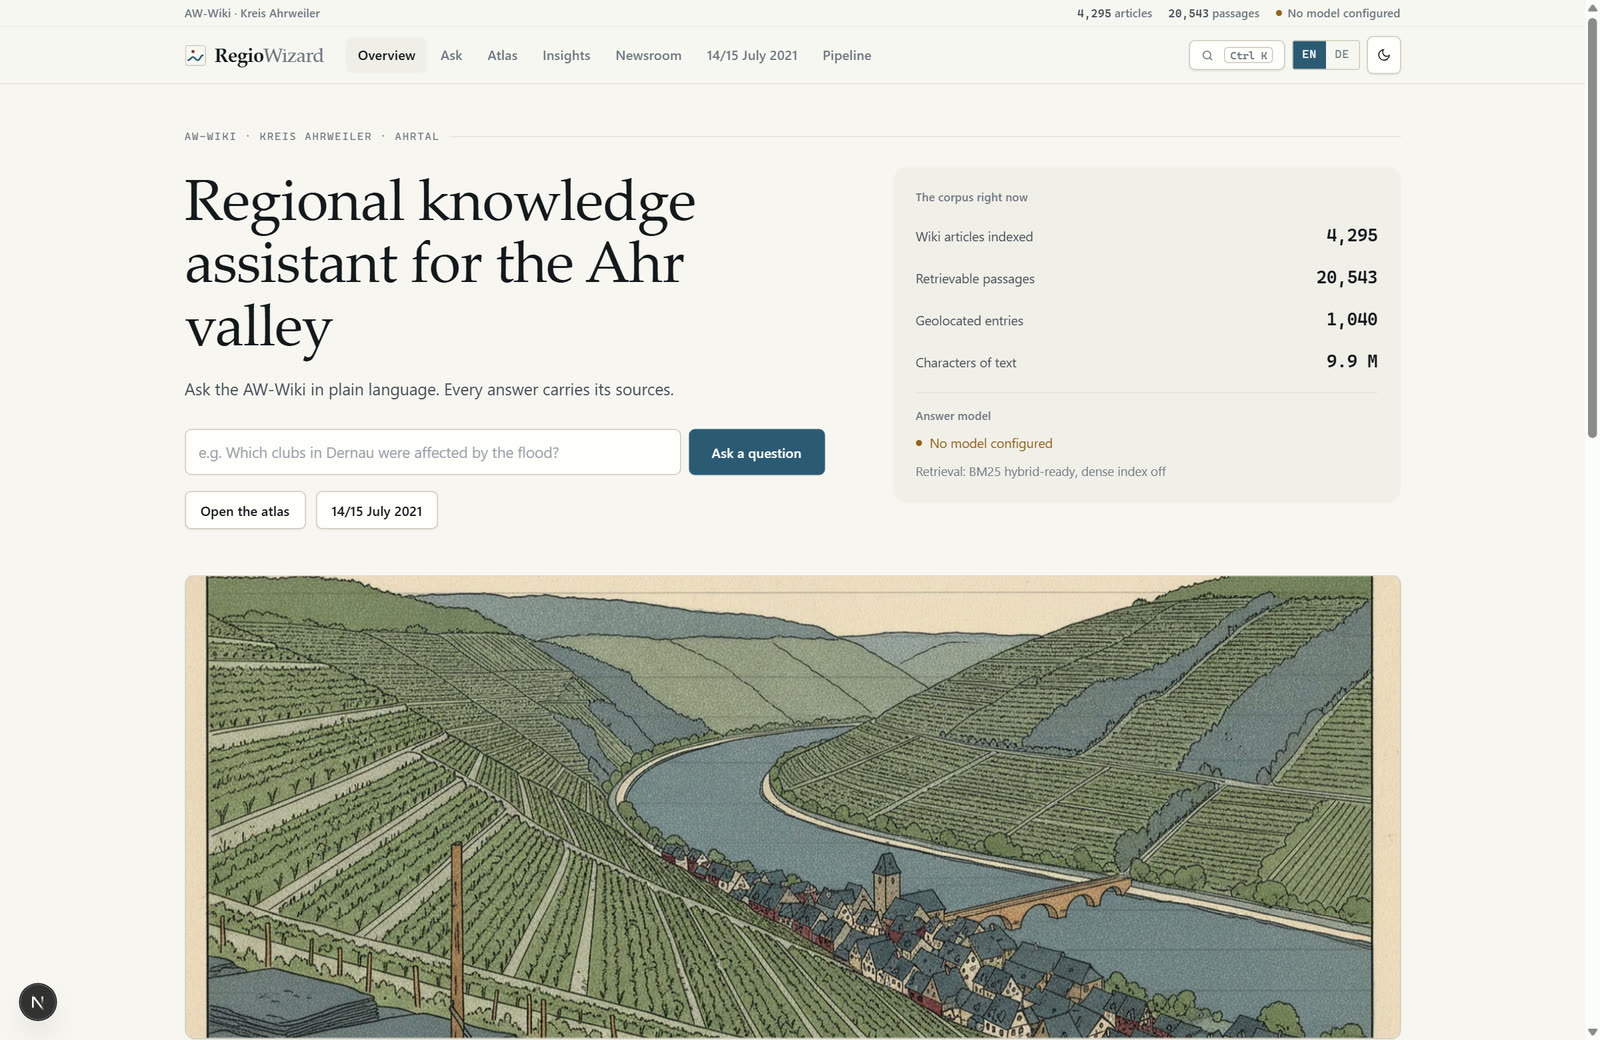
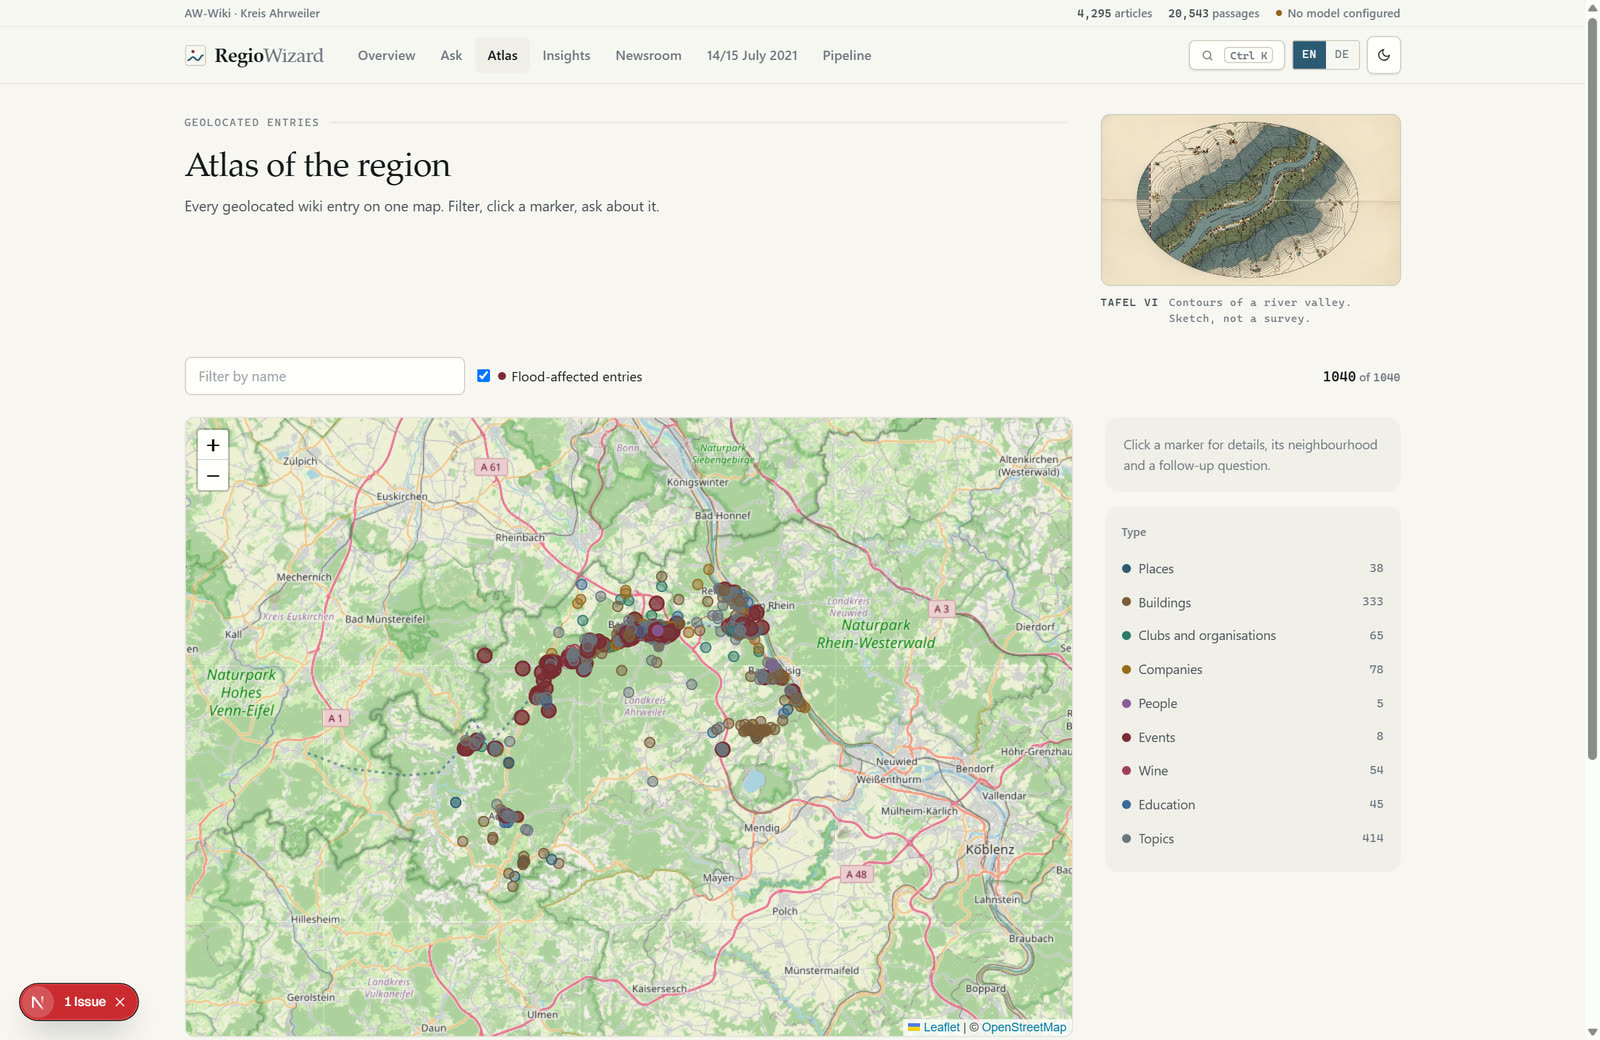
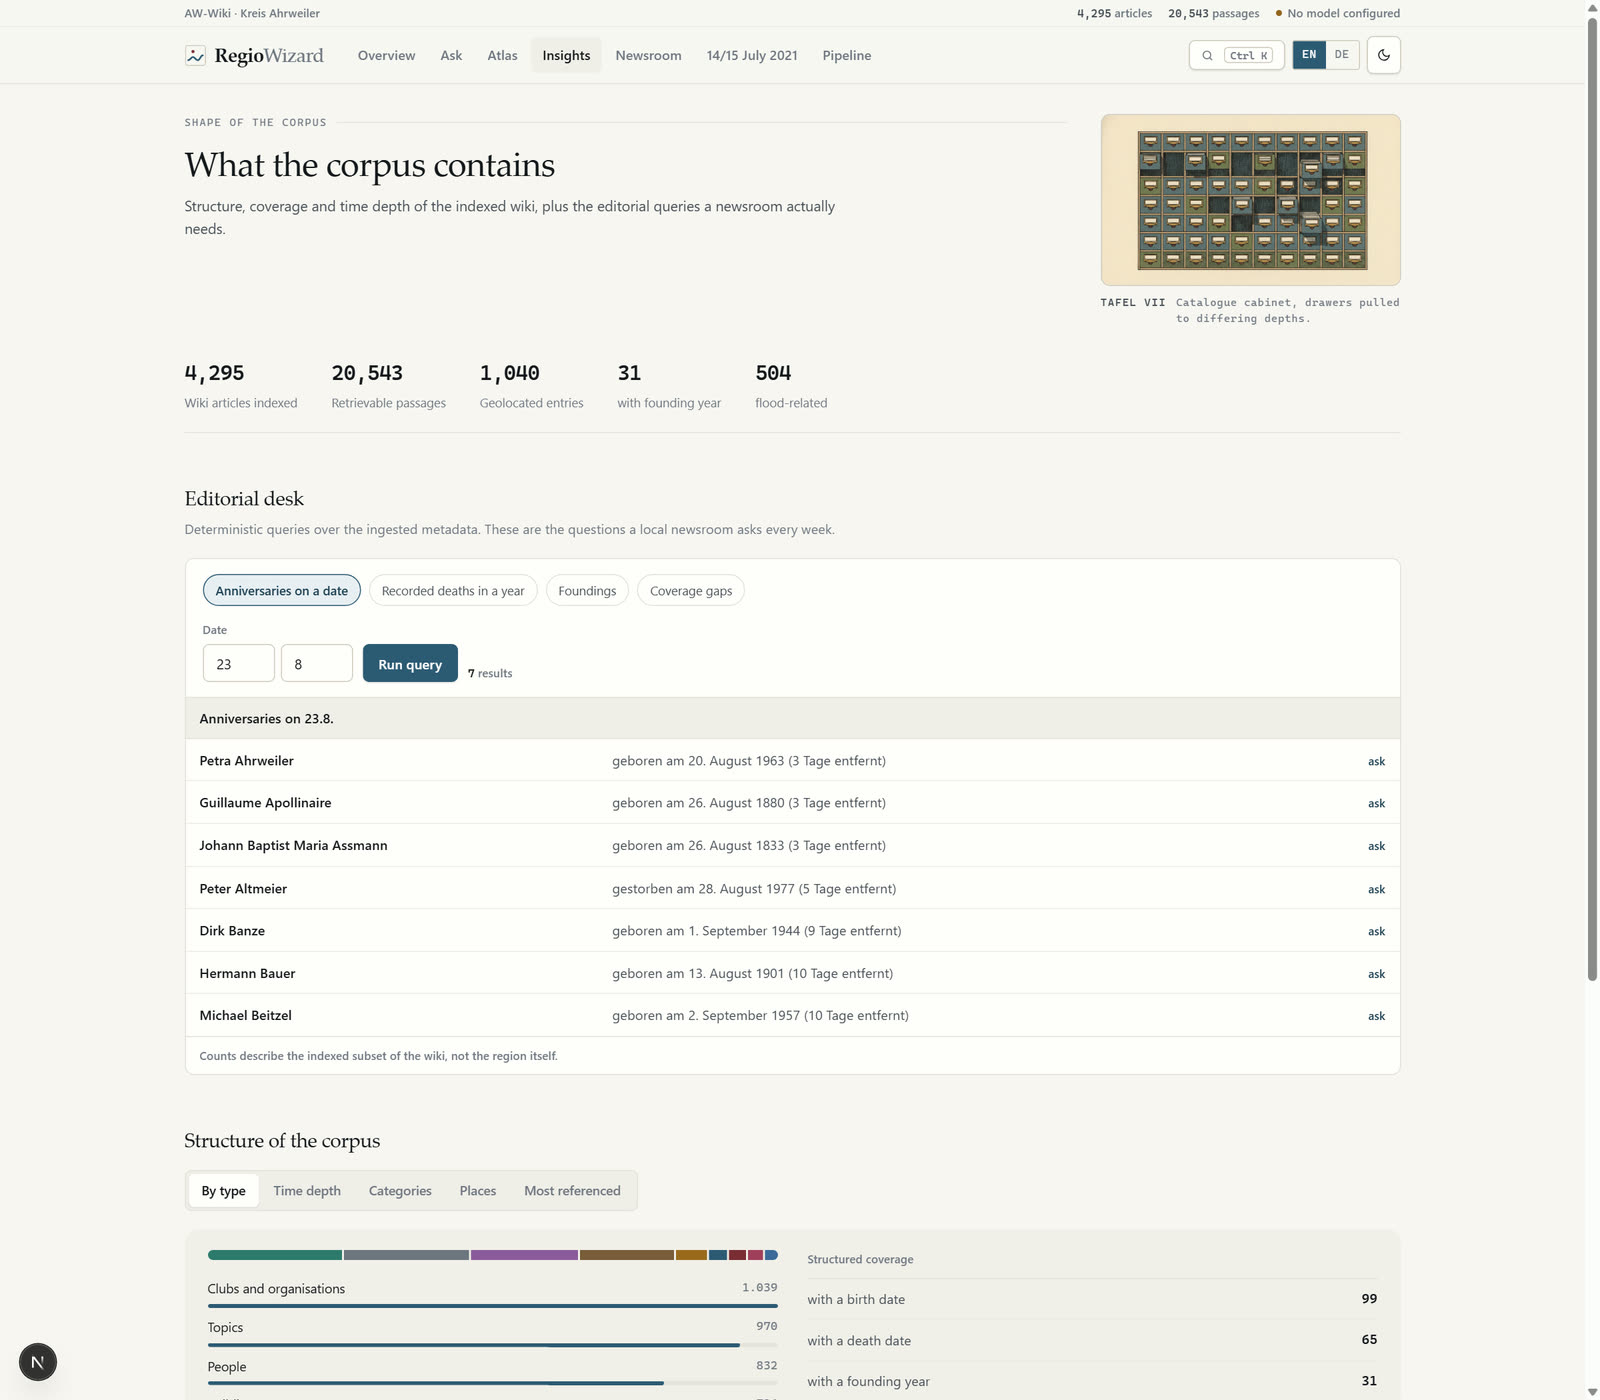
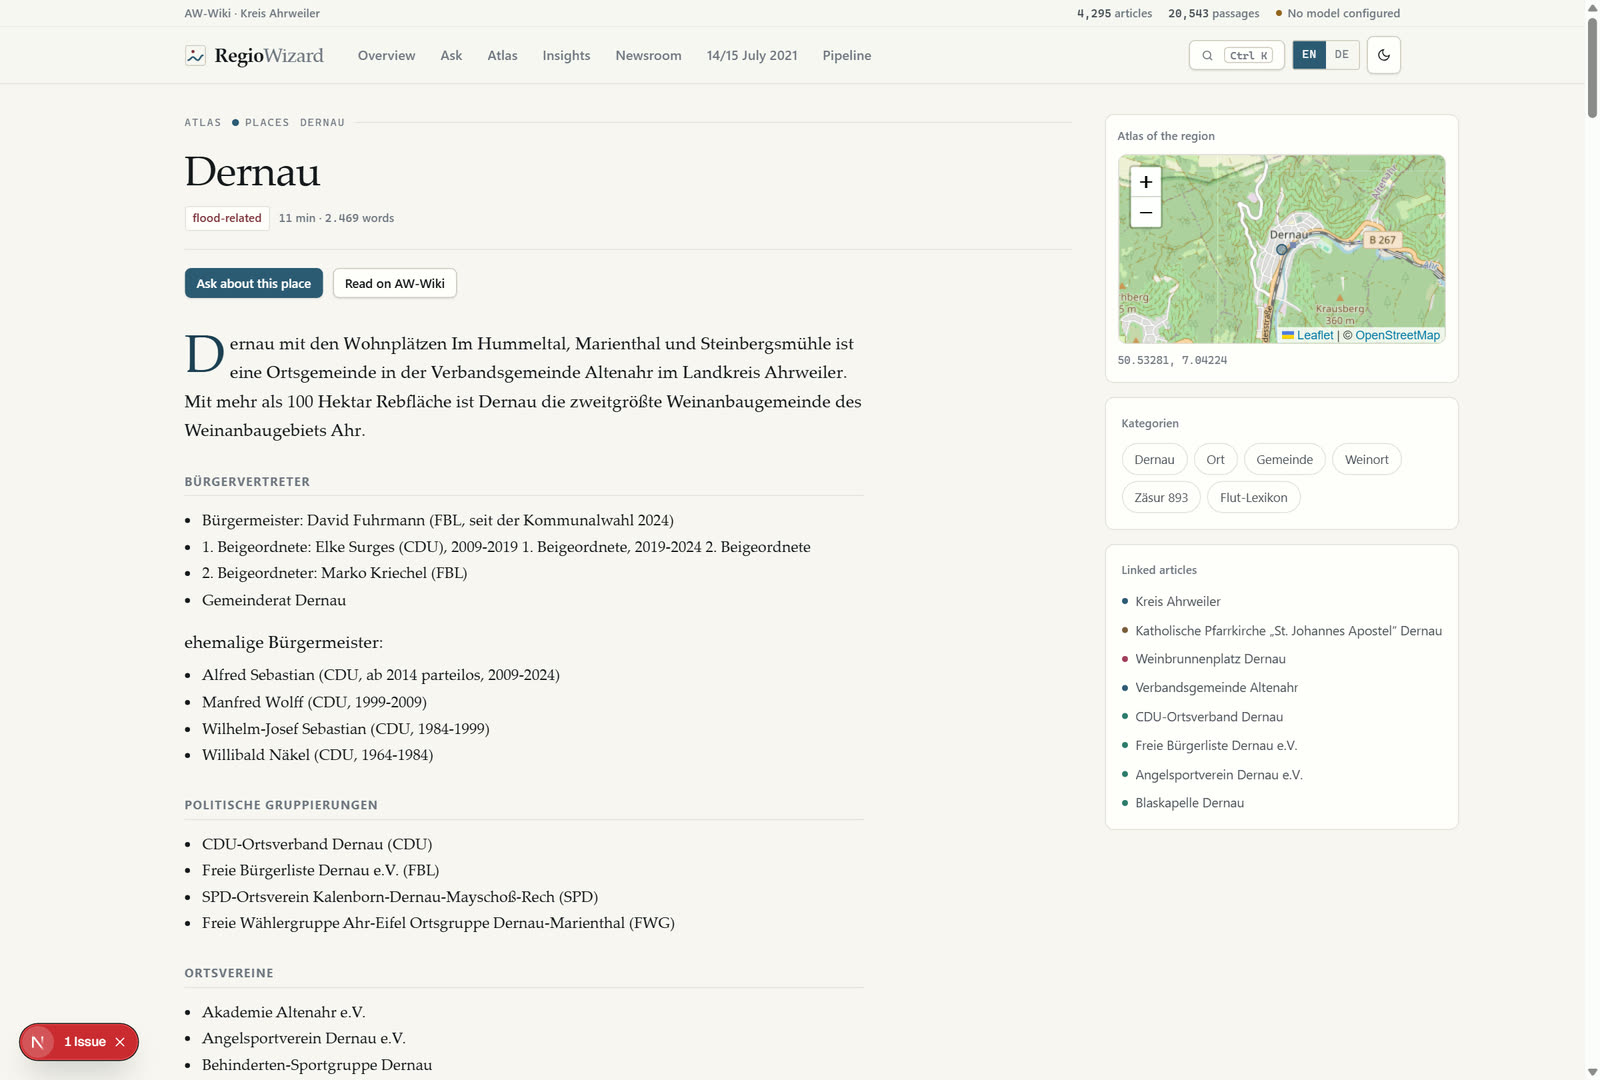
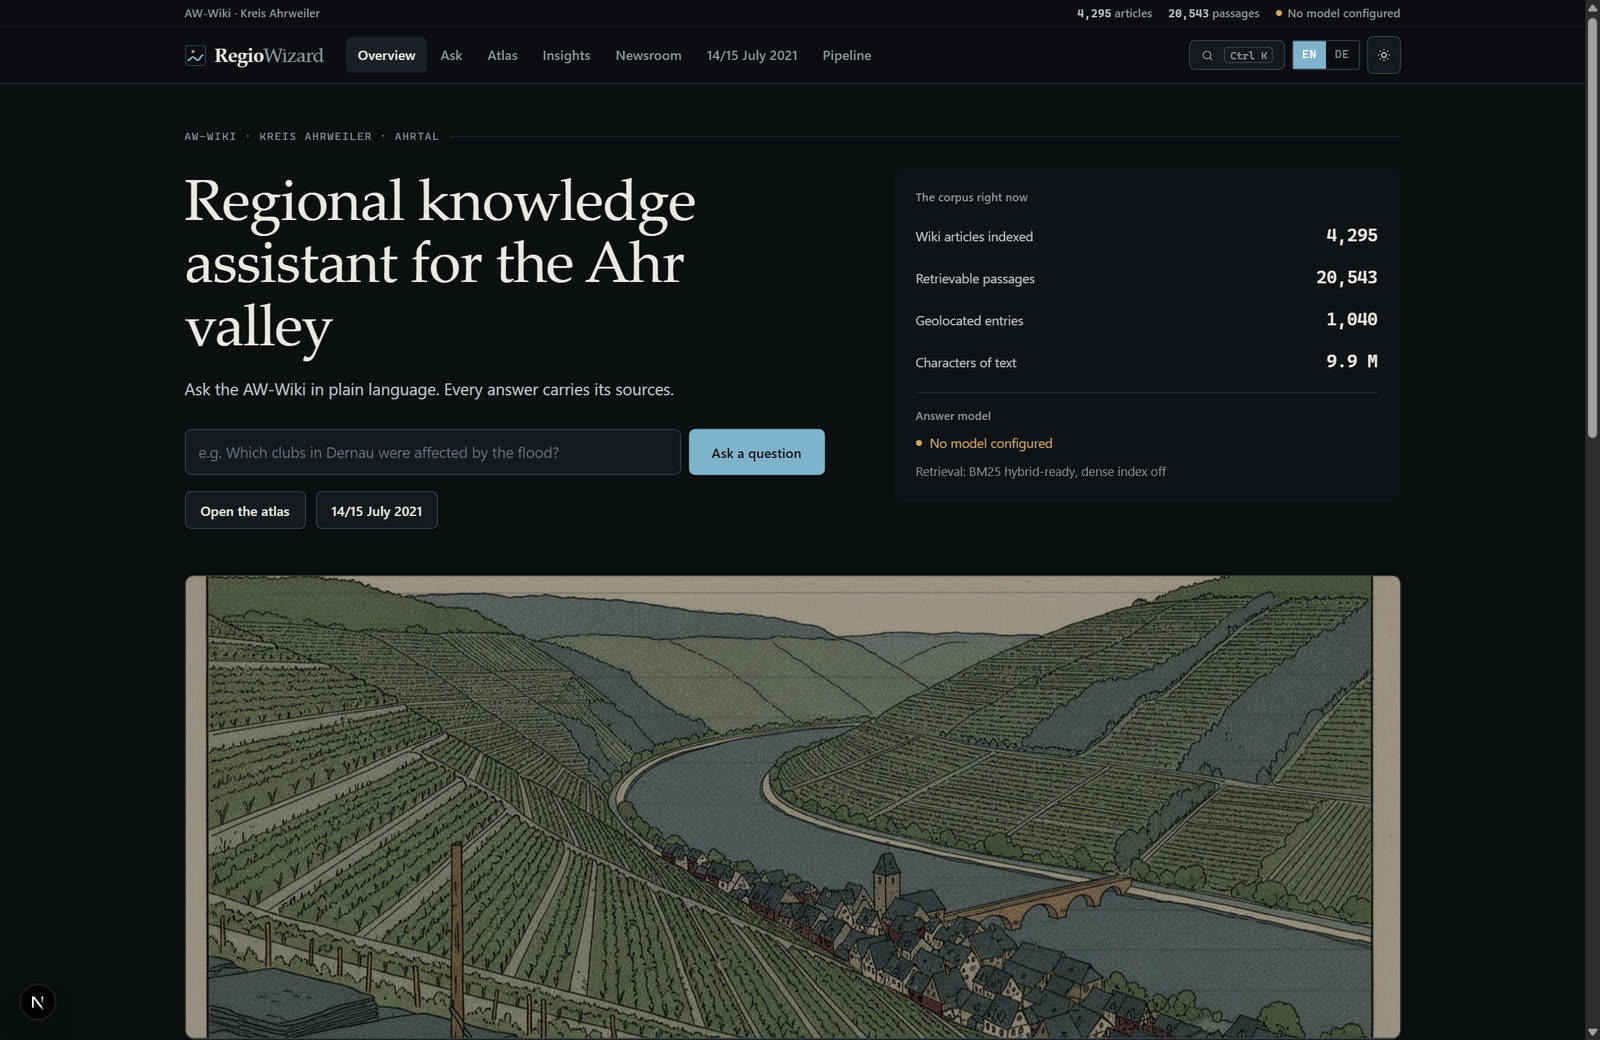
Zeven weergaven op één enkel corpus
Alles in het prototype leest dezelfde lokale index. Er is geen tweede gegevensbron die uit de pas kan gaan lopen.
- Vragen - onderbouwde antwoorden in hele zinnen, met filters en zoekprotocol.
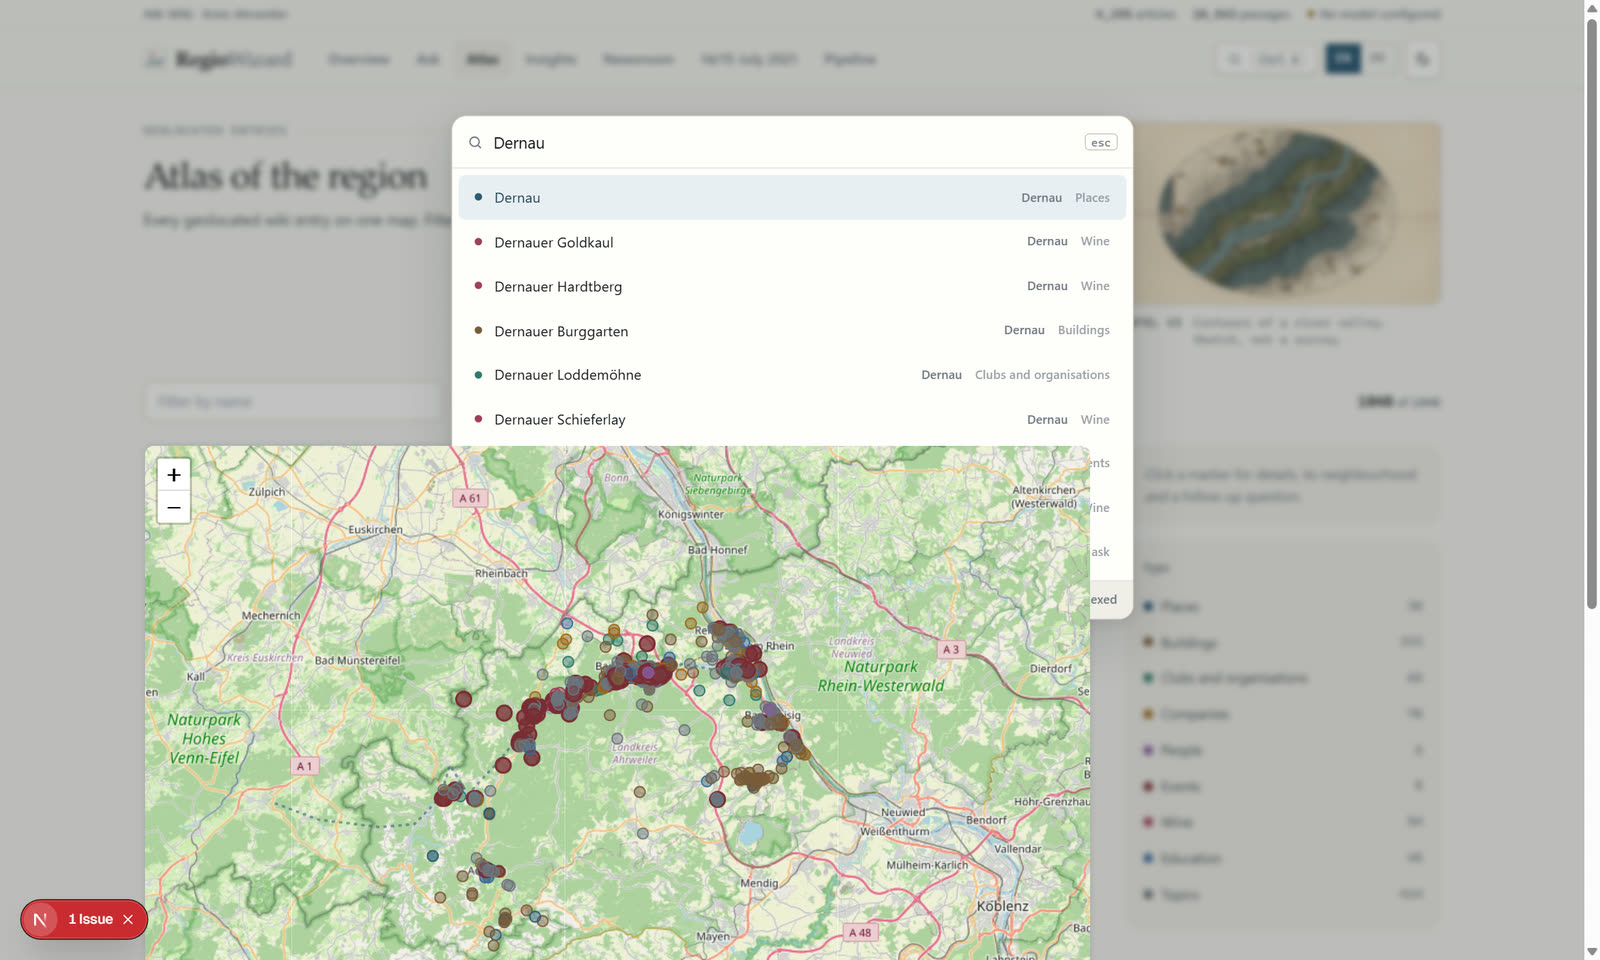
- Atlas - elke gelokaliseerde vermelding op één kaart, overstromingslaag optioneel, omgeving binnen 3 km.
- Analyse - structuur en tijddiepte van het corpus, plus de redactietafel.
- Redactie - de vergelijking van verse perstekst met de wiki.
- 14/15 juli 2021 - de documentatie van de nacht van de overstroming, bewust ingetogen gebouwd.
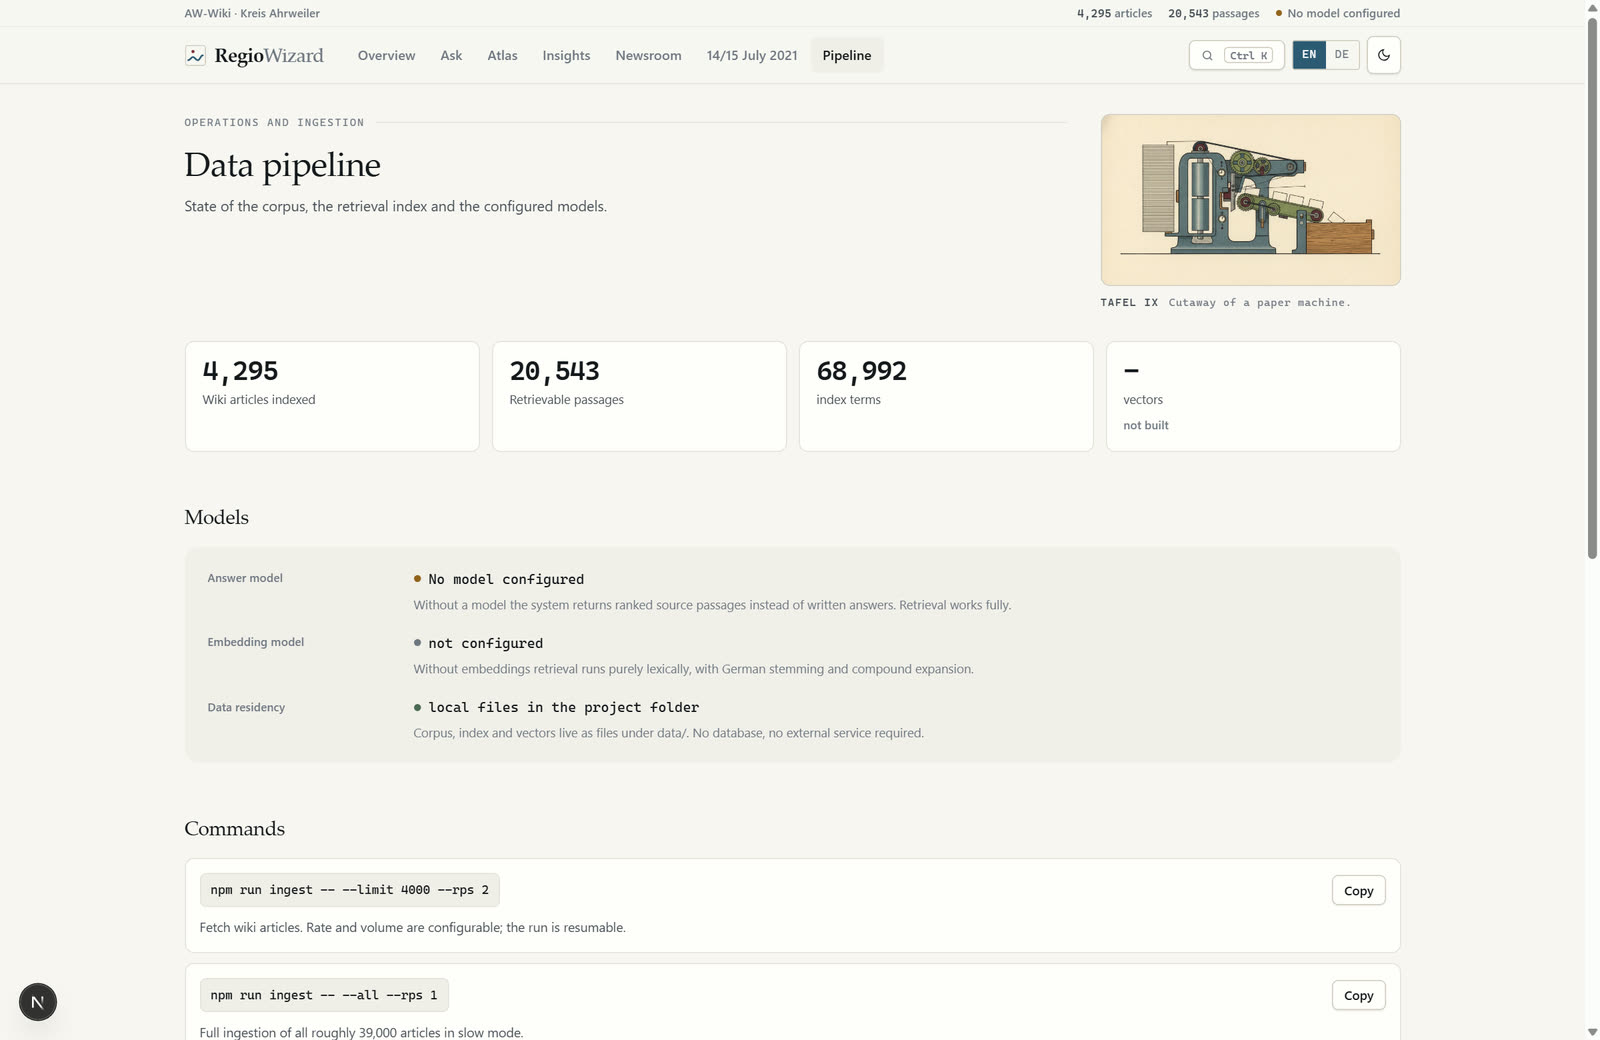
- Pipeline - de staat van verzameling, index en modellen, open in te zien.
- Artikelweergave - elk artikel als leesversie, met verwijzing naar het origineel in de wiki.
Daarbij een opdrachtenpalet op Ctrl + K dat alle 4.295 titels beheerst: typen, springen. Vindt het niets, dan wordt de invoer als vraag doorgegeven.
Elke bewering noemt haar bron, of er is geen bewering
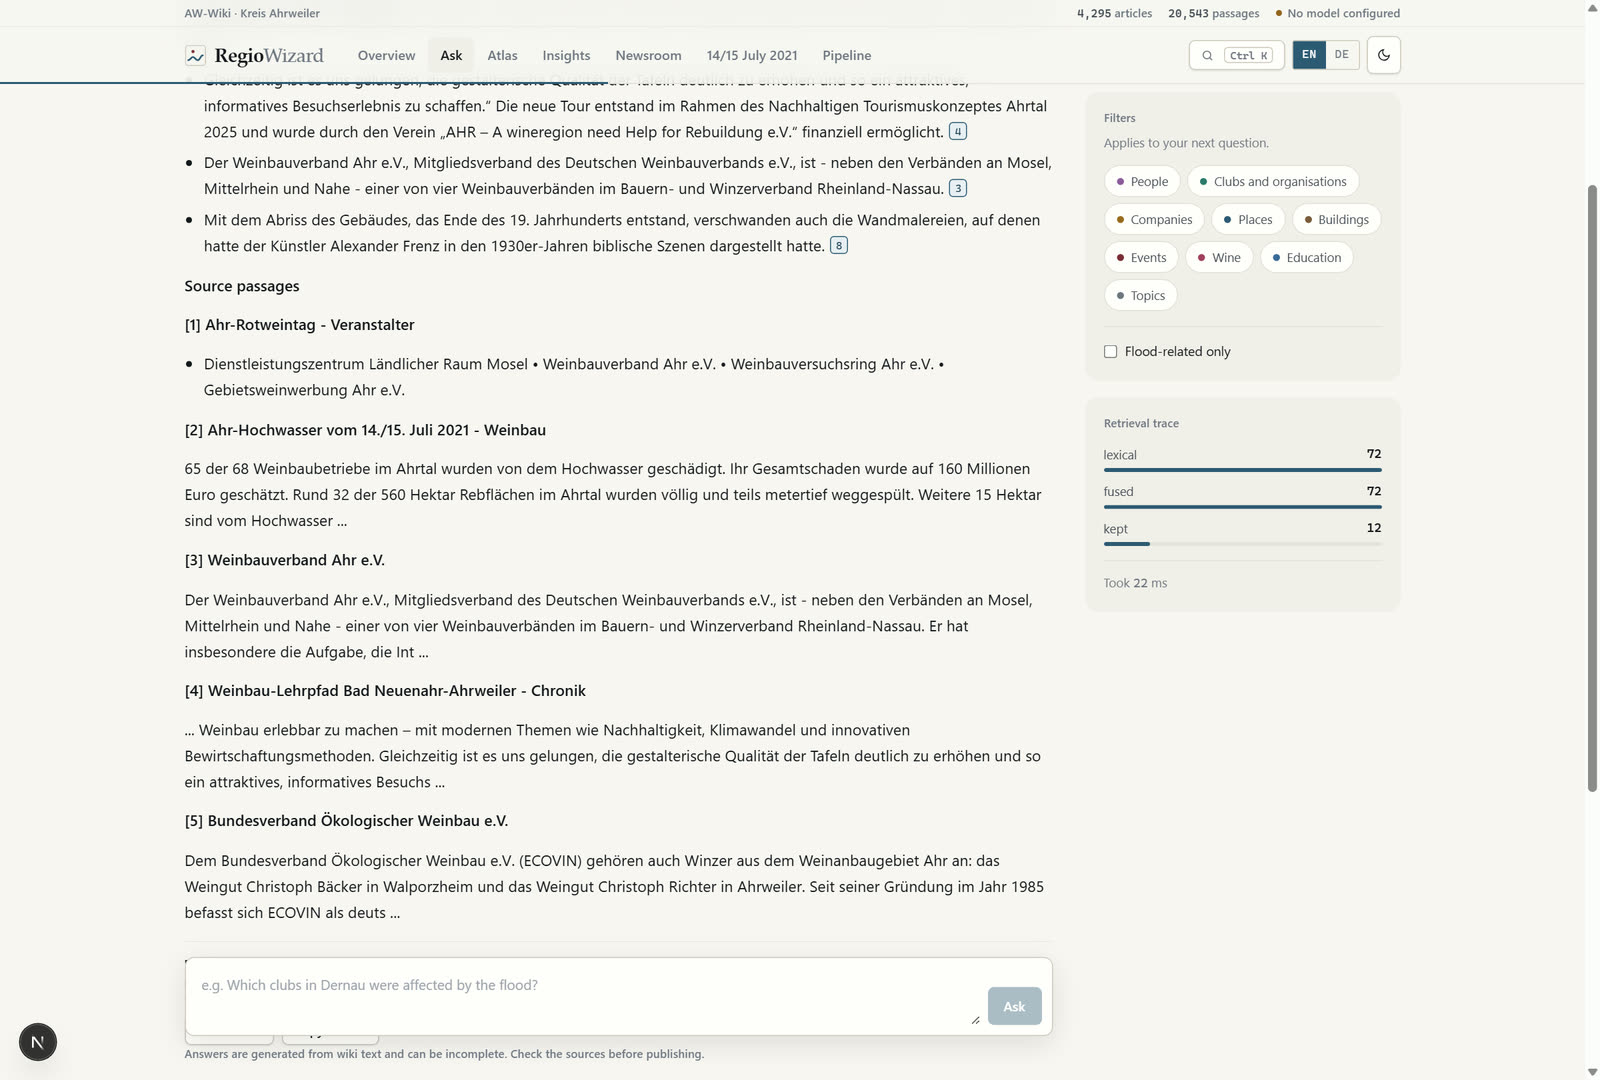
Dat is de regel waaraan al het andere hangt. Het taalmodel formuleert uitsluitend uit de tekstpassages die de zoekactie vooraf heeft gevonden, en markeert elke bewering met een voetnoot. De voetnoot is aanklikbaar en opent de passage waaruit ze stamt: titel, hoofdstuk, bewoording.
Belangrijker is het geval zonder model. Is er geen geconfigureerd, dan verzint het systeem niets en meldt het ook geen fout: het toont de best passende zinnen uit de wiki, letterlijk en met bron, met daaronder de gevonden passages volledig. Deze extractieve modus is een volwaardige weg, geen storingstoestand.
Daar is een praktische reden voor. Een redactie die een gegeven overneemt, staat ervoor in. Een instrument dat een bron alleen beweert in plaats van haar te tonen, is in die situatie waardeloos.
Een datum is een verzamelingsbewerking, geen gelijkeniszoekopdracht
„Wie uit de regio is vandaag jarig?” klinkt als een vraag voor een AI. Het is een databasequery, en vectorzoeken beantwoordt die stelselmatig slecht: het vindt teksten die over verjaardagen gaan, niet mensen die vandaag jarig zijn.
Daarom herkent het prototype deze vragen en leidt ze naar vaste query's over de gestructureerde velden: geboorte- en sterfdata, oprichtingsjaren, coördinaten, categorieën. Zo worden beantwoord: jubilea op een datum, geregistreerde sterfgevallen van een jaar, oprichtingen, nabijheid en - het geval waar redacties het meest aan hebben - thematische leemtes: artikelen waarnaar vaak verwezen wordt, maar die zelf dun zijn of geheel ontbreken.
Het resultaat is een tabel met naam, datum en bron. Geen lopende tekst die getallen bij elkaar raadt.
 AI-GEGENEREERD
Traceerbaarheid is een functie, geen debugmodus
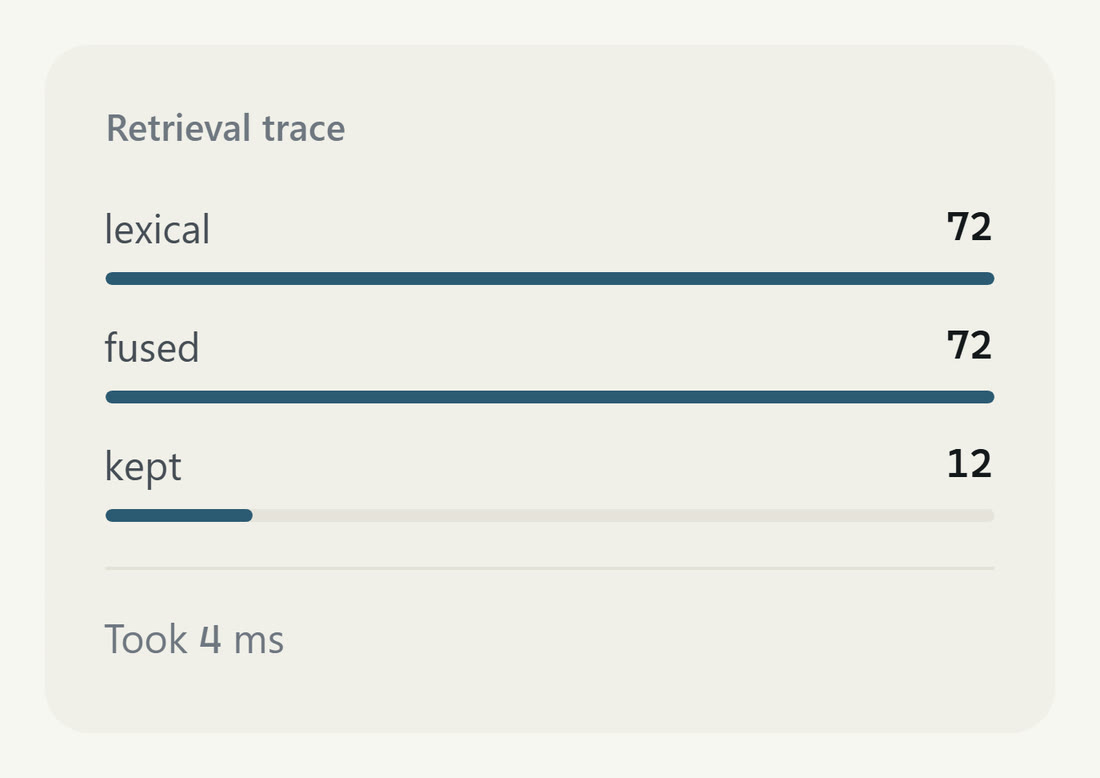
Onder elk antwoord staat hoe het tot stand kwam: hoeveel kandidaten het trefwoordzoeken opleverde, hoeveel het vectorzoeken, hoeveel er na de samenvoeging overbleven, hoeveel er werkelijk in het antwoord terechtkwamen, en hoe lang dat duurde. In de getoonde run: 72 lexicaal, 72 samengevoegd, 12 gebruikt, 120 milliseconden.
Het zoeken zelf is voor het Duits gebouwd. Umlauten worden genormaliseerd, stammen gereduceerd, samenstellingen ontleed - Weinbau vindt ook Weinbaubetrieb. Elke passage draagt een vaste kopregel met titel, hoofdstuk, type, plaats en categorieën, zodat zij begrijpelijk blijft zodra zij uit haar artikel is gelicht.
We tonen dat niet uit technische liefhebberij. Wie een gegeven hergebruikt, moet kunnen zien hoe smal of hoe breed de basis was.
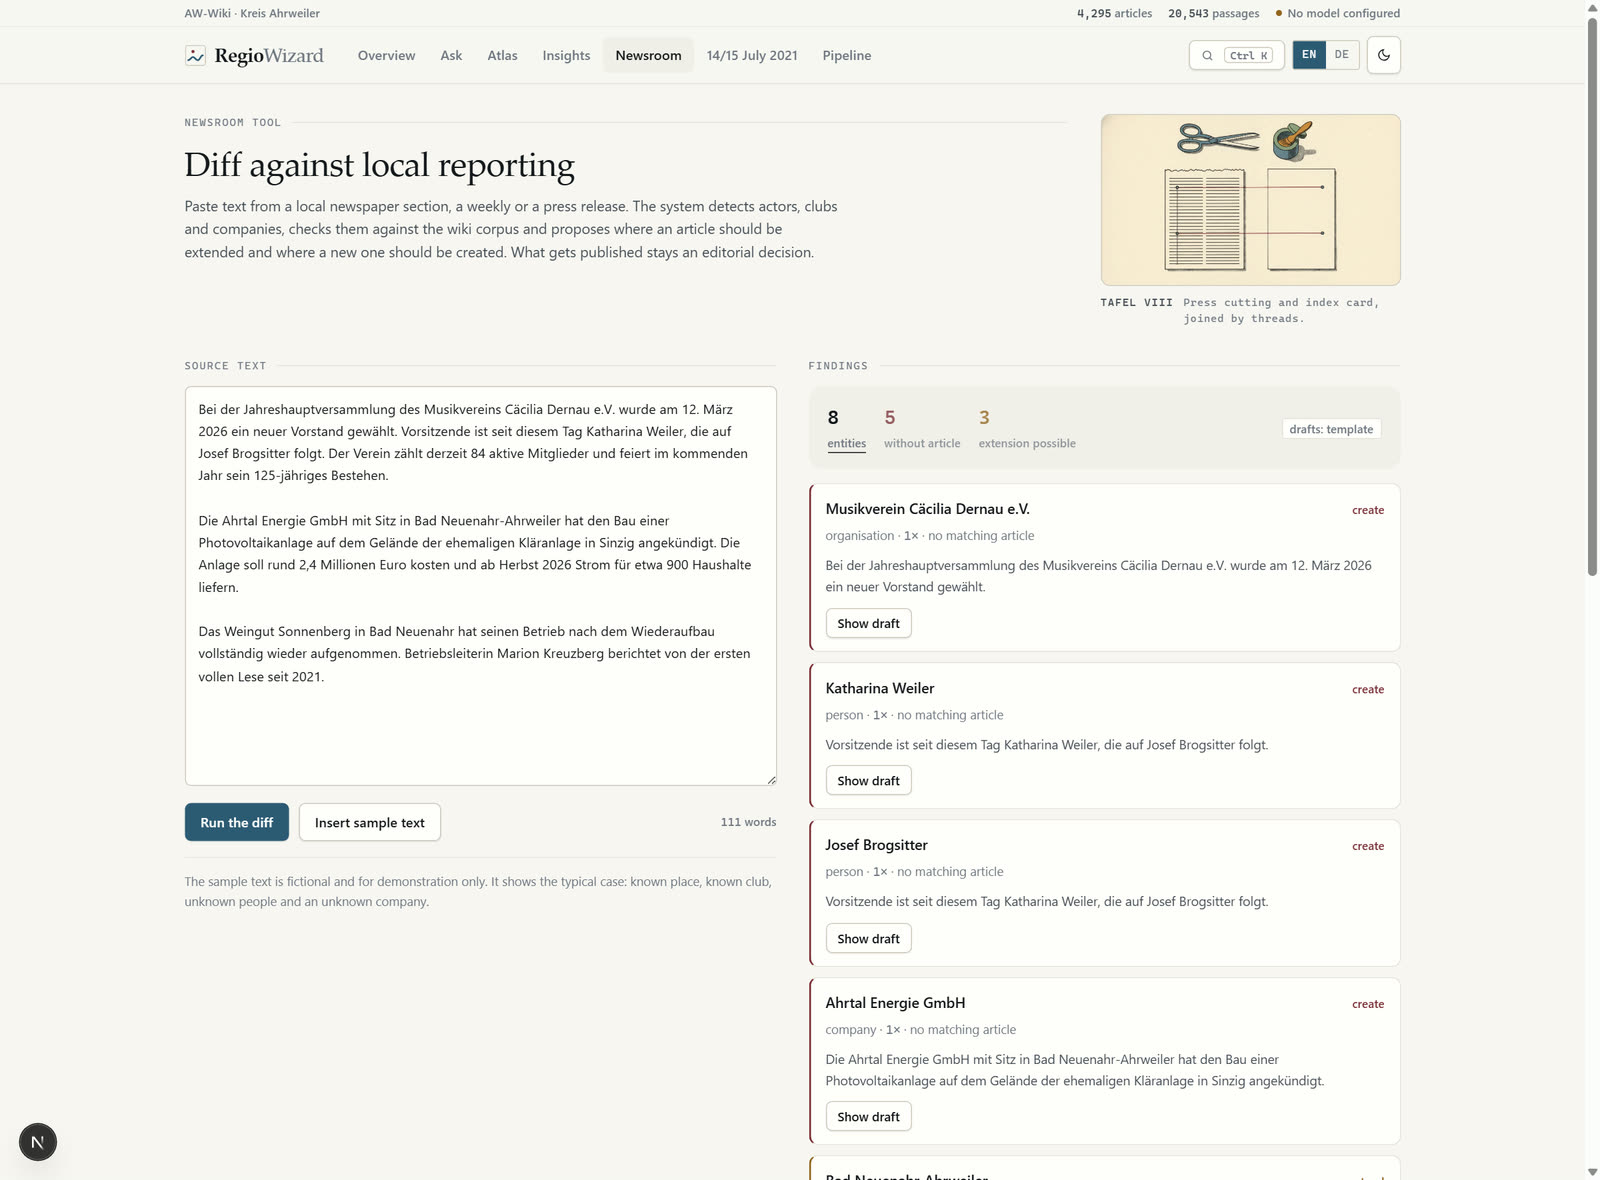
De vergelijking: wat in de krant staat en in de wiki ontbreekt
Een regionale wiki veroudert precies daar waar het heden gebeurt: in de streekpagina's, in het huis-aan-huisblad, in het persbericht van de vereniging. De redactie ziet die berichten toch al elke dag. Ze ook nog in de wiki overzetten kost tijd die niemand heeft.
De redactietafel neemt een tekst en vergelijkt hem met het corpus. Personen, verenigingen, bedrijven en plaatsen worden herkend; elke vondst wordt tegen de bestaande artikelen getoetst en krijgt een van drie toestanden: al vastgelegd, artikel bestaat, uitspraak ontbreekt, geen artikel. In het getoonde voorbeeld: 8 entiteiten, 5 zonder artikel, 3 met mogelijke aanvulling.
Bij elk voorstel hoort een concept in wiki-formaat om te kopiëren. Beslissend is wat het systeem niet doet: het schrijft niets in de wiki. De keuze blijft bij de redactie - geen technische beperking, maar de taakverdeling die wij juist achten.
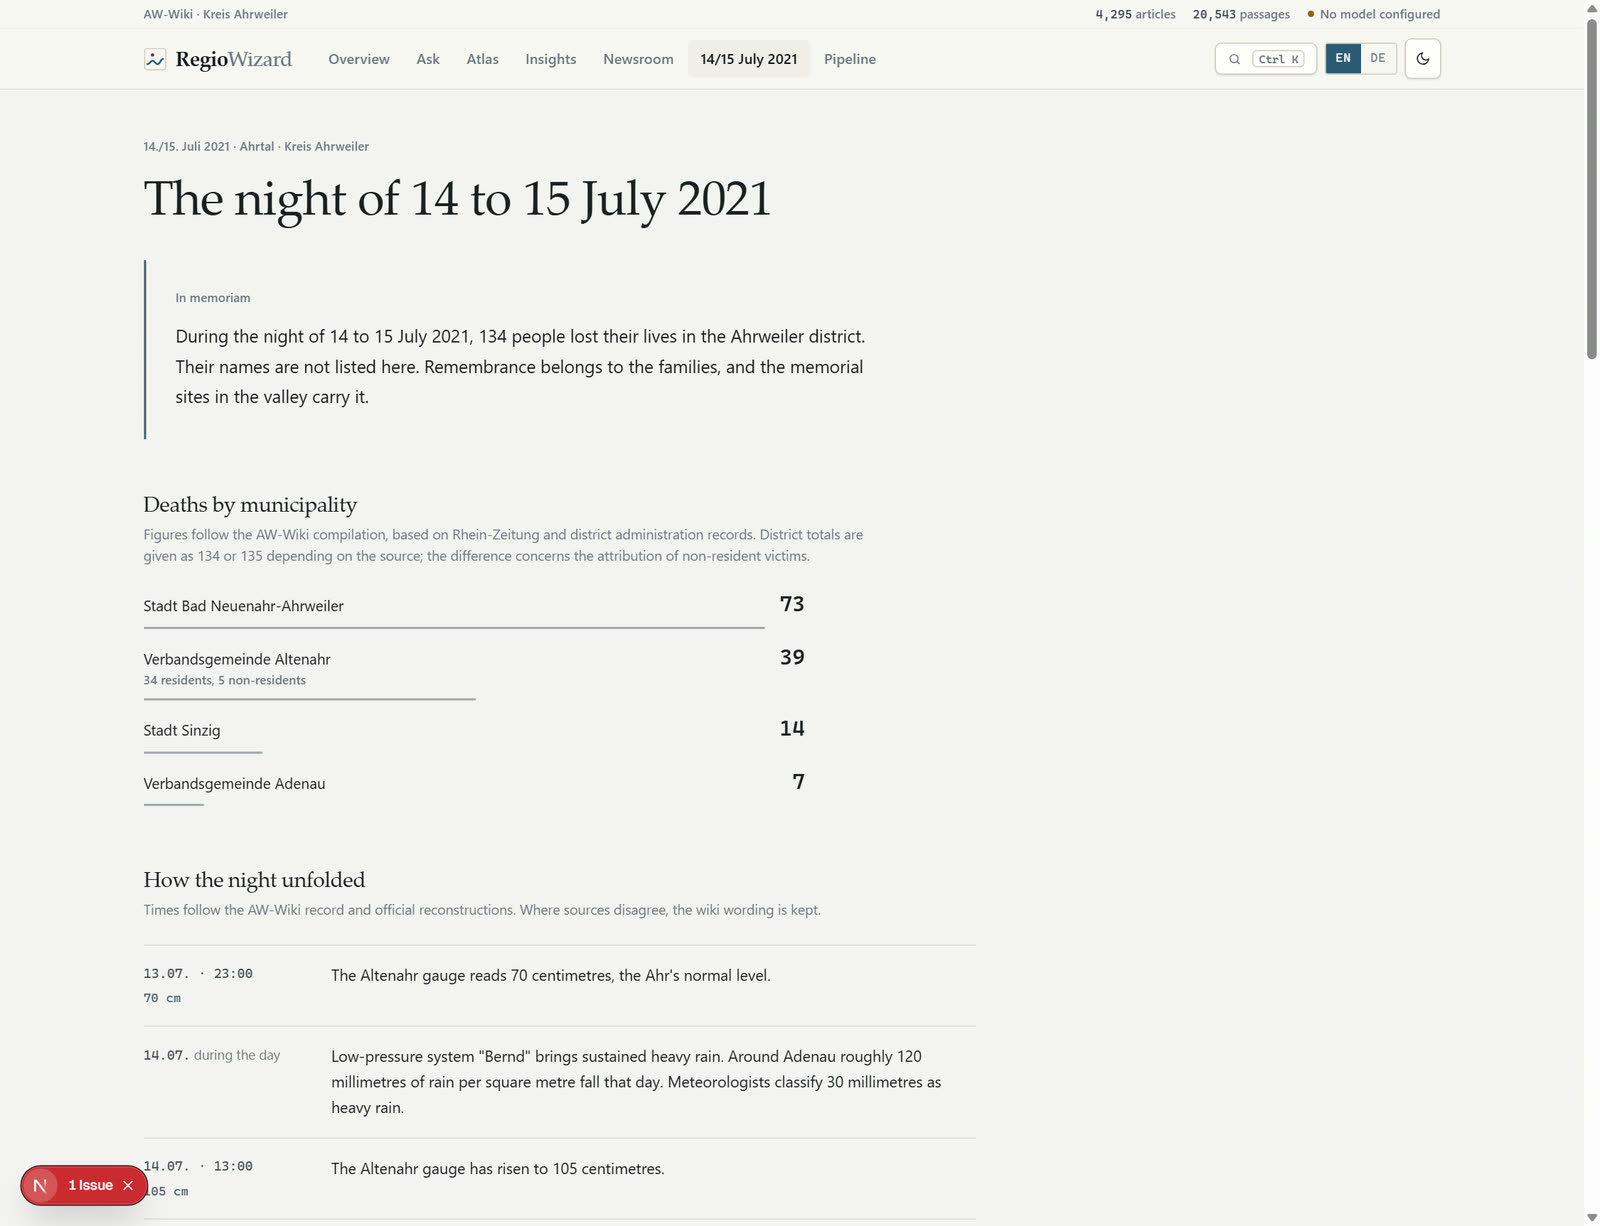
De overstromingspagina documenteert, zij ensceneert niet
Het corpus bevat talrijke artikelen die verband houden met de overstroming van 14 en 15 juli 2021. Een eigen pagina daarvoor was onvermijdelijk; de vraag was hoe zij eruit mocht zien.
Wij hebben haar onder vaste voorwaarden gesteld, en die voorwaarden zijn onderdeel van het product, geen stijlkwestie: een waarschuwing vóór de inhoud, geen namen van slachtoffers, geen beelden, geen animaties, geen oplopende getallen, geen aandachtsprikkels, een gedempt kleurenpalet dat zich van de rest van de toepassing onderscheidt.
Gegevens op die pagina staan met hun bron. Waar bronnen verschillen, wordt het verschil benoemd in plaats van gladgestreken.
Waar het prototype nu staat - en wat er in 2025 aan voorafging
Eerlijk over de omvang: 4.295 van de circa 39.000 artikelen zijn verzameld, gekozen op relevantie voor de typische vragen. Daaruit ontstaan 20.543 tekstpassages, 68.992 indextermen en 1.040 gelokaliseerde vermeldingen. De verzameling respecteert de snelheidsbegrenzing van de wiki; voor het volledige bestand zou een database-export de juiste weg zijn, geen 39.000 losse opvragingen.
De toepassing draait volledig lokaal: corpus, index en vectoren liggen als bestanden in de projectmap. Geen database, geen externe dienst, geen tracking, geen cookies - het enige verzoek aan derden in de browser zijn de kaarttegels.
Alle illustraties in het prototype zijn tekeningen, met een beeldmodel gemaakt en als zodanig aangeduid. Geen daarvan toont een echte plaats, een echt bouwwerk of een echt persoon. Dat is opzet: een toepassing waarvan de hele belofte de aantoonbaarheid is, mag geen beeld uitleveren dat men voor een foto zou kunnen houden.
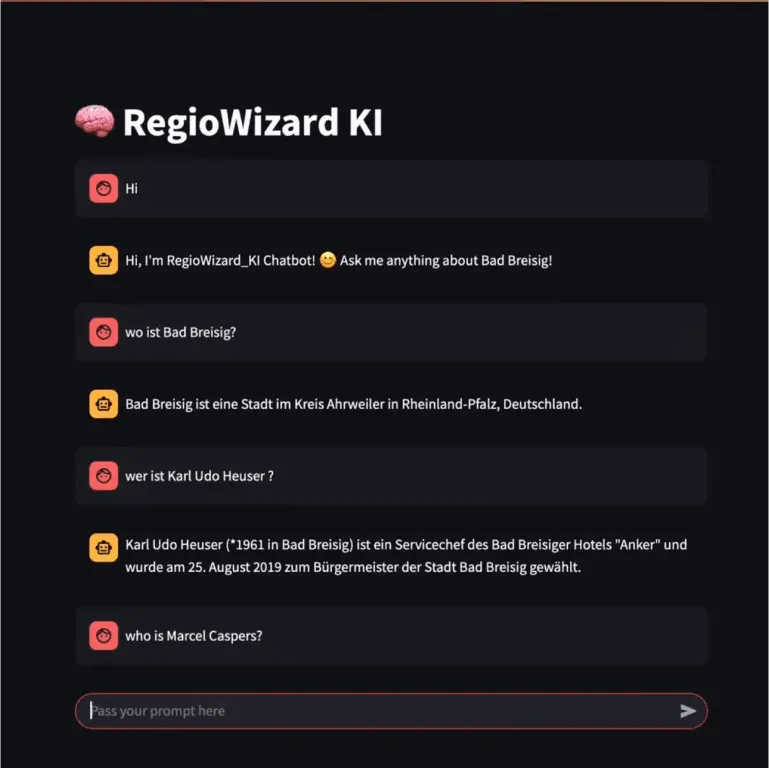
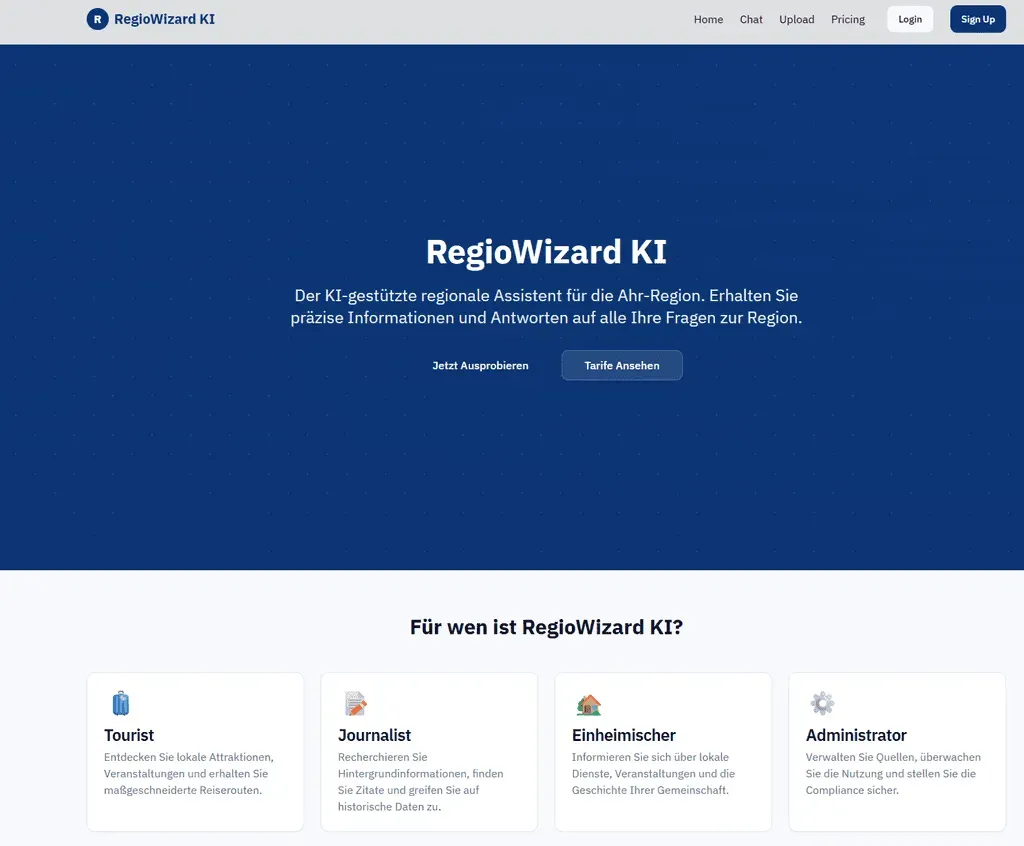
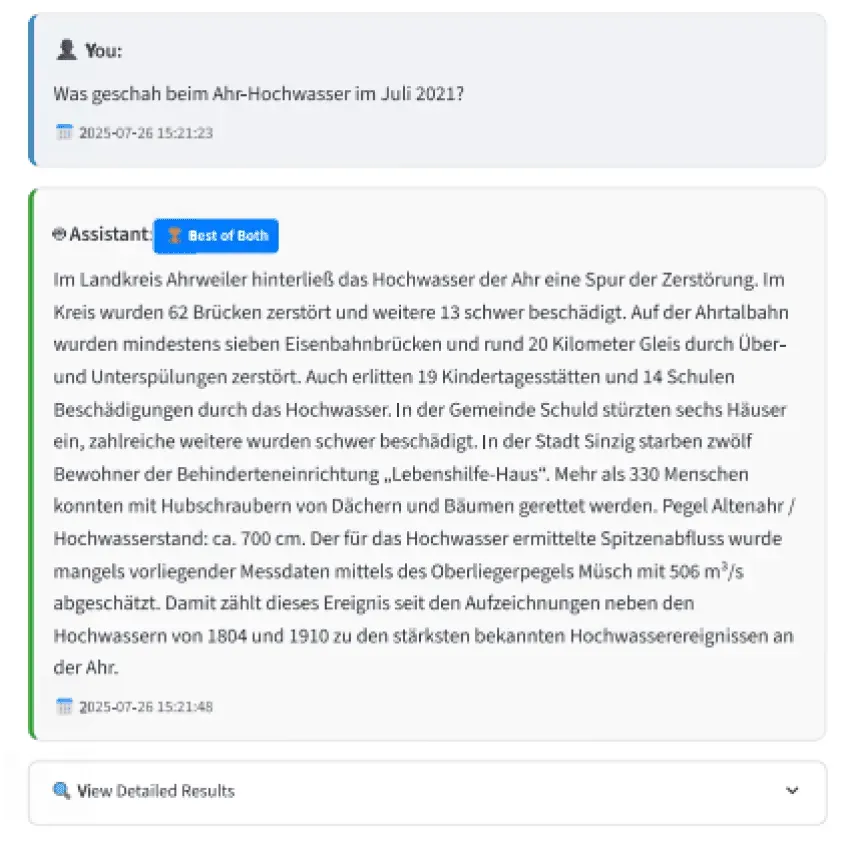
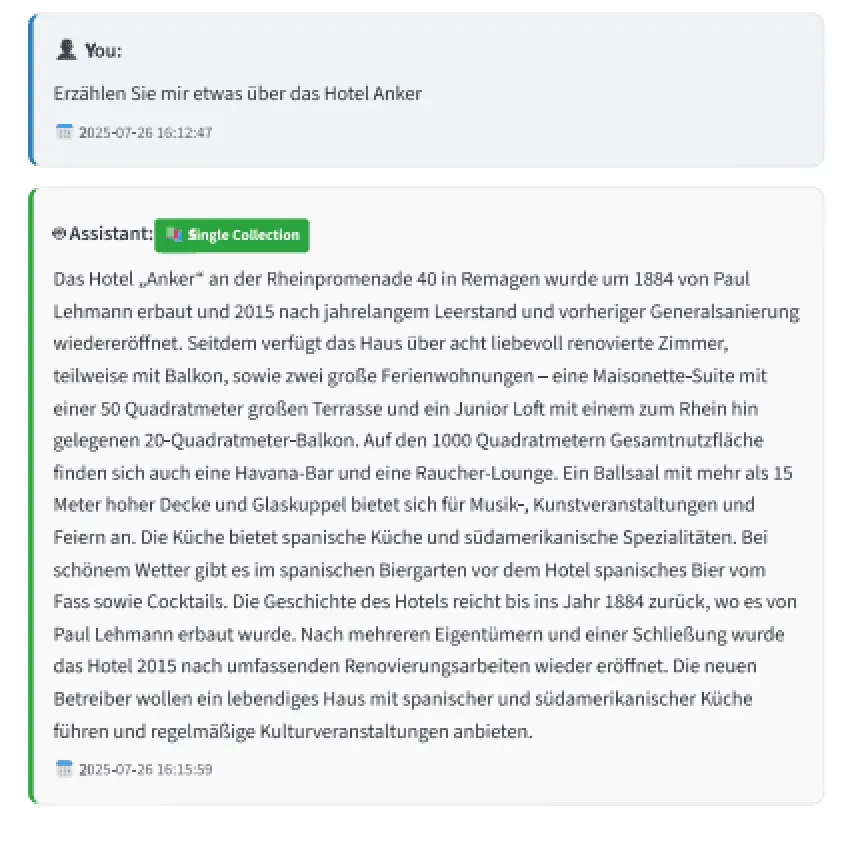
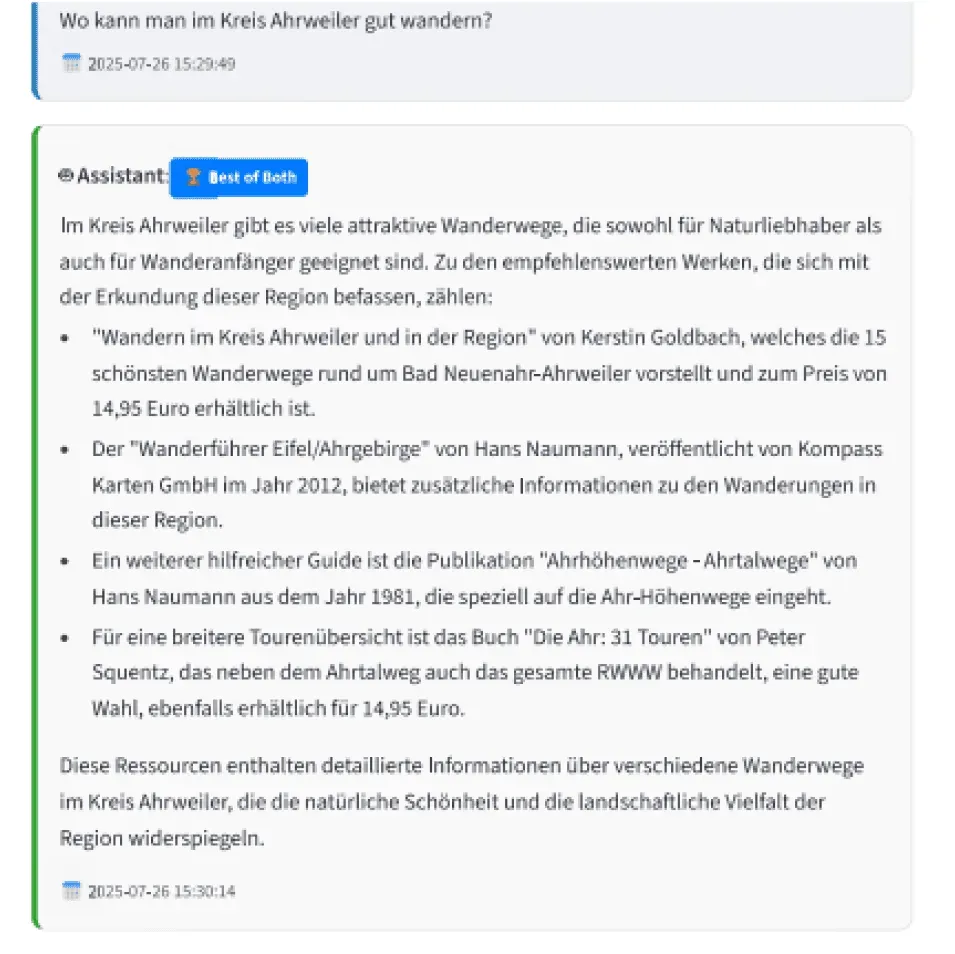
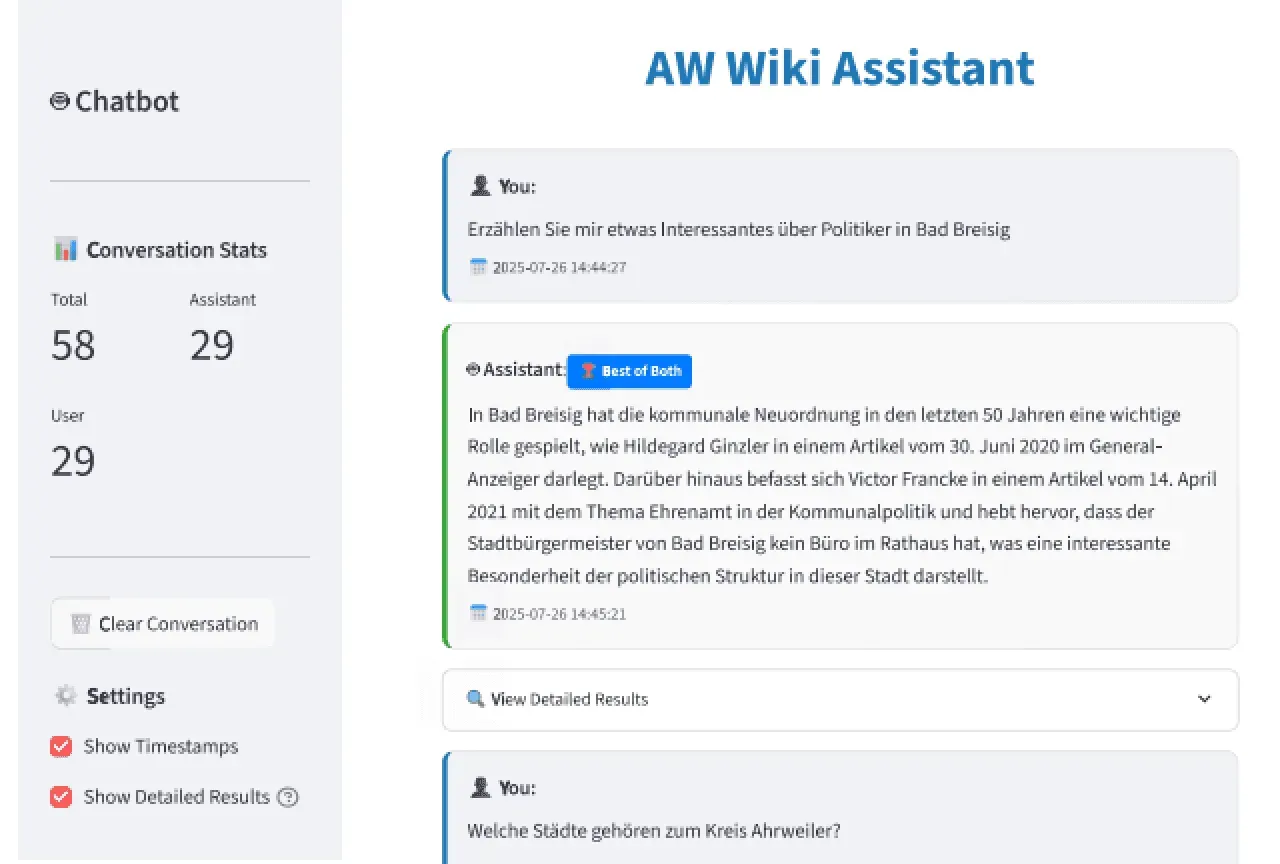
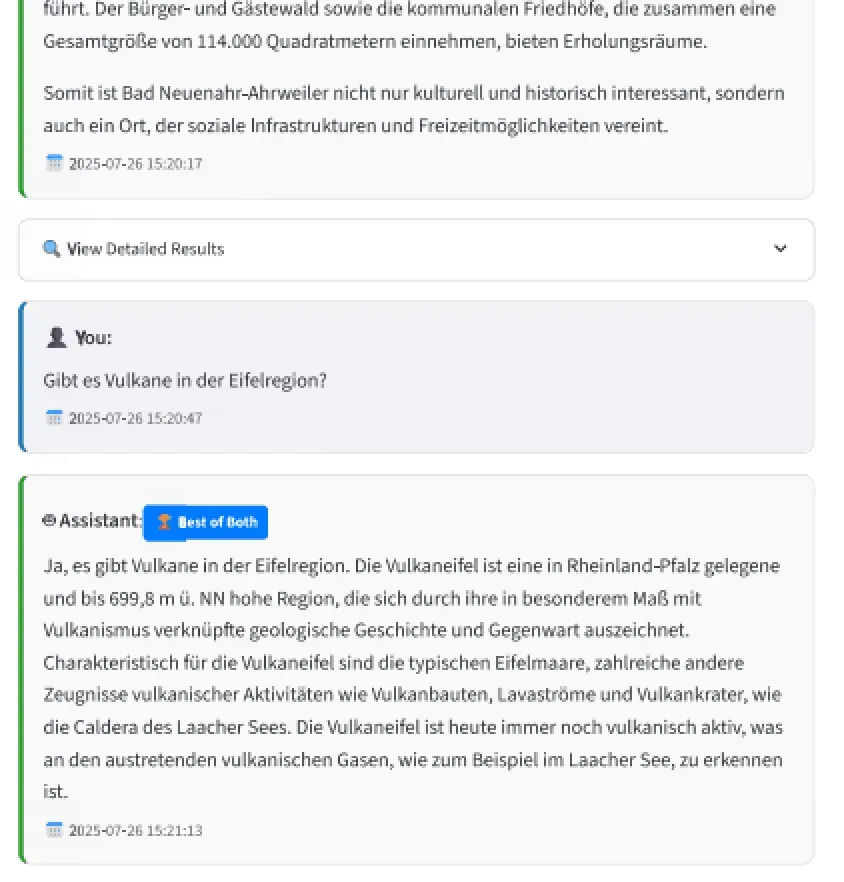
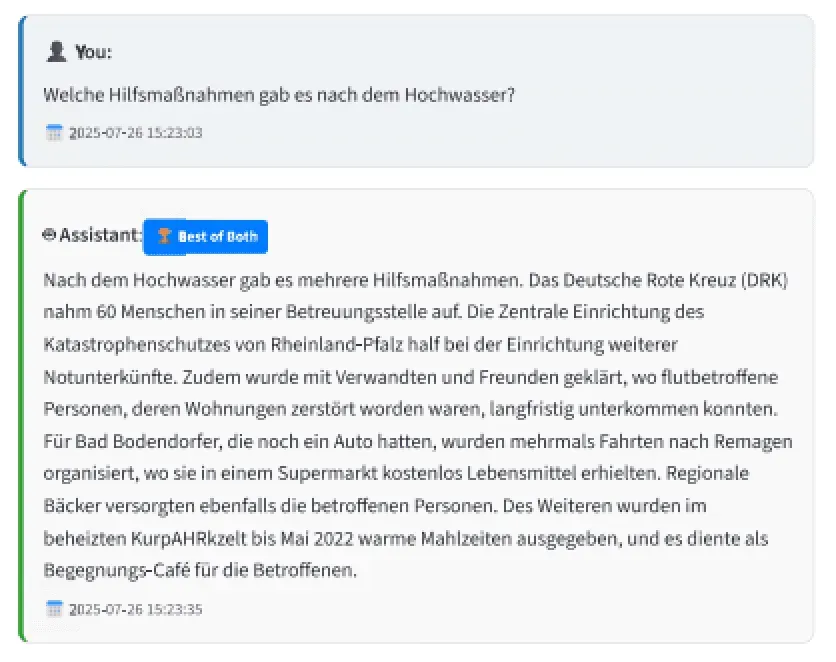
De afbeeldingen onder deze sectie stammen uit de eerste versie van 2025 - het oorspronkelijke chatbotontwerp waarmee het idee begon. Zij blijven staan omdat zij tonen waar het project vandaan komt.
Veelgestelde vragen
RegioWizard is een werkend prototype dat vragen over de regionale wiki van het district Ahrweiler in gewone taal beantwoordt. Elke uitspraak heeft een klikbare voetnoot naar de bron. Daarbij komen een kaart met gelokaliseerde items, een redactietafel om persteksten te vergelijken en een zichtbaar zoekprotocol.
RegioWizard draait volledig lokaal: corpus, index en vectoren staan als bestanden in de projectmap. Er is geen database, geen externe dienst, geen tracking en er zijn geen cookies. Het enige externe verzoek in de browser betreft de kaarttegels.
RegioWizard is gebaseerd op Next.js, BM25-trefwoordzoeken, vectorzoeken met RAG en Leaflet voor de kaart. Het taalmodel formuleert alleen op basis van eerder gevonden tekstpassages en onderbouwt elke bewering met een voetnoot. Is er geen model geconfigureerd, dan toont het systeem de best passende zinnen uit de wiki letterlijk en met bronvermelding.
Het RegioWizard-prototype omvat 4.295 van de ongeveer 39.000 artikelen van de AW-Wiki, geselecteerd op relevantie voor typische vragen. Dat levert 20.543 opvraagbare tekstpassages, 68.992 indextermen en 1.040 gelokaliseerde items op. Het inlezen respecteert de rate limits van de wiki.

Meer ontdekken
HEEFT U EEN COMPLEX IDEE DAT U DOOR ONS WILT LATEN UITVOEREN?
START MET EEN DESIGN-THINKING PILOT OF EEN ADVIESGESPREK.