

PROJETIA
RegioWizard
Un prototype fonctionnel qui interroge le wiki régional de l'arrondissement d'Ahrweiler en langage courant : une note de bas de page sur chaque affirmation, une carte, un bureau de rédaction et un journal de recherche visible.
4.295
articles dans l'index local
20.543
passages consultables
1.040
entrées géolocalisées
Le savoir est déjà là, mais personne ne peut l'interroger
 GÉNÉRÉ PAR IA
Le AW-Wiki, sur aw-wiki.de, rassemble depuis des années ce que l'on sait de l'arrondissement d'Ahrweiler : associations, bâtiments, terroirs viticoles, sentiers, conseils municipaux, entreprises, événements, personnes. Environ 39 000 articles dans l'espace principal, écrits et entretenus par des habitants de la région.
Encore faut-il savoir ce que l'on cherche. Un champ de recherche ne répond pas à « quelles associations de Dernau ont été touchées par la crue ? ». Il trouve des pages contenant le mot Dernau. L'humain fait le reste.
C'est précisément la lacune : le corpus existe, les questions existent, et il manque entre les deux un système qui les relie sans rien inventer. RegioWizard est notre réponse : un prototype qui tourne, pas une note de cadrage.
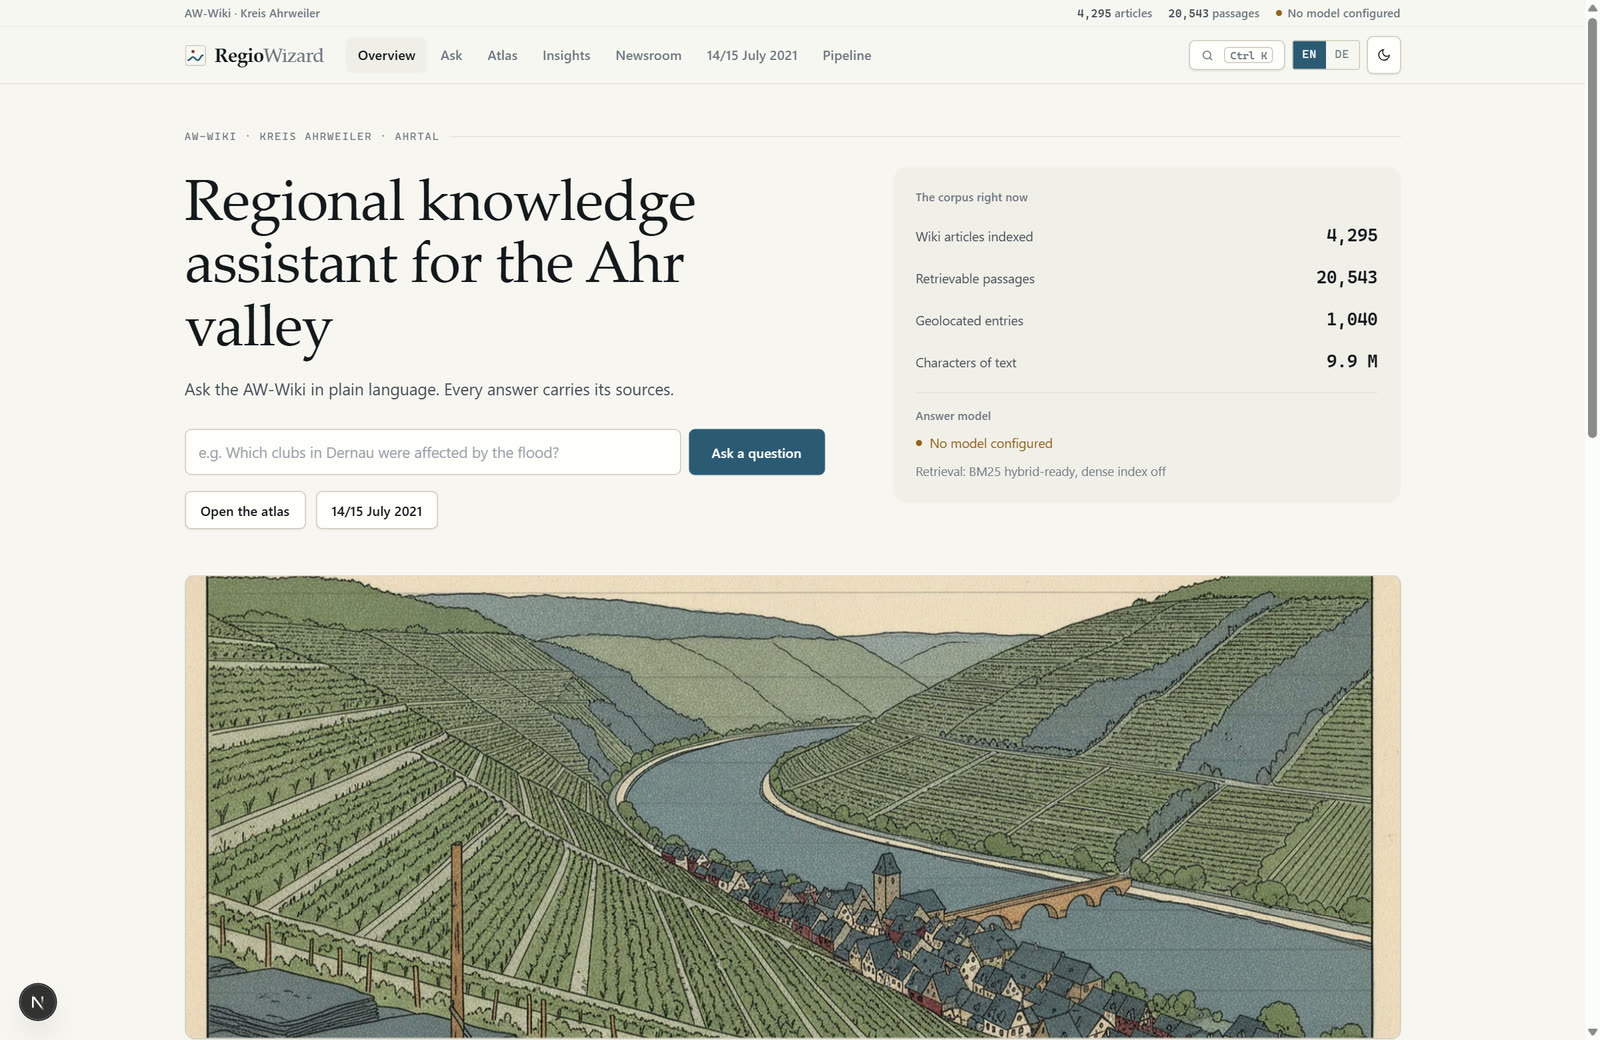
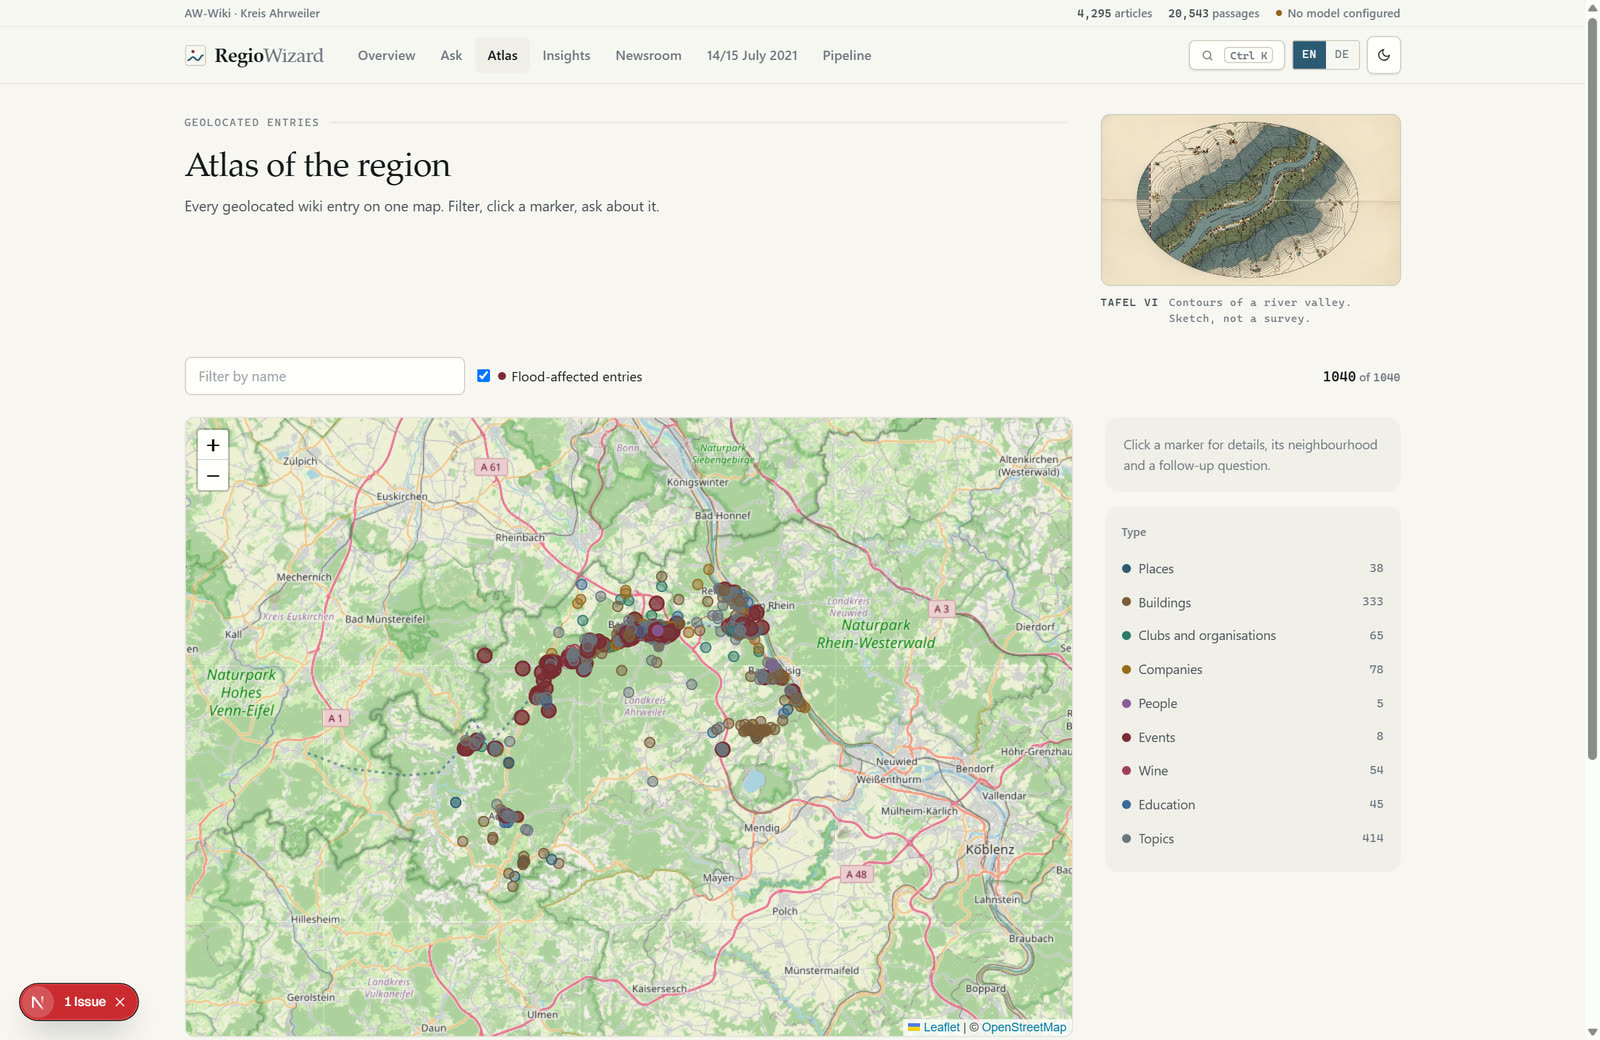
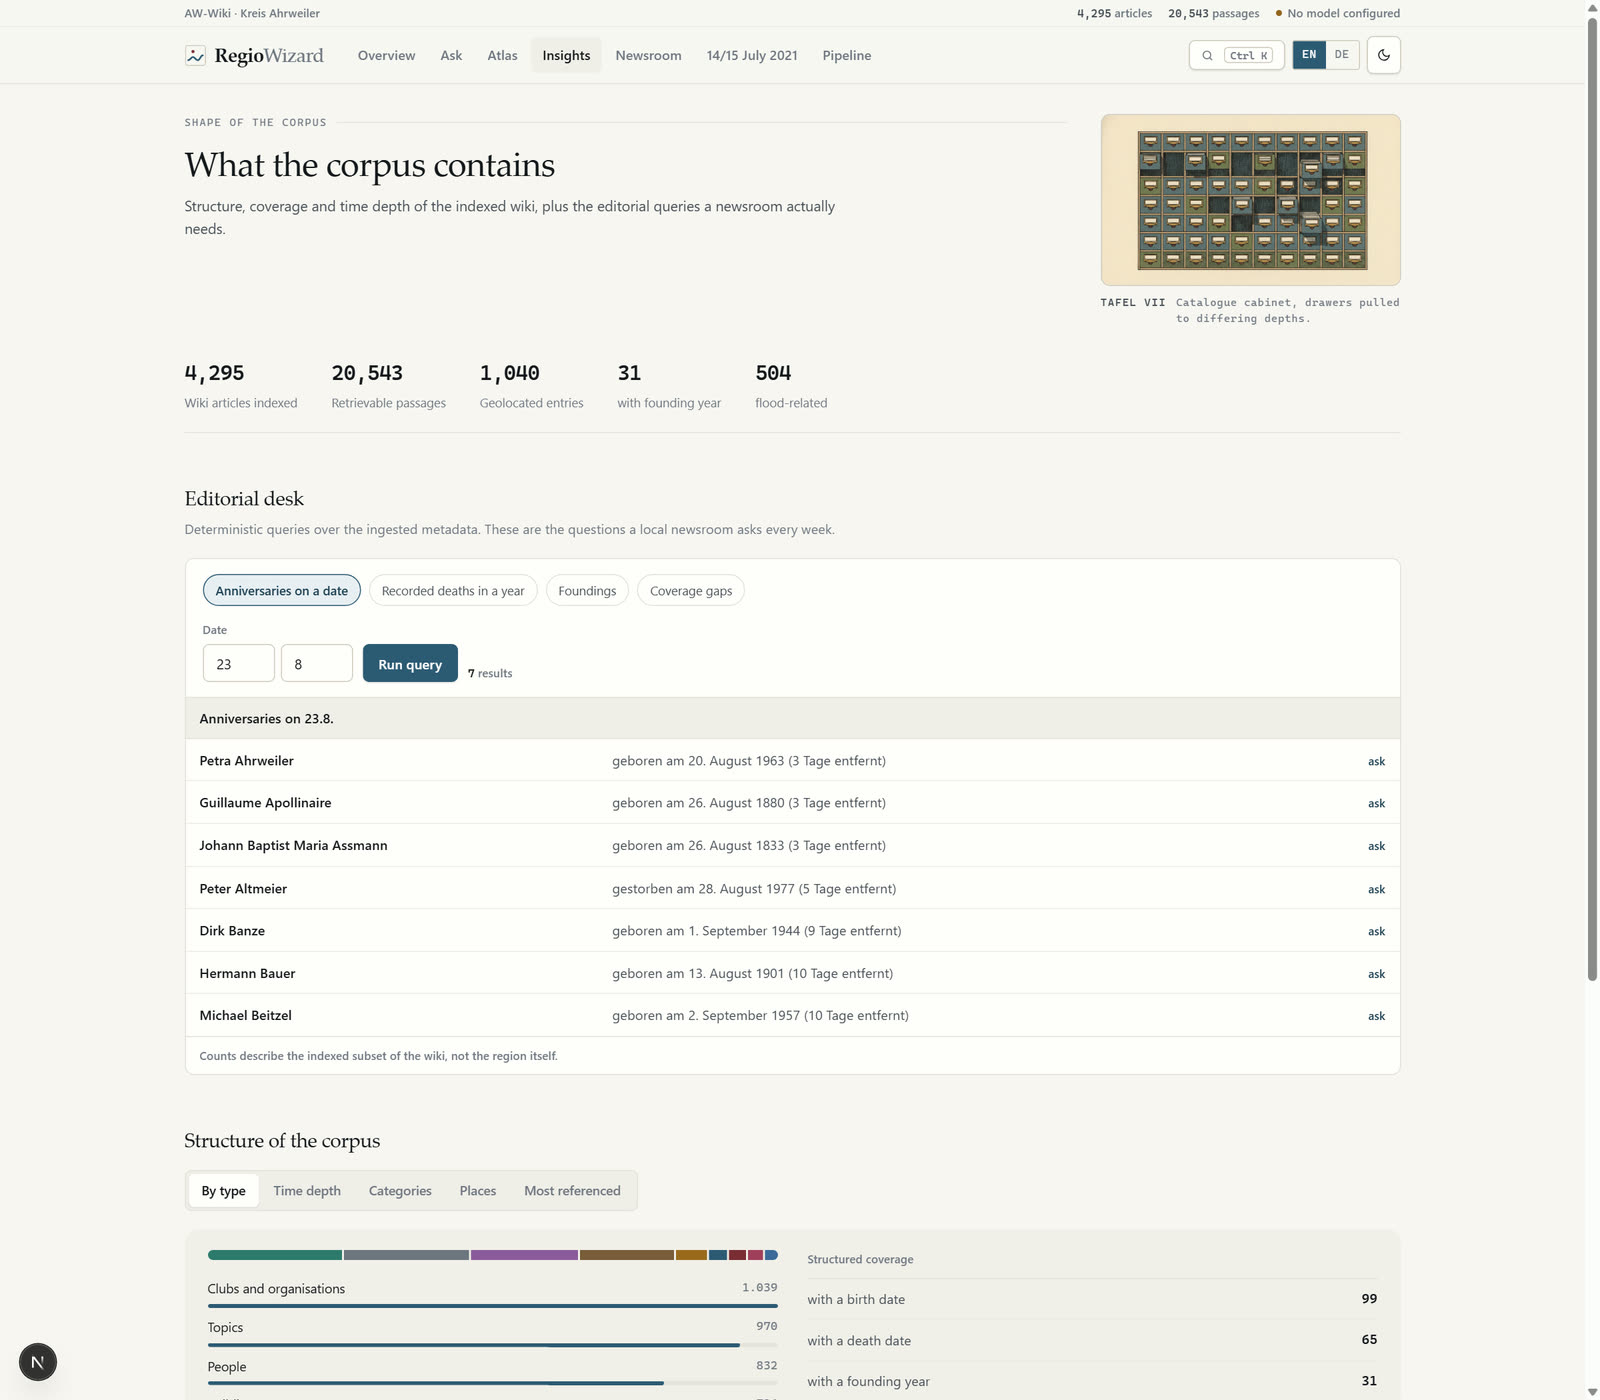
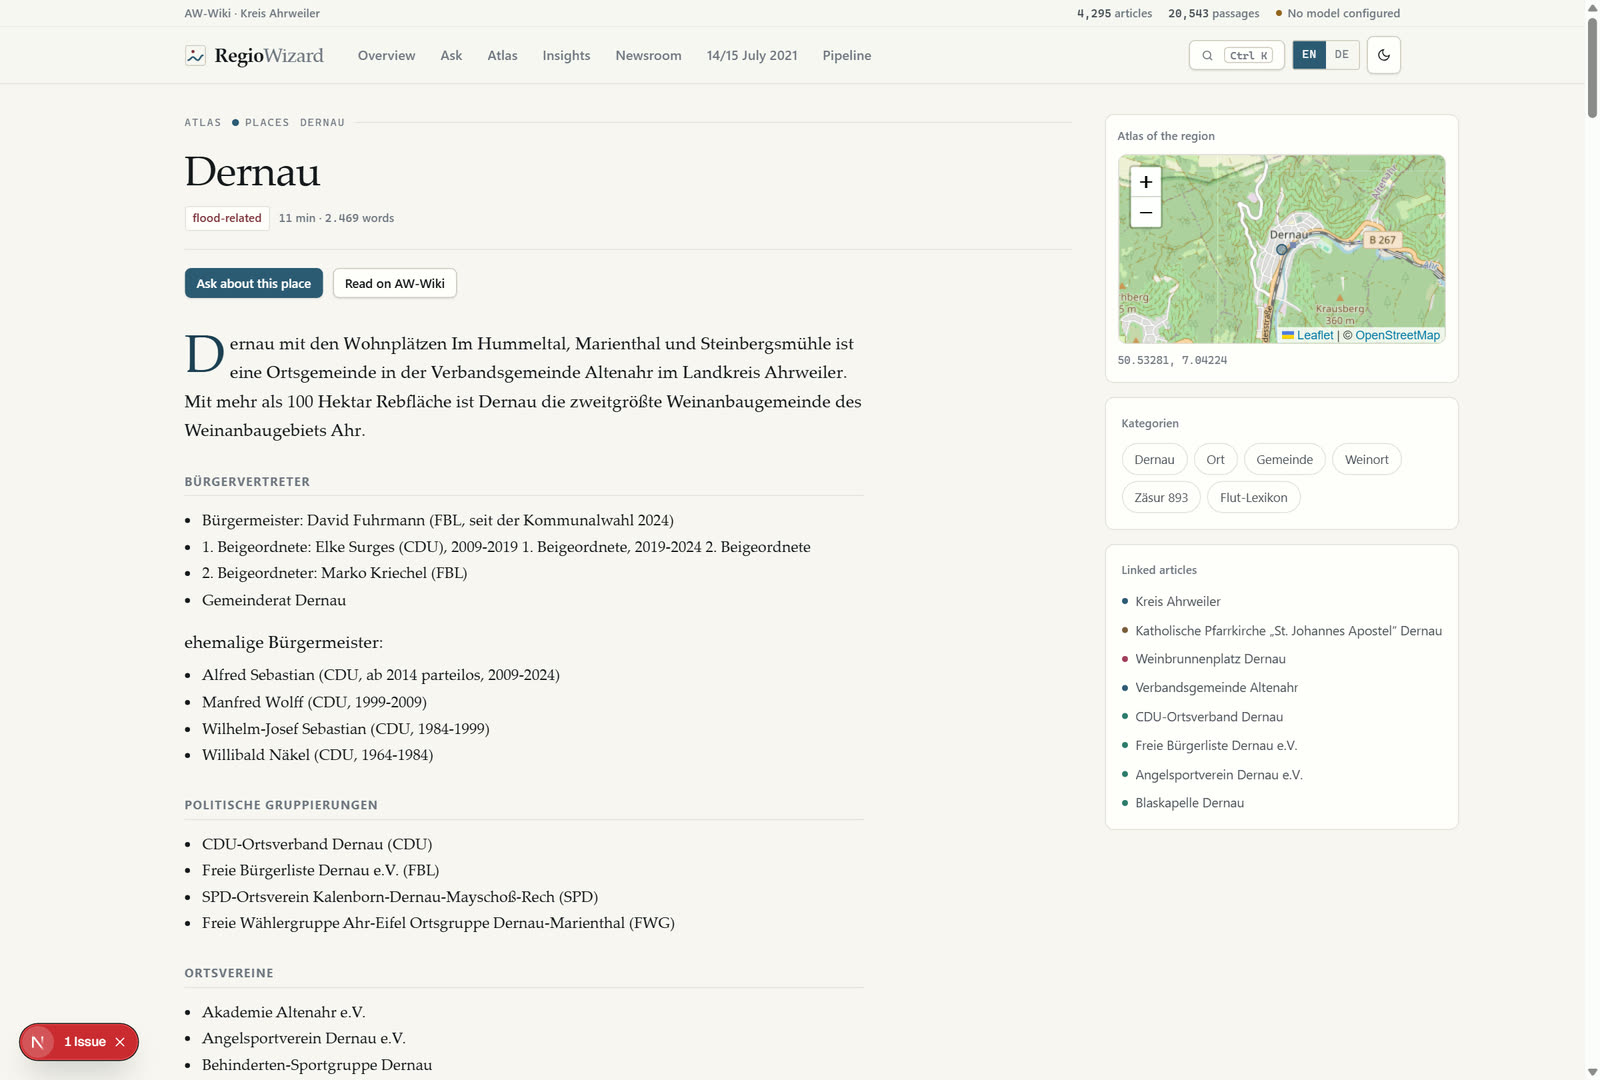
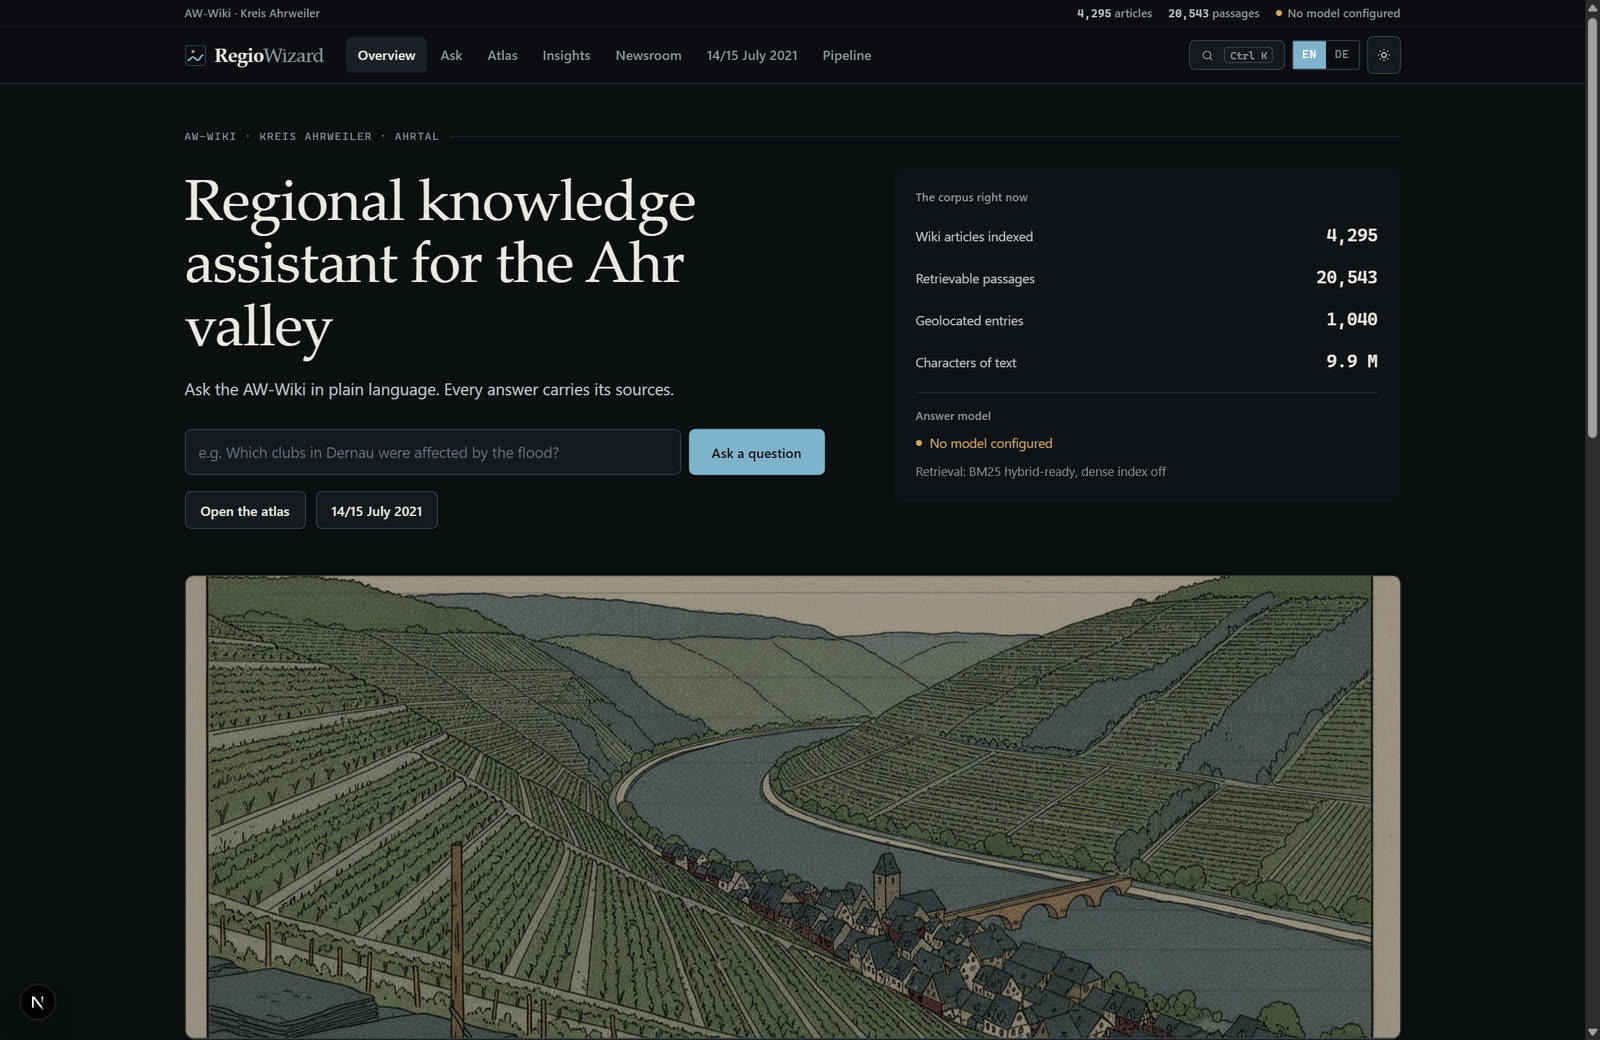
Sept vues sur un seul corpus
Tout le prototype lit le même index local. Il n'existe pas de seconde source de données qui pourrait diverger.
- Interroger - des réponses sourcées en phrases complètes, avec filtres et journal de recherche.
- Atlas - chaque entrée géolocalisée sur une carte, couche « crue » activable, voisinage dans un rayon de 3 km.
- Analyse - structure et profondeur temporelle du corpus, plus le bureau de rédaction.
- Rédaction - la comparaison d'un texte de presse récent avec le wiki.
- 14/15 juillet 2021 - la documentation de la nuit de la crue, volontairement sobre.
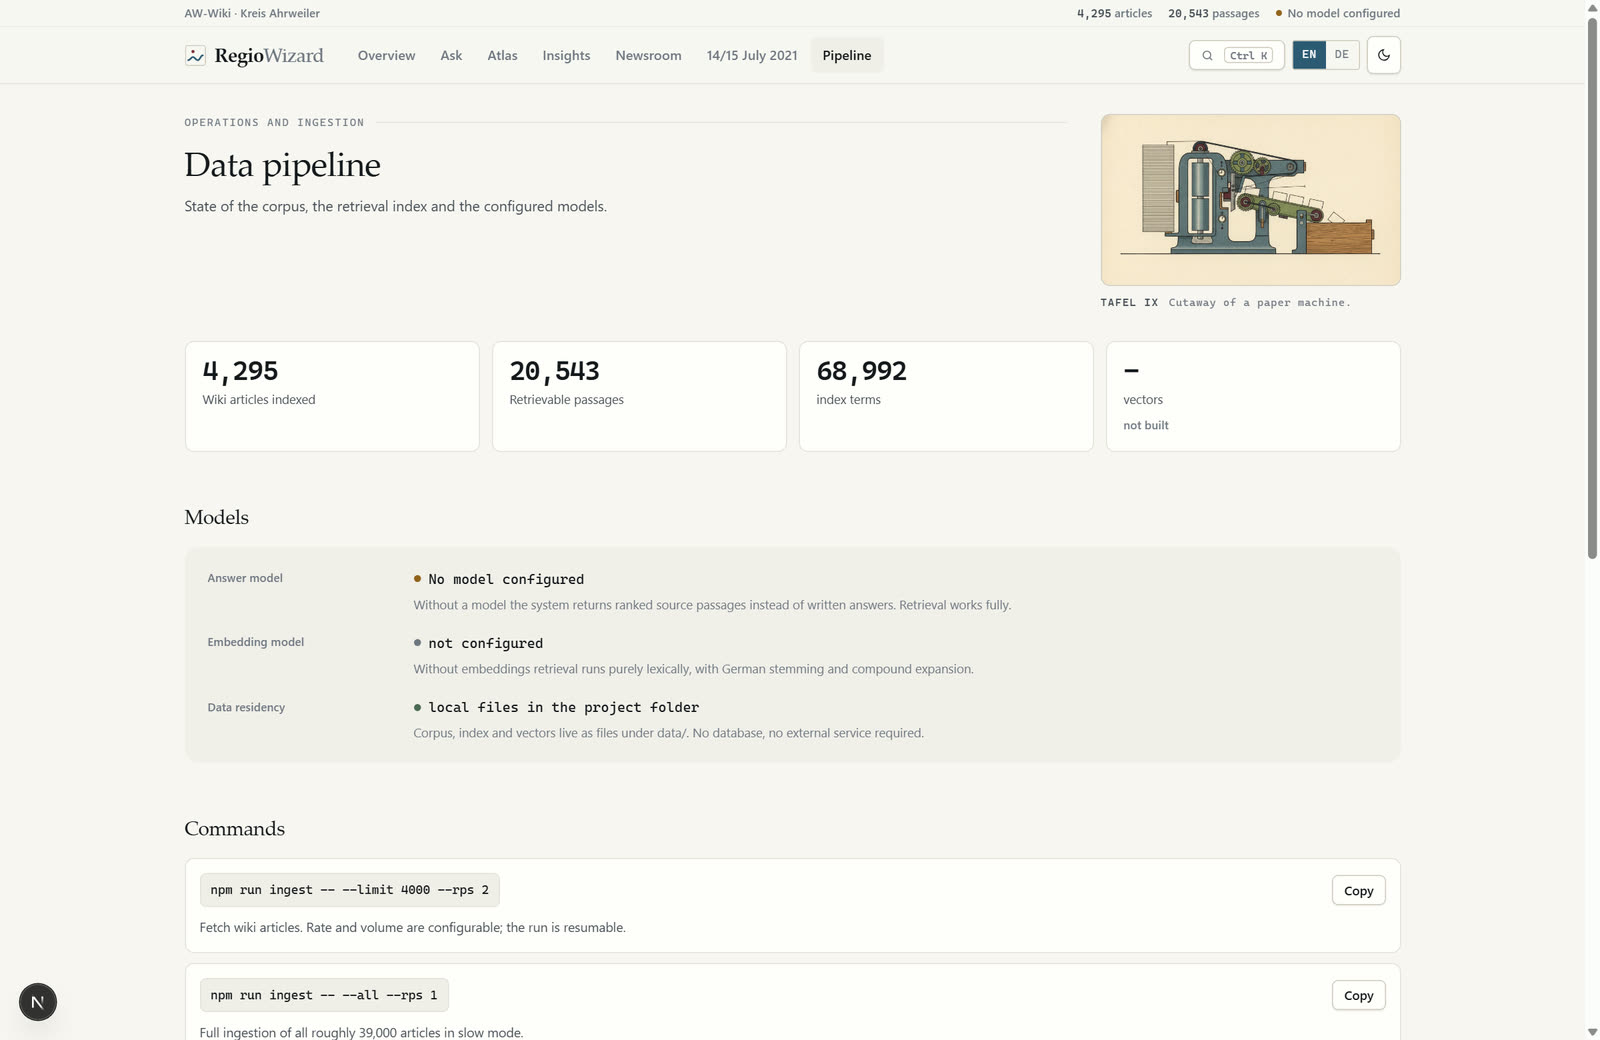
- Pipeline - l'état de la collecte, de l'index et des modèles, à découvert.
- Vue article - chaque article en version lecture, avec renvoi à l'original du wiki.
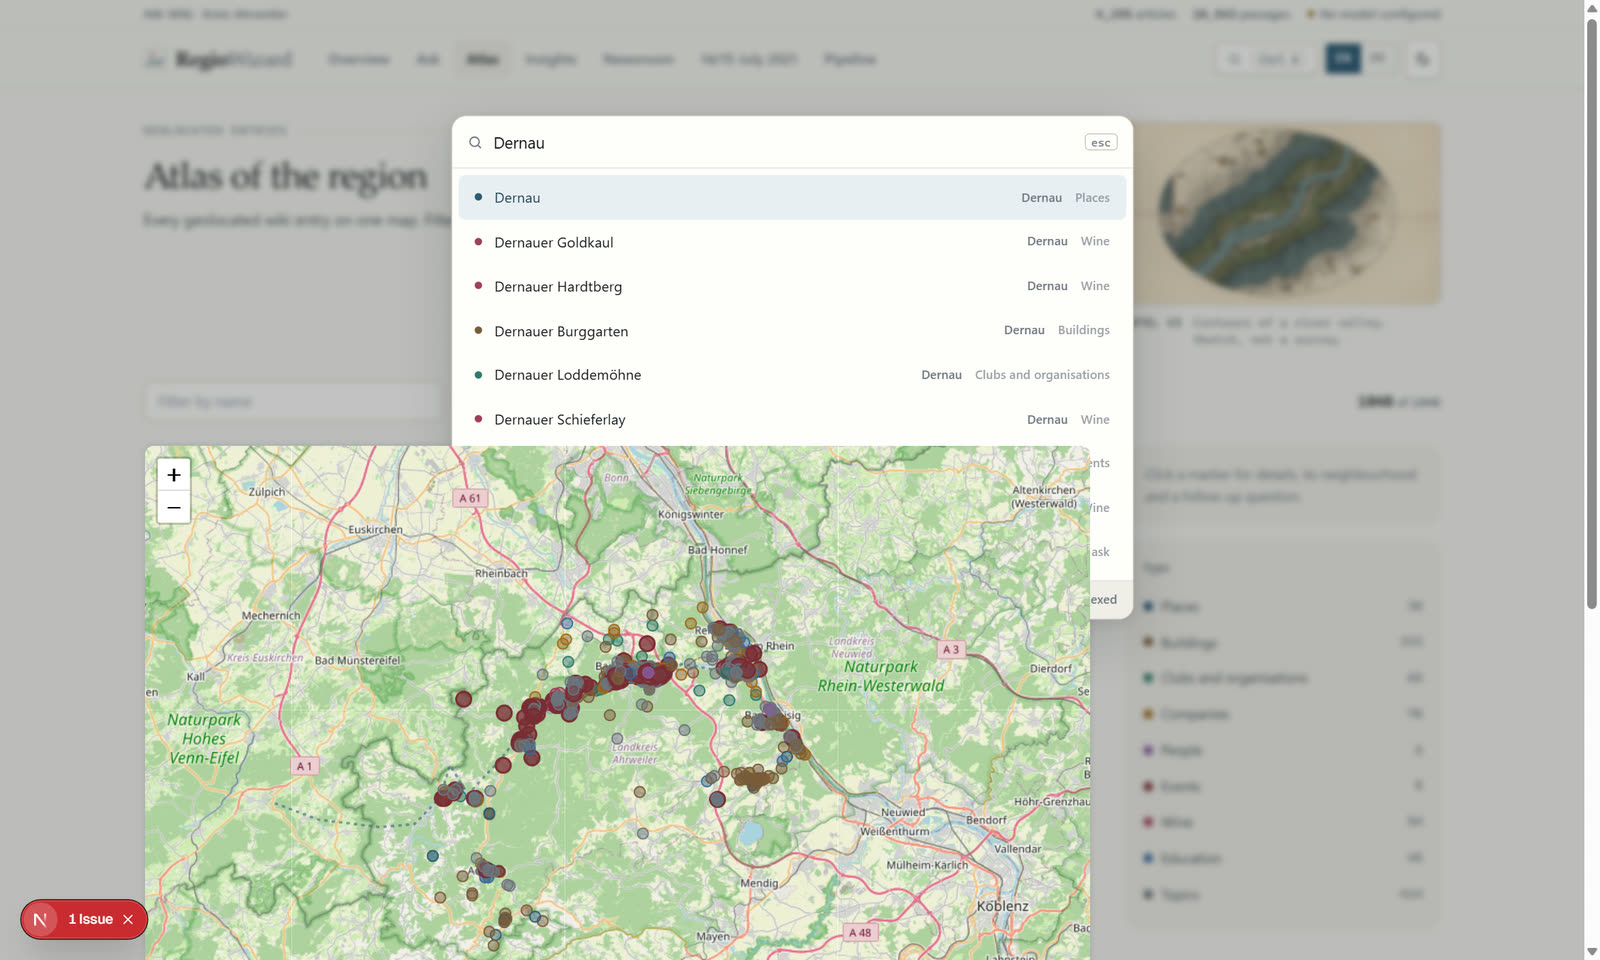
S'y ajoute une palette de commandes sur Ctrl + K qui tient les 4 295 titres : on tape, on saute. Sans correspondance, la saisie est transmise comme question.
Chaque affirmation nomme sa source, sinon il n'y a pas d'affirmation
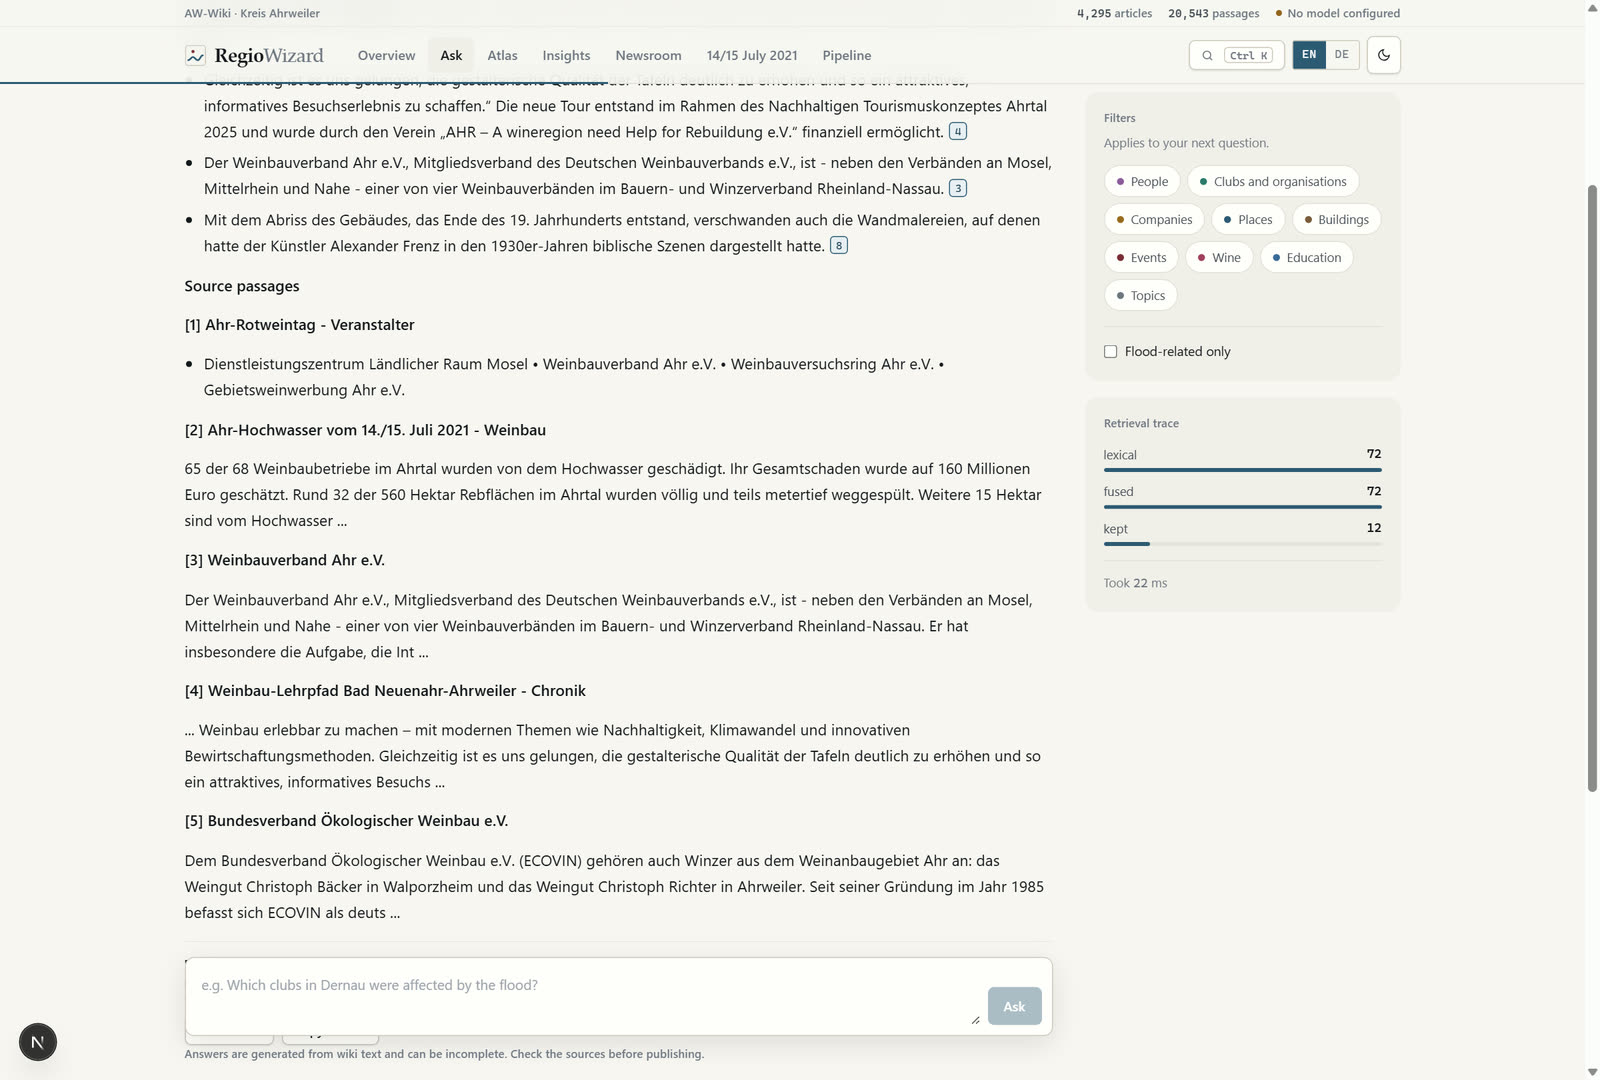
C'est la règle à laquelle tout le reste est suspendu. Le modèle de langage ne rédige qu'à partir des passages trouvés au préalable et marque chaque assertion d'une note. La note est cliquable et ouvre le passage dont elle provient : titre, section, formulation.
Le plus important est le cas sans modèle. Si aucun n'est configuré, le système n'invente rien et ne signale pas non plus d'erreur : il affiche les phrases du wiki qui correspondent le mieux, mot pour mot et sourcées, suivies des passages trouvés en texte intégral. Ce mode extractif est une voie à part entière, pas un état de panne.
La raison est pratique. Une rédaction qui reprend une donnée en répond. Un outil qui se contente d'affirmer une source au lieu de la montrer n'a alors aucune valeur.
Une date est une opération ensembliste, pas une recherche de similarité
« Qui, dans la région, fête son anniversaire aujourd'hui ? » ressemble à une question pour une IA. C'est une requête de base de données, et la recherche vectorielle y répond très mal : elle trouve des textes qui parlent d'anniversaires, pas des personnes dont c'est l'anniversaire.
Le prototype reconnaît donc ces questions et les redirige vers des requêtes fixes sur les champs structurés : dates de naissance et de décès, années de fondation, coordonnées, catégories. Sont traitées ainsi : les anniversaires à une date, les décès recensés d'une année, les fondations, la proximité et - le cas qui intéresse le plus les rédactions - les lacunes thématiques : des articles souvent cités mais eux-mêmes minces, voire absents.
Le résultat est un tableau nom, date, source. Pas une prose qui devine des chiffres.
 GÉNÉRÉ PAR IA
La traçabilité est une fonction, pas un mode de débogage
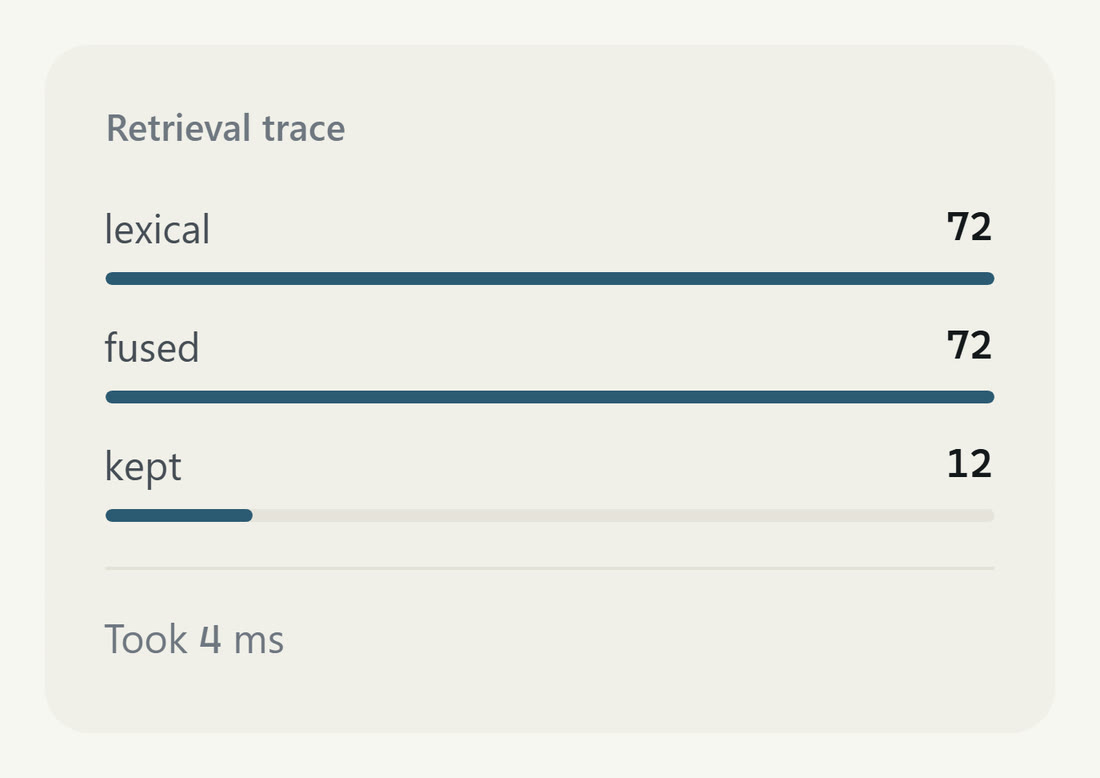
Sous chaque réponse figure la manière dont elle a été obtenue : combien de candidats la recherche par mots-clés a fournis, combien la recherche vectorielle, combien ont survécu à la fusion, combien sont réellement entrés dans la réponse, et le temps que cela a pris. Dans l'exécution montrée : 72 lexicaux, 72 fusionnés, 12 retenus, 120 millisecondes.
La recherche elle-même est conçue pour l'allemand. Les trémas sont normalisés, les radicaux réduits, les mots composés décomposés - Weinbau trouve aussi Weinbaubetrieb. Chaque passage porte un en-tête fixe : titre, section, type, lieu et catégories, afin de rester compréhensible une fois extrait de son article.
Nous ne montrons pas cela par goût de la technique. Quiconque réutilise une information doit pouvoir voir sur quelle base, mince ou large, elle repose.
La comparaison : ce que le journal local publie et qui manque au wiki
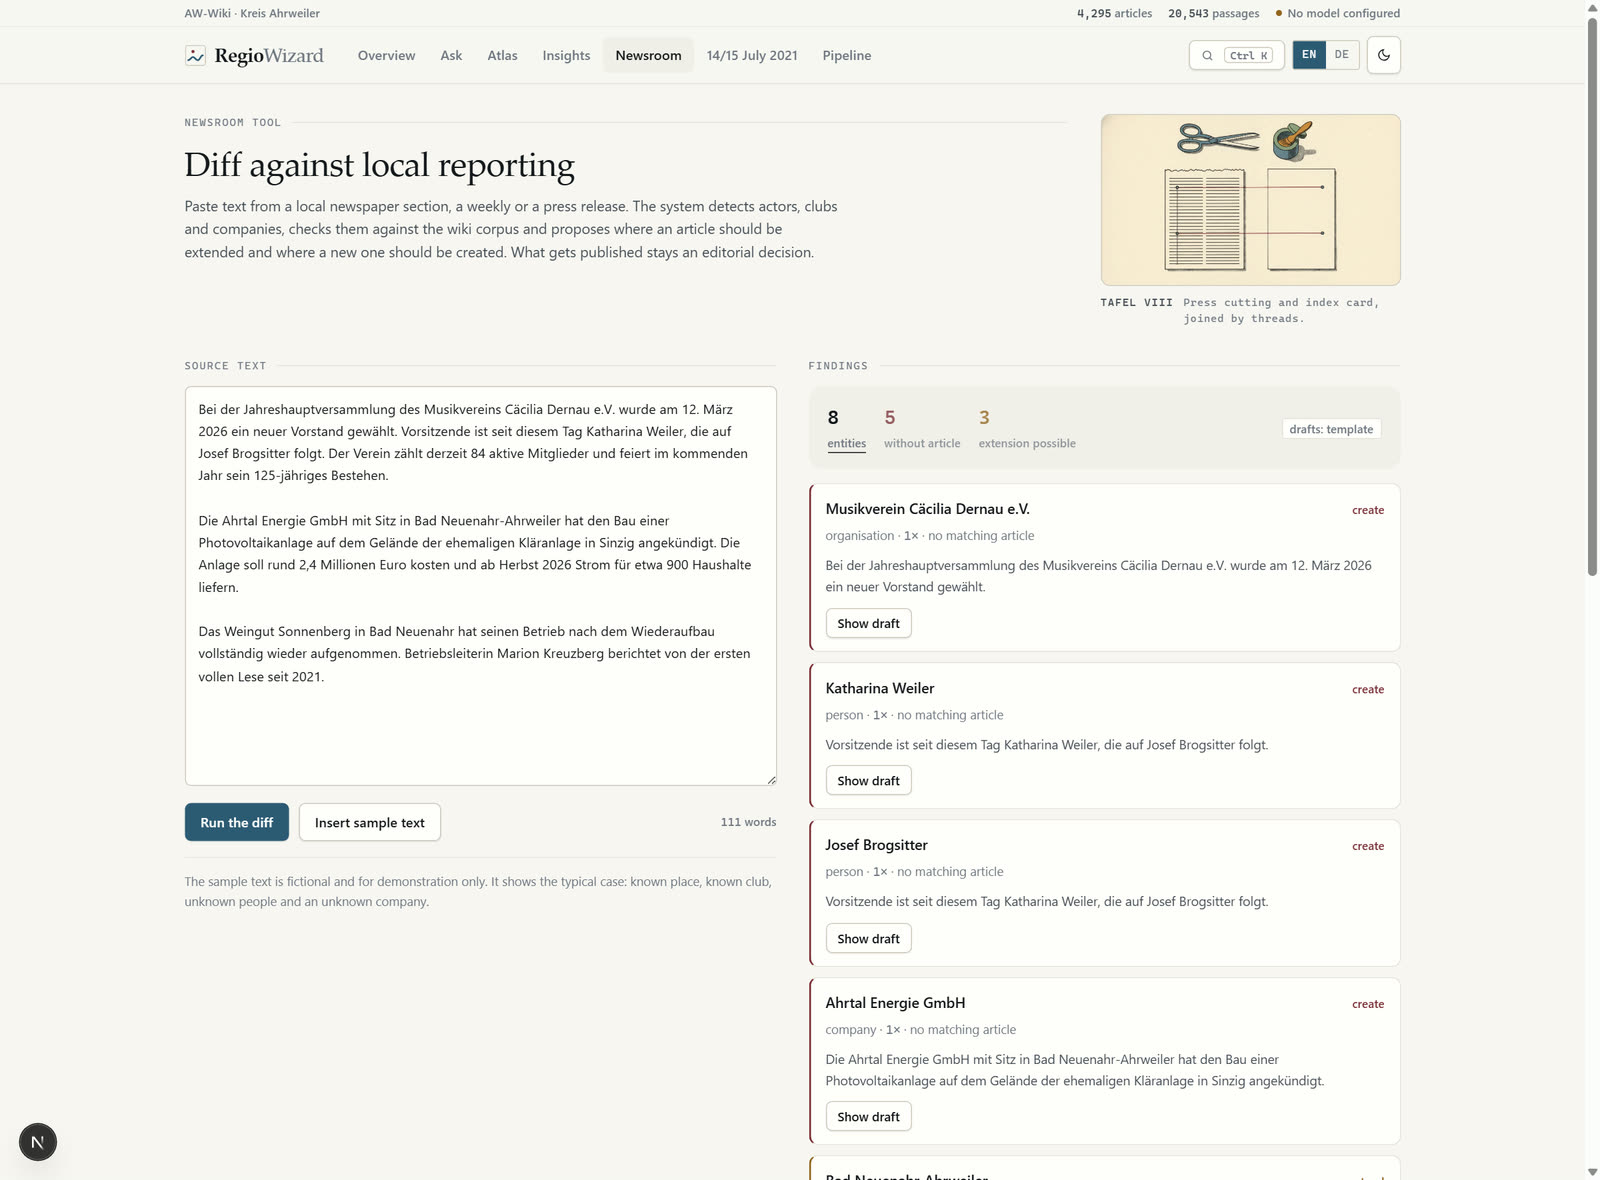
Un wiki régional vieillit exactement là où le présent se produit : dans les pages locales, l'hebdomadaire gratuit, le communiqué de l'association. La rédaction voit ces informations de toute façon chaque jour. Les reporter dans le wiki coûte un temps dont personne ne dispose.
Le bureau de rédaction prend un texte et le confronte au corpus. Personnes, associations, entreprises et lieux sont détectés ; chaque occurrence est vérifiée contre les articles existants et reçoit l'un de trois états : déjà couvert, article existant, information absente, aucun article. Dans l'exemple montré : 8 entités, 5 sans article, 3 avec complément possible.
Chaque proposition s'accompagne d'un brouillon au format wiki, prêt à être copié. L'essentiel est ce que le système ne fait pas : il n'écrit rien dans le wiki. Le choix reste à la rédaction - non par limitation technique, mais parce que c'est la répartition des rôles que nous jugeons juste.
La page sur la crue documente, elle ne met pas en scène
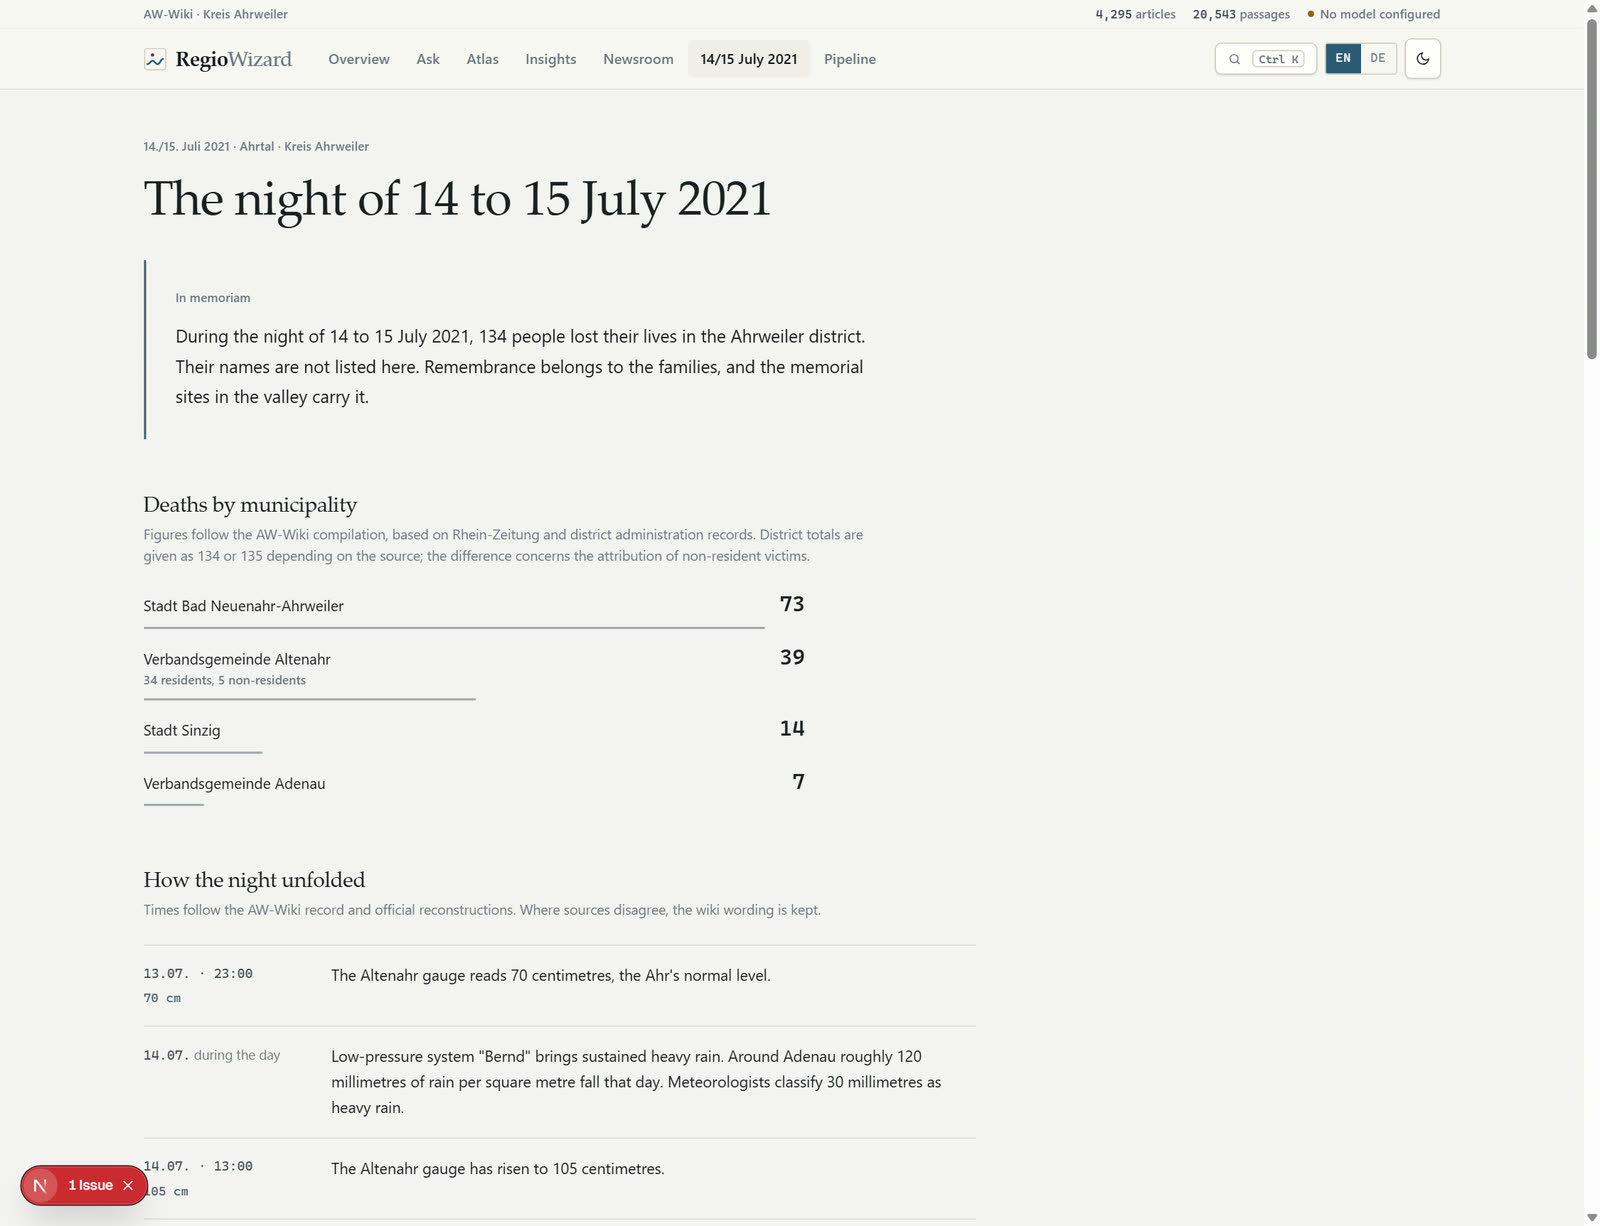
Le corpus contient de nombreux articles liés à la crue des 14 et 15 juillet 2021. Une page dédiée était inévitable ; la question était de savoir à quoi elle pouvait ressembler.
Nous l'avons soumise à des contraintes fermes, et ces contraintes font partie du produit, ce n'est pas une question de style : un avertissement avant le contenu, aucun nom de victime, aucune image, aucune animation, aucun chiffre qui s'incrémente, aucun mécanisme d'engagement, une palette assourdie distincte du reste de l'application.
Les données de cette page vont avec leur source. Là où les sources diffèrent, la différence est nommée plutôt que lissée.
Où en est le prototype - et ce qui l'a précédé en 2025
Soyons précis sur le périmètre : 4 295 des quelque 39 000 articles sont collectés, choisis selon leur pertinence pour les questions typiques. Ils produisent 20 543 passages, 68 992 termes d'index et 1 040 entrées géolocalisées. La collecte respecte la limitation de débit du wiki ; pour l'intégralité, un export de base de données serait la bonne voie, pas 39 000 requêtes unitaires.
L'application fonctionne entièrement en local : corpus, index et vecteurs sont des fichiers dans le dossier du projet. Pas de base de données, pas de service externe, pas de traçage, pas de cookies - la seule requête tierce dans le navigateur concerne les tuiles cartographiques.
Toutes les illustrations du prototype sont des dessins, produits avec un modèle d'image et signalés comme tels. Aucune ne représente un lieu, un bâtiment ou une personne réels. C'est délibéré : une application dont toute la promesse est la traçabilité des faits ne doit pas livrer une image que l'on pourrait prendre pour une photographie.
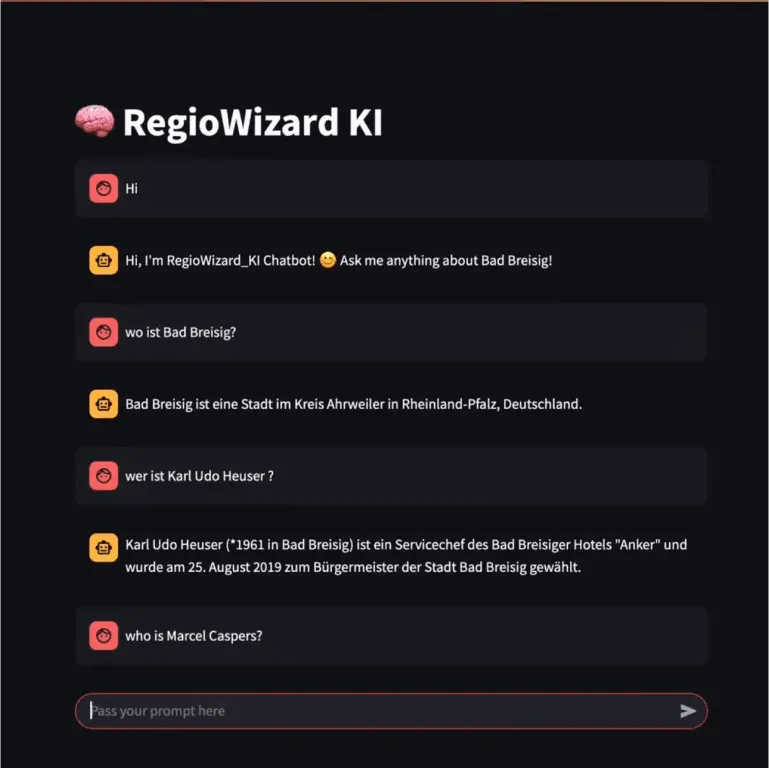
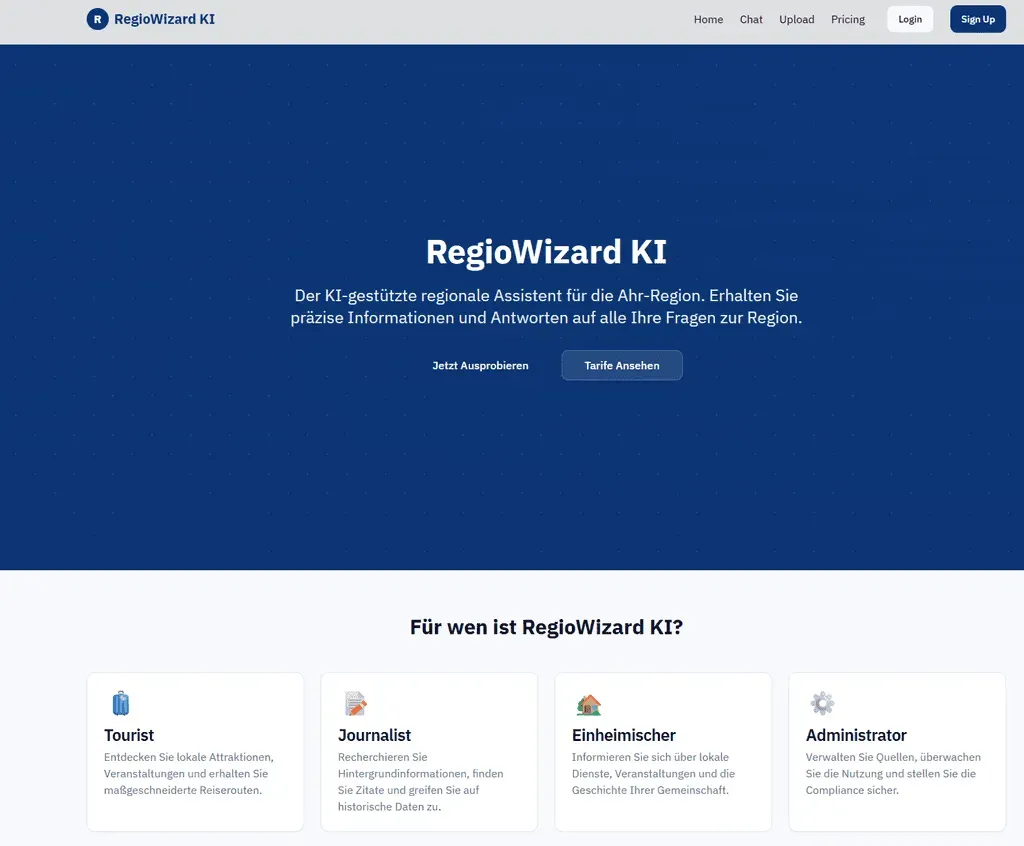
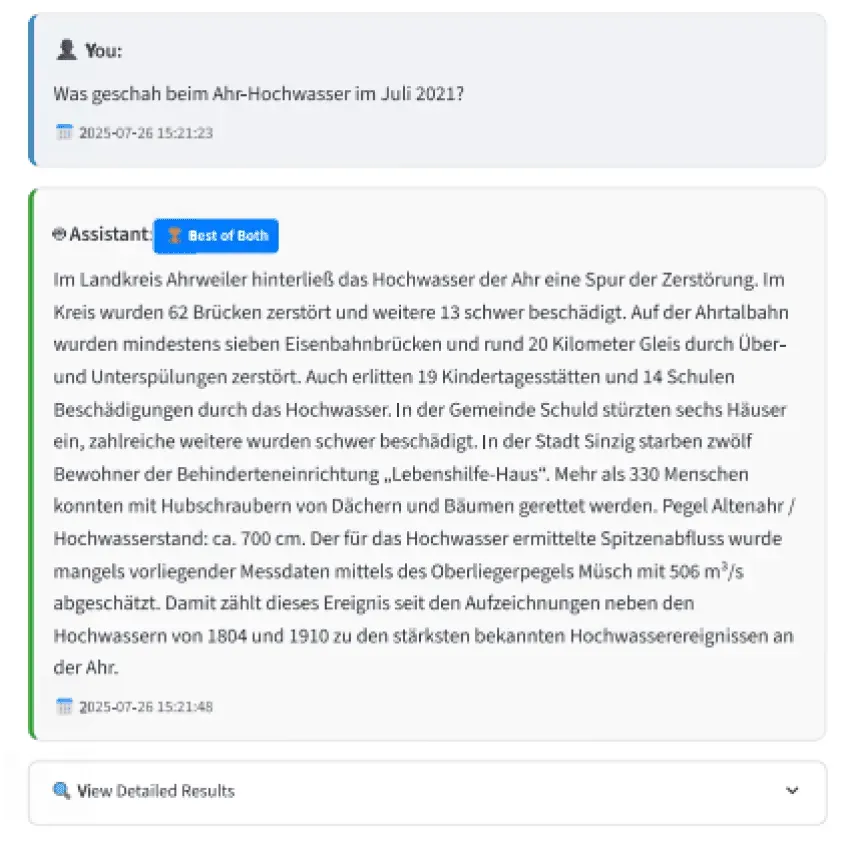
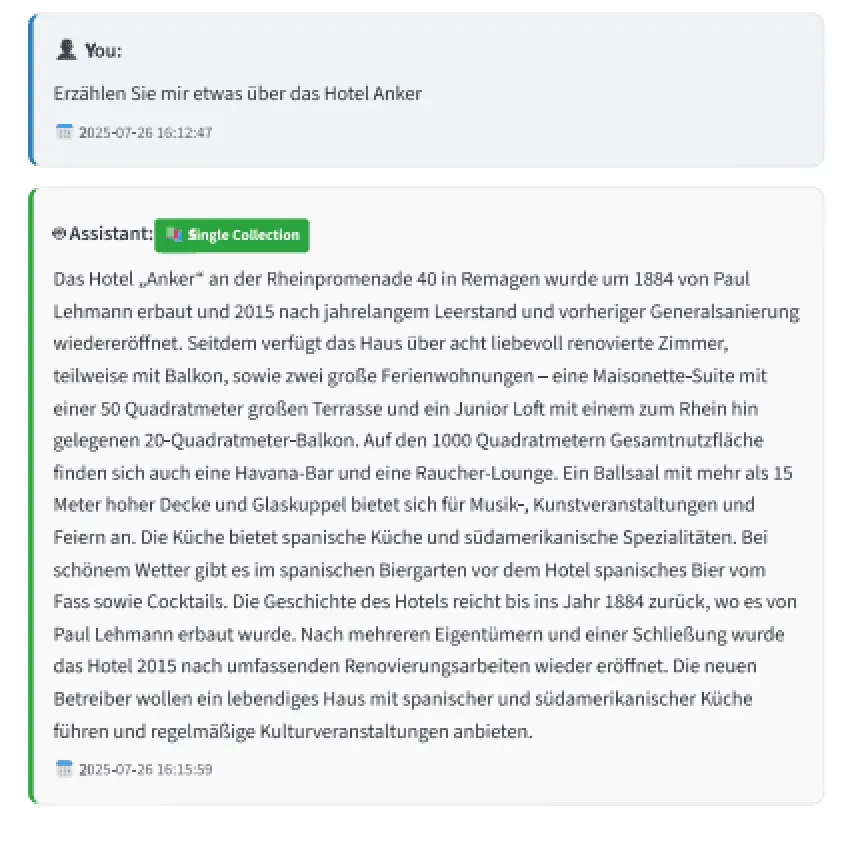
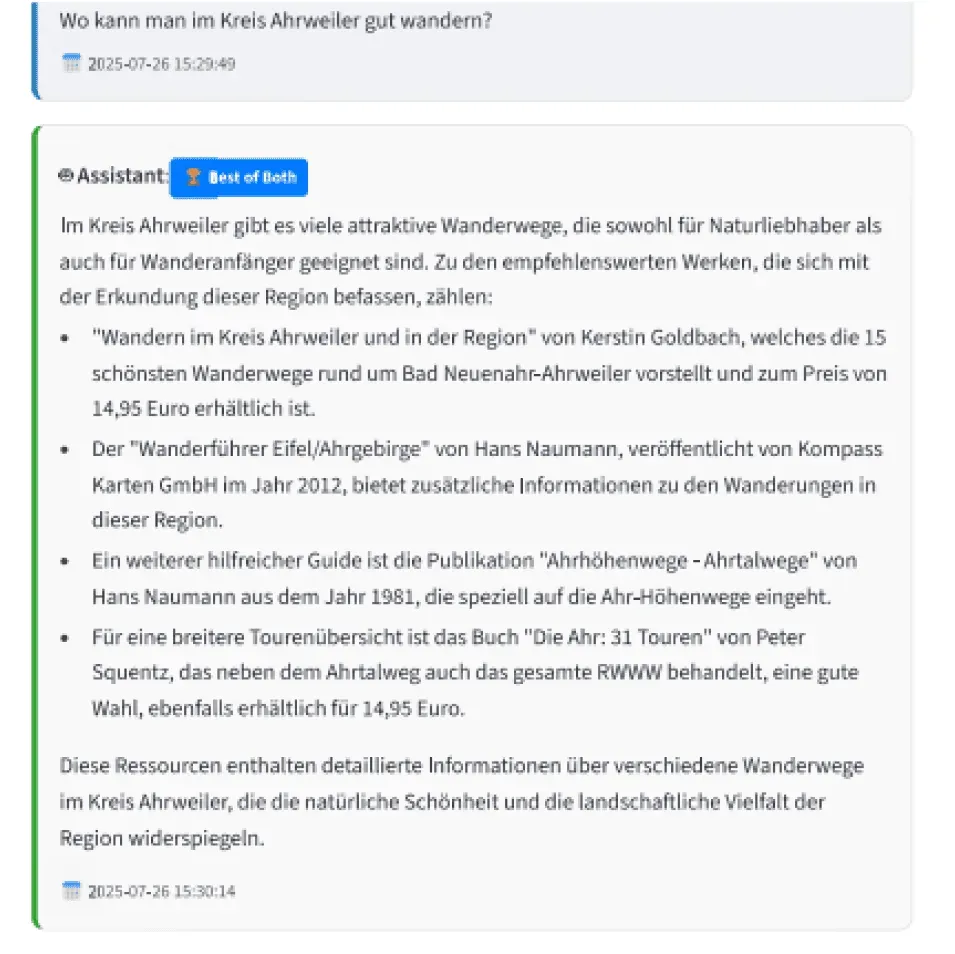
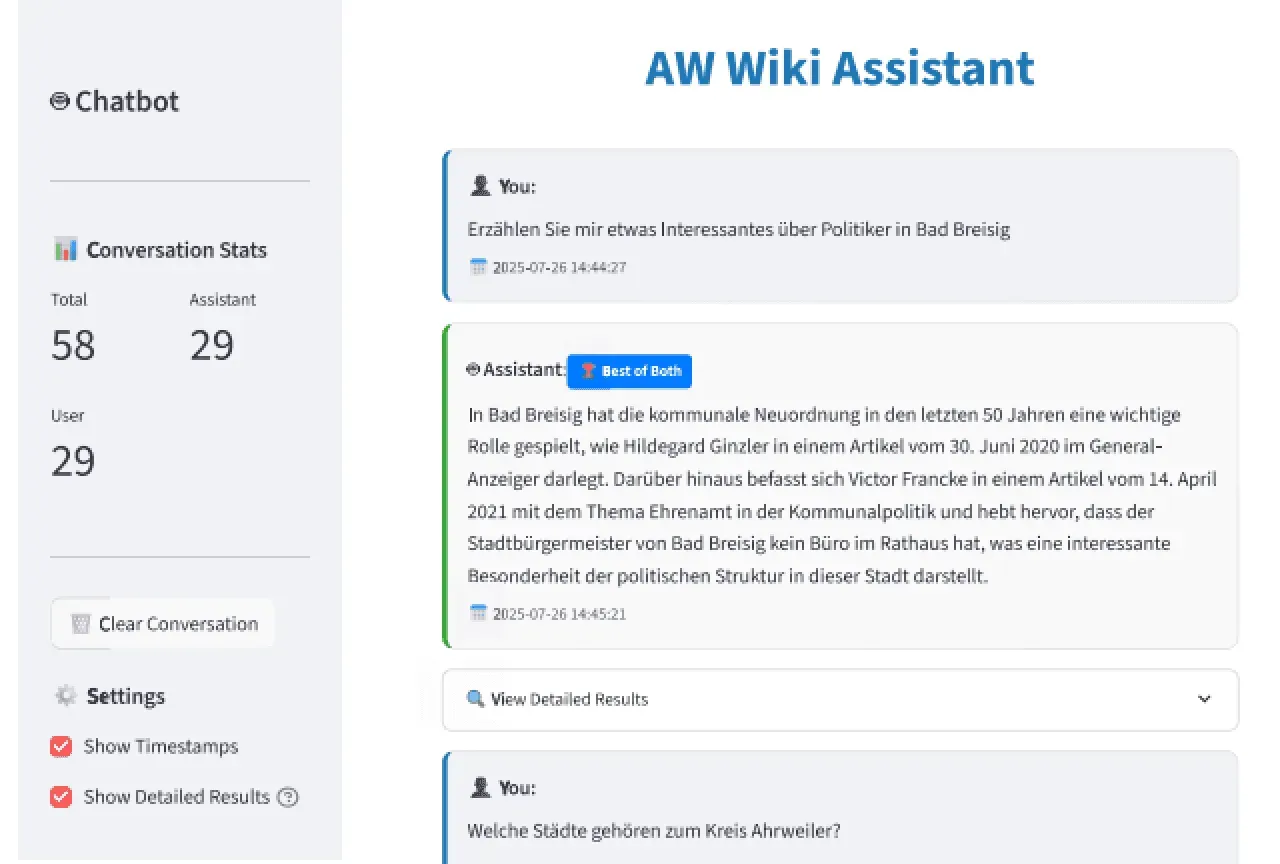
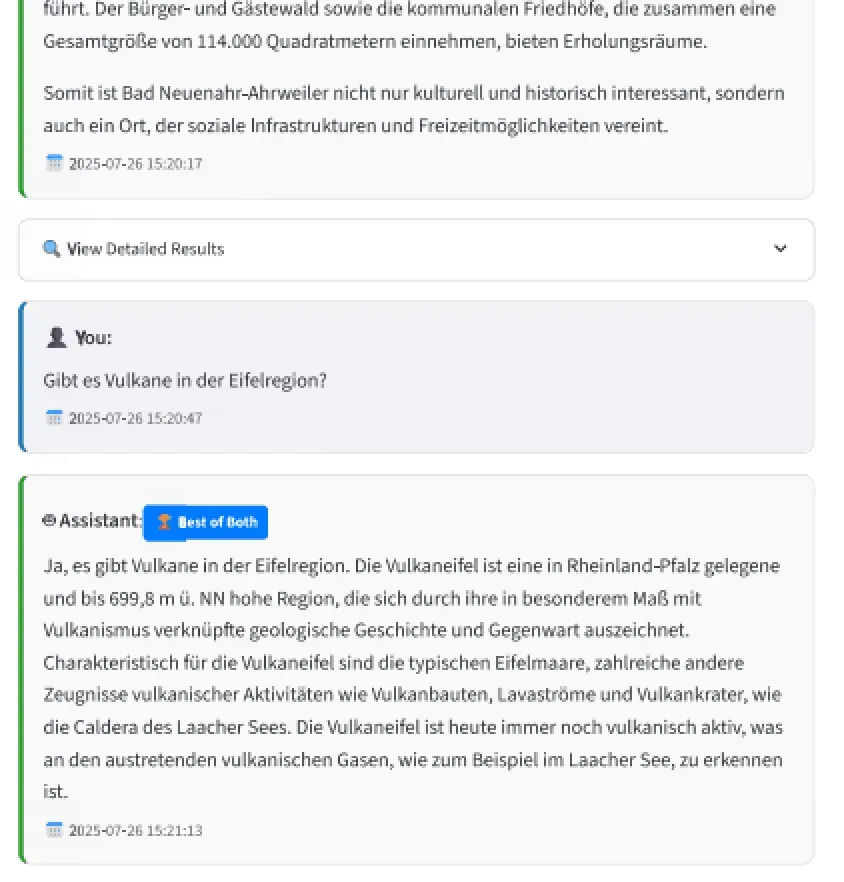
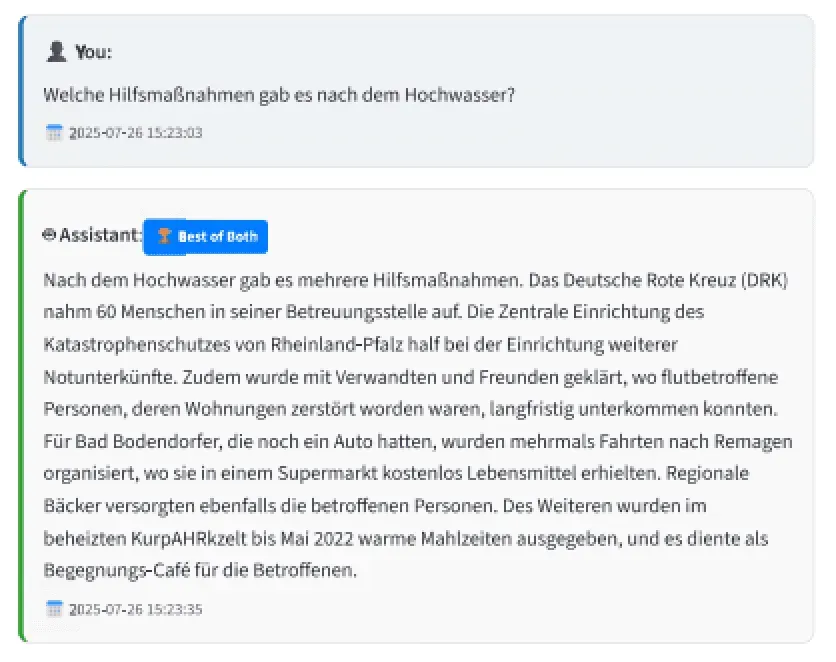
Les images situées sous cette section proviennent de la première version de 2025 - l'ébauche de chatbot par laquelle l'idée a commencé. Elles restent parce qu'elles montrent d'où vient le projet.
Questions fréquentes
RegioWizard est un prototype fonctionnel qui répond en langage courant aux questions portant sur le wiki régional de l'arrondissement d'Ahrweiler. Chaque affirmation porte une note de bas de page cliquable renvoyant à sa source. S'y ajoutent une carte des entrées géolocalisées, un poste de rédaction pour confronter des textes de presse au wiki et un journal de recherche visible.
RegioWizard fonctionne entièrement en local : le corpus, l'index et les vecteurs sont stockés sous forme de fichiers dans le dossier du projet. Il n'y a ni base de données, ni service externe, ni tracking, ni cookies. La seule requête tierce dans le navigateur concerne les tuiles de la carte.
RegioWizard repose sur Next.js, la recherche par mots-clés BM25, la recherche vectorielle avec RAG et Leaflet pour la carte. Le modèle de langage ne rédige qu'à partir de passages trouvés au préalable et étaye chaque affirmation par une note de bas de page. Si aucun modèle n'est configuré, le système affiche mot pour mot les phrases les plus pertinentes du wiki, avec leur source.
Le prototype RegioWizard couvre 4 295 des quelque 39 000 articles de l'AW-Wiki, sélectionnés selon leur pertinence pour des questions courantes. Ils donnent 20 543 passages exploitables, 68 992 termes d'index et 1 040 entrées géolocalisées. La collecte respecte la limitation de débit du wiki.

En savoir plus
VOUS AVEZ UNE IDÉE COMPLEXE QUE VOUS SOUHAITEZ NOUS CONFIER ?
COMMENCEZ PAR UN PILOTE DE DESIGN THINKING OU UN APPEL DE CONSEIL.